IA y SEO
Cómo optimizar para la búsqueda con IA (GEO) + plantillas
Publicado · Última actualización
En esta página
Esta guía le muestra cómo preparar un sitio para que los productos de búsqueda con IA puedan encontrarlo, entenderlo y citarlo, con pasos concretos para cada plataforma y una comprobación tras cada paso. Está escrita para propietarios de sitios, profesionales de marketing y desarrolladores que quieren hacer el trabajo por su cuenta. Nadie puede garantizar una cita en ChatGPT, Perplexity, Claude o Google, y Google afirma que optimizar para la búsqueda con IA generativa sigue siendo SEO. Al final encontrará un kit de inicio gratuito con archivos listos para copiar y pegar.
Puntos clave
- Deje entrar a los bots adecuados. Los bots de búsqueda deciden si pueden citarle; los de entrenamiento, no, y su CDN o su cortafuegos pueden anular robots.txt.
- Ponga la respuesta en HTML renderizado en el servidor. Varios rastreadores de IA importantes no ejecutaban JavaScript en la última medición, así que compruébelo con un curl sencillo.
- Escriba secciones que empiecen por la respuesta: un tema por URL, una respuesta directa bajo cada encabezado y datos explícitos.
- Los datos estructurados deben coincidir con el texto visible. Las funciones de IA de Google no requieren ningún esquema especial.
- llms.txt es opcional y Google Search lo ignora. Cuesta poco, así que déjelo para después de lo básico.
- Mida con herramientas propias de cada plataforma (Search Console, Bing Webmaster Tools, GA4) y repita sus pruebas de prompts a lo largo del tiempo.
¿No sabe qué plataforma encaja con su negocio? Lea primero WordPress frente a Shopify.
¿Qué es el GEO?
La optimización para motores generativos (GEO, por sus siglas en inglés) consiste en facilitar que los productos de búsqueda con IA encuentren, entiendan y citen sus páginas. La optimización para motores de respuesta (AEO) es una etiqueta que se solapa con la anterior y designa el mismo trabajo; no existe una definición consensuada de ninguna de las dos, como señala la entrada de Wikipedia. Google lo integra en el SEO, mientras que las Bing Webmaster Guidelines usan el término GEO y afirman que no garantiza el grounding ni las citas.
Cómo encuentran, eligen y citan las fuentes los motores generativos
Todos los motores siguen más o menos el mismo recorrido, aunque los detalles varían según el proveedor.
- Rastrear: Googlebot (también alimenta AI Overviews y AI Mode); Bingbot (Bing, Copilot, API de fundamentación); OAI-SearchBot; Claude-SearchBot; PerplexityBot
- Indexar: Google: indexado y apto para fragmentos; Bing: Copilot comparte rastreo, índice y clasificación; ChatGPT: proveedores de búsqueda de terceros más OAI-SearchBot; Perplexity: búsqueda web en tiempo real
- Ampliar la pregunta: Google: query fan-out; ChatGPT: reformulación de la consulta
- Recuperar y seleccionar pasajes: Google: fundamentación a partir del índice de Search; Copilot: divide las páginas en fragmentos más pequeños; Límites: nosnippet, max-snippet, data-nosnippet, NOARCHIVE y NOCACHE de Bing
- Generar y citar: Google: enlaces a las páginas de apoyo; Perplexity: citas numeradas; ChatGPT: citas; Bing: citas contabilizadas
- Medir: informe de IA generativa de Search Console (solo impresiones); rendimiento de Search Console (clics de IA en Web); rendimiento de IA de Bing; GA4 utm_source=chatgpt.com; registros del servidor
Los bots de entrenamiento son aparte: GPTBot, ClaudeBot, Google-Extended (solo token). Fetchers activados por el usuario: ChatGPT-User, Claude-User, Perplexity-User.
1. Rastreo. Los bots tienen que poder llegar a la página. AI Overviews y AI Mode de Google usan el rastreo normal de Search, el rastreador de Bing alimenta a Copilot, y la búsqueda de ChatGPT se apoya en OAI-SearchBot, la de Claude en Claude-SearchBot y la de Perplexity en PerplexityBot.
2. Indexación. Google afirma que una página debe estar indexada y ser apta para mostrar fragmentos, sin ningún requisito adicional. Bing indica que Copilot comparte la misma base de rastreo, índice y posicionamiento. OpenAI indica que ChatGPT envía consultas reformuladas a proveedores de búsqueda externos además de usar su propio rastreador.
3. Ampliación de la pregunta. La guía de Google describe el query fan-out, en el que se lanzan subconsultas relacionadas. OpenAI indica que ChatGPT reescribe un prompt en una o varias consultas más específicas.
4. Recuperación y selección de pasajes. Google recupera con sus sistemas centrales de posicionamiento. Microsoft indica que Copilot divide las páginas en fragmentos más pequeños, por lo que los datos clave ocultos en pestañas, imágenes o PDF pueden pasarse por alto.
5. Generación y cita. Perplexity añade citas numeradas a sus respuestas. OpenAI indica que no se garantiza aparecer en la búsqueda de ChatGPT.
Después viene la medición, que se explica al final. Si trabaja específicamente en ChatGPT, consulte nuestra guía sobre cómo aparecer en ChatGPT y, para el tema en general, nuestra guía de optimización para motores de respuesta.
Bots de entrenamiento, bots de búsqueda y agentes activados por el usuario
Cada proveedor separa su rastreo según la finalidad. La regla práctica: bloquear un token de entrenamiento no le elimina de la búsqueda con IA de ese proveedor, y bloquear un bot de búsqueda sí.
| Proveedor | Búsqueda y respuestas | Entrenamiento de modelos | Acceso a petición del usuario |
|---|---|---|---|
| OpenAI | OAI-SearchBot | GPTBot | ChatGPT-User |
| Anthropic | Claude-SearchBot | ClaudeBot | Claude-User |
| Perplexity | PerplexityBot | No se usa para entrenamiento | Perplexity-User |
| Googlebot (Search, AI Overviews, AI Mode) | Token Google-Extended (entrenamiento y grounding de Gemini) | Agentes de Google activados por el usuario | |
| Apple | Applebot | Token Applebot-Extended | Ninguno documentado |
| Microsoft | Bingbot (Bing y Copilot) | Sin token aparte; metaetiquetas NOARCHIVE y NOCACHE | Ninguno documentado |
Fuentes: OpenAI, Anthropic, Perplexity, Google, Apple, Bing. Comprobado el 7 de octubre de 2026.
SEO, AEO y GEO
| SEO | AEO | GEO | |
|---|---|---|---|
| Qué se entiende por ello | Ganar visibilidad en los resultados de búsqueda clásicos | Ser la respuesta en fragmentos destacados, por voz y en respuestas con IA | Ser citado dentro de las respuestas generadas |
| Dónde aparece la respuesta | Enlaces ordenados | Cuadros de respuesta y asistentes | AI Overviews, AI Mode, ChatGPT, Copilot, Perplexity, Claude |
| Qué controla usted | Rastreabilidad, contenido, enlaces, experiencia de página | Contenido que empieza por la respuesta y estructura clara | Los mismos factores, más el acceso de los bots y la claridad de la entidad |
| Qué se mide | Impresiones, clics, posiciones | Presencia en fragmentos y respuestas | Citas, impresiones en informes de IA, sesiones de referencia |
| Salvedad | Las posiciones cambian | Las etiquetas se solapan con el SEO | Sin definición consensuada ni citas garantizadas |
Google afirma que optimizar para la búsqueda con IA generativa sigue siendo SEO. Considere las tres etiquetas como ámbitos de trabajo, no como disciplinas distintas.
Seis mitos que conviene descartar antes de empezar
Los fundamentos que necesita toda plataforma
Estos seis pasos se aplican a cualquier tecnología. Las secciones por plataforma que siguen muestran dónde se hace cada uno en WordPress, Shopify, React, Next.js y Astro.
1. Deje entrar a los bots adecuados: robots.txt y su CDN
PasosAbra la puerta a los bots de búsqueda
Decida su política
La plantilla A le hace visible en la búsqueda con IA y, a la vez, excluye el entrenamiento de modelos. La plantilla B da la bienvenida a todos, rastreadores de entrenamiento incluidos, y es la política que maxenius.com usa para obtener la máxima visibilidad.
Escriba el archivo repitiendo las reglas compartidas
Un rastreador obedece únicamente el grupo coincidente más específico, y la especificación de Google indica que los grupos con nombre y el grupo
*no se combinan. Por eso debe repetir cada línea Disallow necesaria dentro de cada grupo con nombre.public/robots.txtPlantilla A: visible en la búsqueda con IA, sin entrenamiento User-agent: * Disallow: /api/ Disallow: /cart/ Allow: / User-agent: OAI-SearchBot User-agent: ChatGPT-User User-agent: Claude-SearchBot User-agent: Claude-User User-agent: PerplexityBot User-agent: Perplexity-User Disallow: /api/ Disallow: /cart/ Allow: / User-agent: GPTBot User-agent: ClaudeBot User-agent: Applebot-Extended User-agent: CCBot Disallow: / Sitemap: https://www.example.com/sitemap.xmlpublic/robots.txtPlantilla B: máxima visibilidad, rastreadores de entrenamiento incluidos User-agent: * Disallow: /api/ Allow: / User-agent: OAI-SearchBot User-agent: ChatGPT-User User-agent: GPTBot User-agent: Claude-SearchBot User-agent: Claude-User User-agent: ClaudeBot User-agent: PerplexityBot User-agent: Perplexity-User User-agent: Google-Extended User-agent: Applebot-Extended Disallow: /api/ Allow: / Sitemap: https://www.example.com/sitemap.xmlMantenga limpia la mecánica
Ponga las líneas Disallow antes de
Allow: /, porque los analizadores sencillos, como robotparser de Python, se detienen en la primera coincidencia. Sirva un archivo por host desde/robots.txt. Según el RFC 9309, una respuesta 5xx hace que los rastreadores asuman que todo está prohibido, y un 404 que pueden rastrearlo todo. robots.txt no es un control de acceso. OpenAI y Perplexity indican que los cambios tardan unas 24 horas en aplicarse.Revise la capa que está por encima de robots.txt
OpenAI indica que su host o CDN debe permitir sus rangos de IP publicados, y Perplexity documenta reglas de WAF que combinan el agente de usuario con listas de IP. Hay dos trampas: desde el 15 de septiembre de 2026, Cloudflare bloquea los rastreadores de finalidad mixta, entre ellos Googlebot, Applebot y BingBot, cuando un cliente activa el bloqueo de entrenamiento, y su robots.txt administrado antepone reglas Disallow que incluyen Google-Extended. En Vercel, poner el conjunto de reglas AI Bots en Deny también bloquea a los bots de búsqueda.
Compruebe que funcionóCompruebe que funciona
Ejecute
curl -s https://yourdomain.com/robots.txty confirme que el archivo publicado coincide con el de su repositorio, ya que una CDN puede reescribirlo. Después busque en los registros del servidor o de la CDN respuestas 200 a OAI-SearchBot, Claude-SearchBot, PerplexityBot y Bingbot. Suplantar un agente de usuario con curl solo prueba las reglas basadas en el agente de usuario, no las basadas en IP.
Abrir a tamaño completo (pestaña nueva)
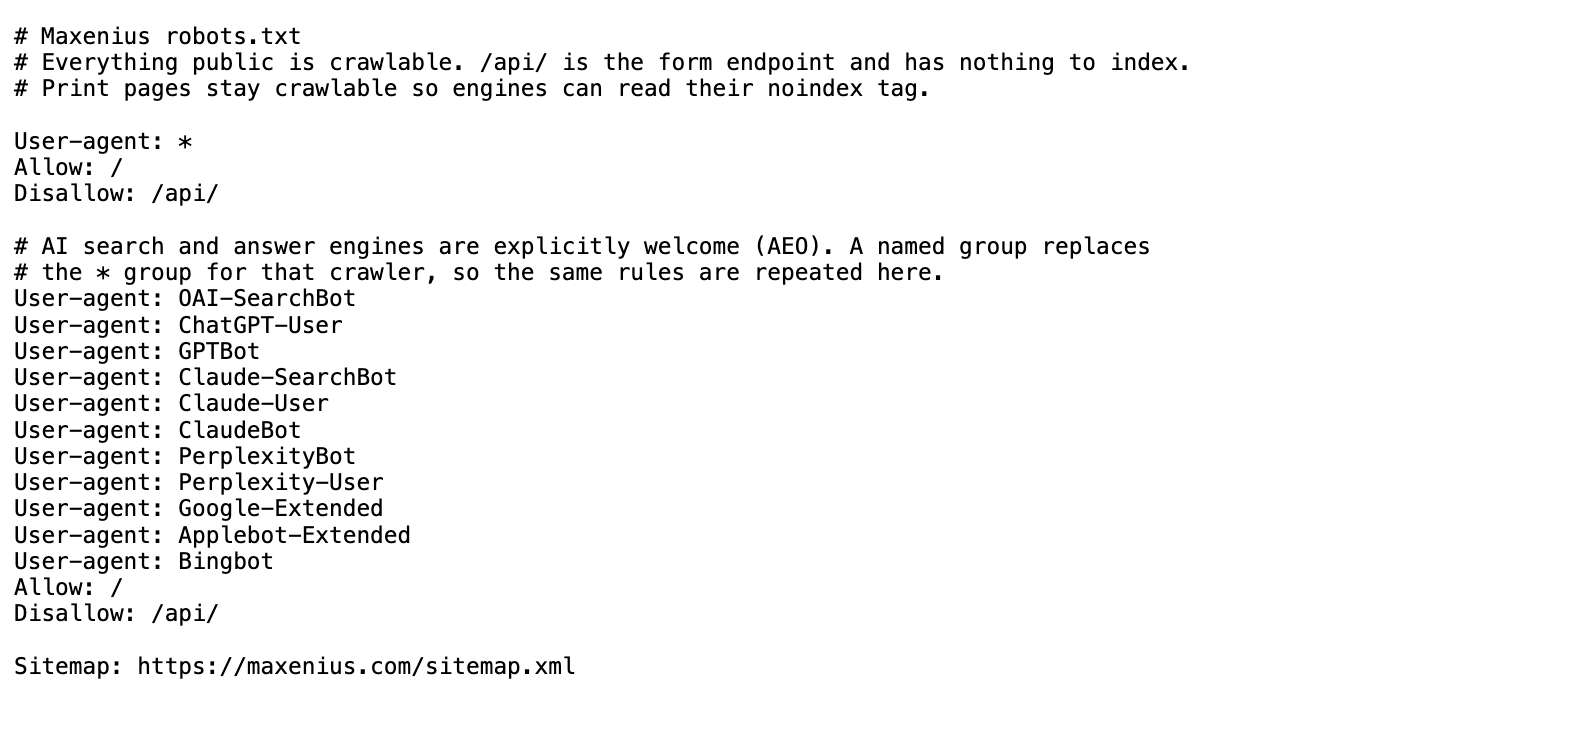
Plantillas A y B de robots.txt
Plantilla A: bots de búsqueda permitidos, bots de entrenamiento bloqueados. La plantilla B, la política de máxima visibilidad, está en la misma carpeta del kit.
Cualquiera
2. Ponga la respuesta en HTML renderizado en el servidor
PasosHaga que la página se pueda leer sin JavaScript
Lea primero los hallazgos con fecha
En diciembre de 2024, Vercel y MERJ concluyeron que ninguno de los principales rastreadores de IA que estudiaron renderizaba JavaScript, salvo Gemini a través de Googlebot y Applebot. La guía de Vercel de 2026, Make your site readable by AI agents, sigue aconsejando renderizar en el servidor el contenido que se quiere que se lea. Son hallazgos con fecha, no una promesa sobre todos los rastreadores. OpenAI no indica si OAI-SearchBot renderiza, así que compruébelo en lugar de darlo por supuesto.
Renderice lo esencial en el servidor
El título, el texto principal, la canonical, el JSON-LD y los enlaces de navegación deberían estar en el HTML inicial. Google indica que no todos los bots ejecutan JavaScript, aunque Googlebot en general sí lo hace.
No oculte las respuestas
Mantenga las respuestas clave fuera de pestañas cerradas, imágenes y PDF. Tanto Microsoft como Bing advierten contra ocultar contenido esencial tras el renderizado en el cliente.
Compruebe que funcionóCompruebe que funciona
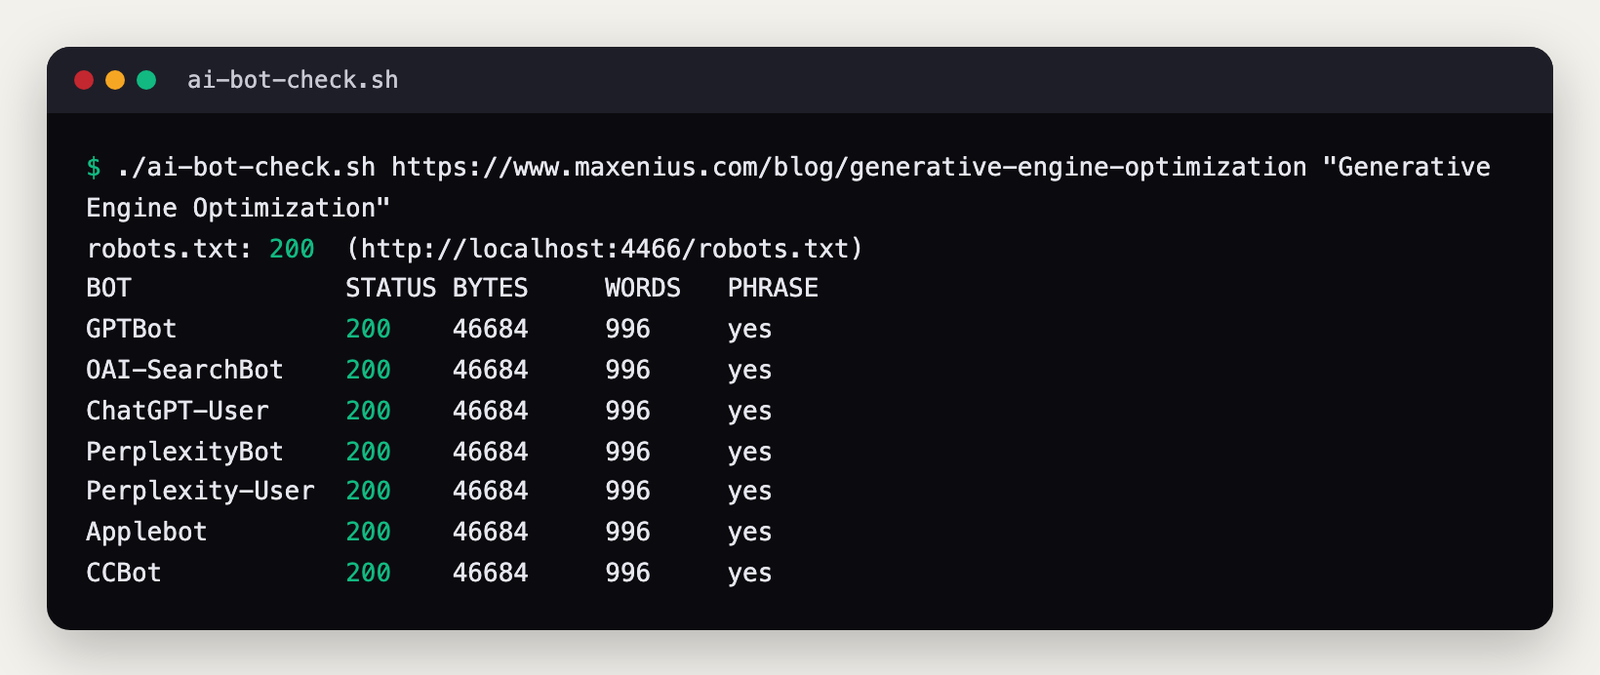
Descargue la página como lo hace un rastreador que no renderiza, por ejemplo con el script del kit:
./ai-bot-check.sh https://www.example.com/page "a sentence from the body". Cada fila de bot debe mostrar el estado 200, un recuento de palabras cercano al que ve en el navegador y PHRASE = yes. El kit incluye dos scripts:ai-bot-check.shprueba siete agentes de usuario de bots, ycheck-ai-crawl.sh(que se muestra en la sección de frameworks) comprueba en una sola descarga el título, la canonical y el JSON-LD.
Abrir a tamaño completo (pestaña nueva)
3. Escriba secciones que empiecen por la respuesta
PasosHaga que cada sección se pueda extraer por separado
Empiece por la respuesta
Ponga la respuesta directa en las primeras frases bajo cada encabezado y haga que los encabezados sean específicos. Las pautas de Bing aconsejan mostrar pronto la información clave y definir los datos de forma explícita en la URL.
Un tema por URL, sin páginas a escala
No cree una página para cada variación de query fan-out de una consulta. Google lo considera abuso de contenido a escala. Añada en su lugar detalle propio, de primera mano y no genérico, en vez de repetir lo que dicen otros.
Sin texto oculto para los modelos
Bing considera abuso la inyección de prompts y las instrucciones ocultas para LLM, y puede reducir la visibilidad del sitio o eliminarlo del índice. Google afirma que no hay una longitud ideal ni hace falta trocear el contenido, así que escriba para las personas.
Compruebe que funcionóCompruebe que funciona
Lea cada sección H2 por separado. Si responde a su propio encabezado sin necesitar el párrafo anterior, la sección supera la prueba.
4. Datos estructurados que coinciden con la página
PasosAñada un marcado que diga la verdad
Compruebe el requisito
Google afirma que las funciones de IA no necesitan ningún esquema especial y que el marcado debe coincidir con el texto visible. Aun así, use Article o BlogPosting, Organization, Product y BreadcrumbList donde correspondan.
Use JSON-LD, escápelo e indique las fechas
El JSON-LD puede ir en el head o en el body, y Google lee el JSON-LD inyectado, pero los rastreadores que no ejecutan JavaScript no. Cuando serialice JSON dentro de una etiqueta script, sustituya cada
<por\u003c(una barra invertida seguida de u003c) para que una cadena que contenga una etiqueta de cierre de script no pueda terminar el bloque antes de tiempo. Los ejemplos de React, Next.js y Astro que siguen lo hacen. Muestre una fecha visible y haga quedatePublishedydateModifiedcoincidan con ella, según la guía de Google sobre la firma de autoría.Considere opcional el esquema FAQ
Google puso fin al resultado enriquecido de preguntas frecuentes el 7 de mayo de 2026. Mantenga el marcado FAQ solo si refleja preguntas visibles, y no espere más espacio en los resultados de búsqueda.
Compruebe que funcionóCompruebe que funciona
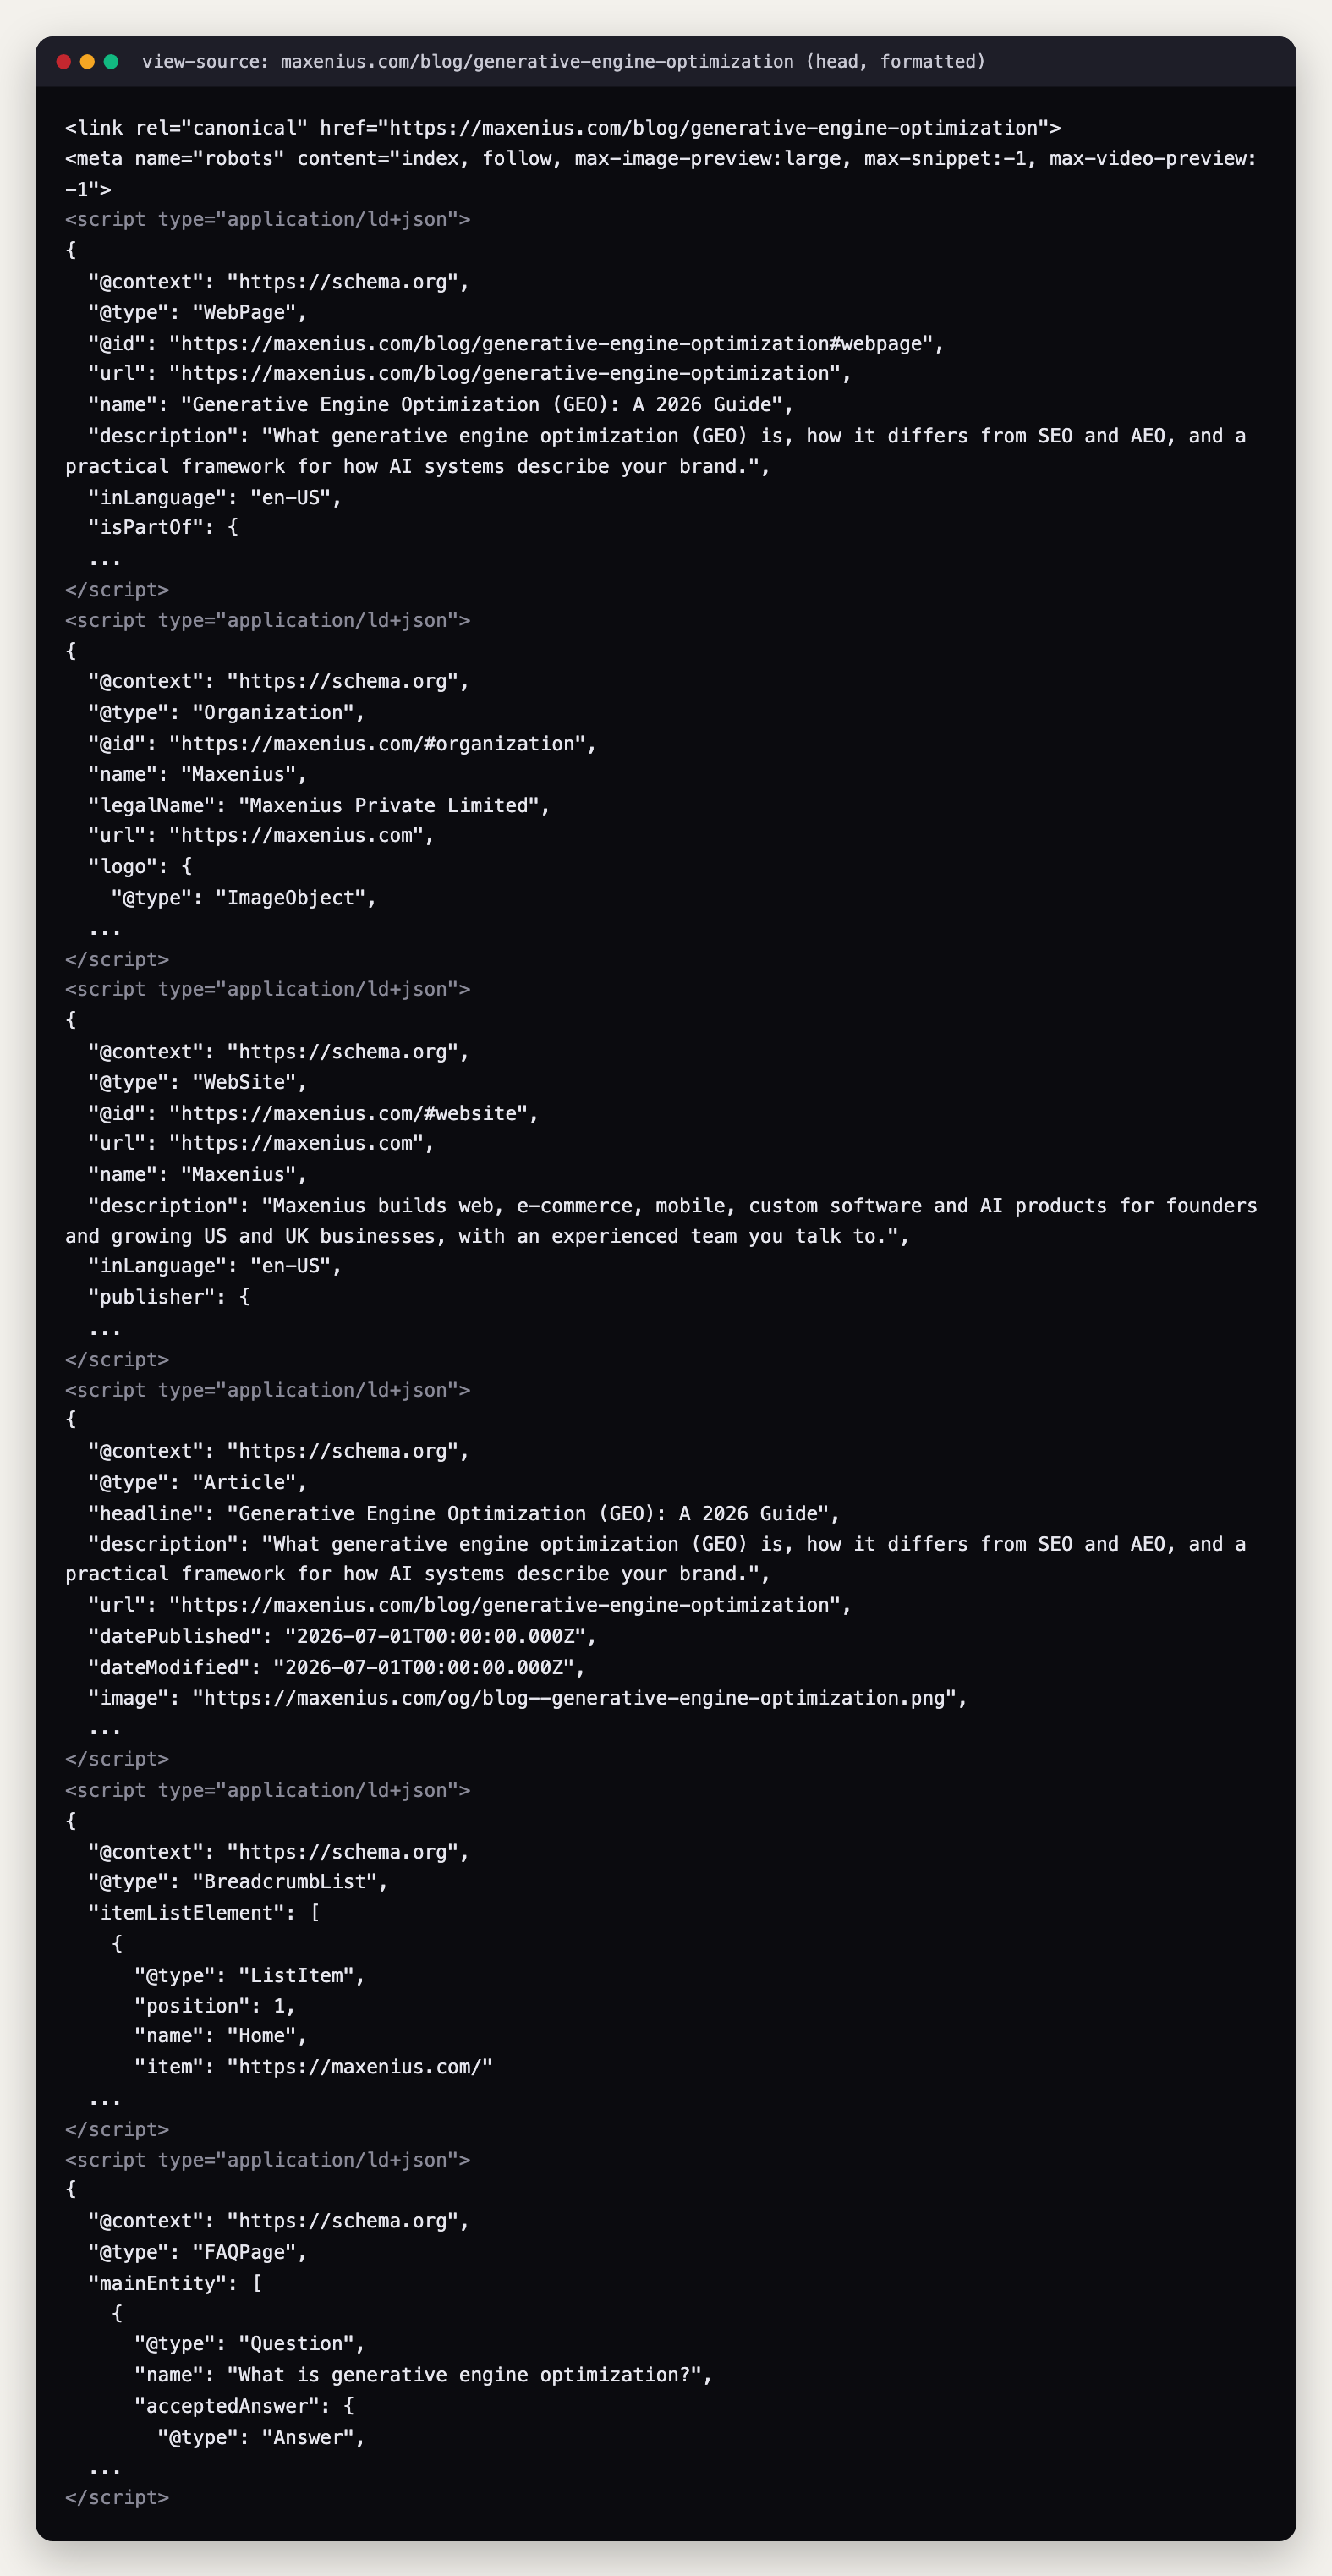
Vea el código fuente y confirme que el JSON-LD está en el HTML sin procesar. Ejecute la Prueba de resultados enriquecidos o el Schema Markup Validator y compare cada valor con lo que ve un visitante.
Abrir a tamaño completo (pestaña nueva)
5. ¿Qué es llms.txt y necesita uno?
llms.txt es una propuesta opcional de la comunidad: un archivo Markdown en /llms.txt que enumera sus páginas clave para las herramientas de IA. Google afirma que Search no lo usa, de modo que puede prescindir de él sin perder nada.
PasosDecida si publica llms.txt
Sepa qué es llms.txt
llms.txt es un archivo Markdown en la raíz de su sitio, propuesto por Jeremy Howard el 3 de septiembre de 2024, con un formato v2 publicado en agosto de 2026. Tiene un H1 (la única parte obligatoria), un resumen opcional en forma de cita en bloque y secciones H2 con enlaces del tipo
- [name](url): notes.Qué hace hoy
Google afirma que Search ni se perjudica ni se beneficia de él. Ninguno de los documentos de rastreadores de OpenAI, Anthropic, Perplexity, Bing, Apple o Meta que revisamos indica que su rastreador lo lea. Lighthouse de Chrome tiene una auditoría Agentic Browsing que se marca como Not Applicable cuando falta el archivo. La guía de Vercel de 2026 informa de que añadir llms.txt no cambió la recuperación cuando la respuesta ya estaba en el HTML del servidor, y de que el 86 por ciento de las descargas atribuidas llegaron a través de enlaces de la página.
Decida si lo publica
Es opcional y barato, así que hágalo después de lo básico. Mantenga el archivo pequeño.
llms-full.txtes una convención que generan algunas plataformas de documentación, no forma parte de la especificación, y los reales llegan a ocupar decenas de megabytes. El/llms.txtpredeterminado de Shopify sirve instrucciones para agentes, como se explica en la sección de Shopify.public/llms.txtDatos de ejemplo, formato v2 # Example Co > Example Co makes refillable cleaning products and sells them online to customers in the US and Canada. Key facts: - Free shipping on US orders over $50; returns accepted within 30 days. - Support: support@example.com, Monday to Friday. ## Products - [All products](https://www.example.com/collections/all): Full catalog with prices and stock status - [Refill subscriptions](https://www.example.com/pages/subscriptions): How refills are billed, paused and cancelled ## Policies - [Shipping policy](https://www.example.com/policies/shipping-policy): Carriers, delivery times and costs - [Refund policy](https://www.example.com/policies/refund-policy): Return window and how refunds are paidCompruebe que funcionóCompruebe que funciona
Ejecute
curl -sI https://yourdomain.com/llms.txty espere un 200 con un tipo de contenido de texto. Después pegue solo el archivo en un asistente y hágale preguntas sobre su negocio.
Abrir a tamaño completo (pestaña nueva)
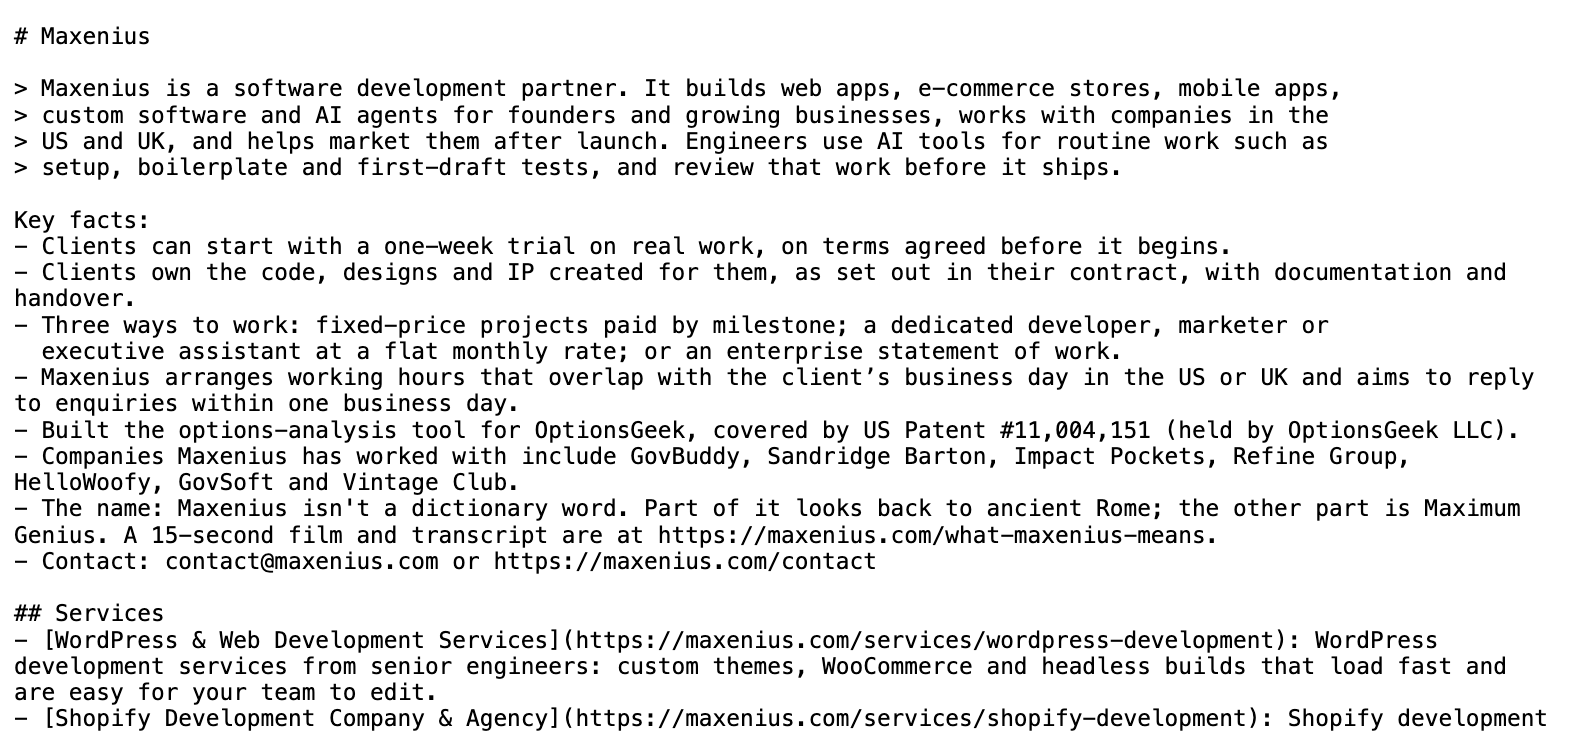
Plantilla inicial de llms.txt
El ejemplo anterior como descarga, con datos de ejemplo que debe sustituir.
Cualquiera
6. Mantenga coherentes su entidad y sus URL
PasosDiga quién es una sola vez, en una sola dirección
Publique el marcado Organization
Añada JSON-LD de Organization en la página de inicio con name, url, logo, description y enlaces
sameAsa sus perfiles reales, según el documento de Google sobre Organization. Use el mismo nombre en todas partes, como piden las pautas de Bing, y mantenga alineados los datos de Business Profile, Bing Places y Merchant Center.Elija un único host
Su etiqueta canonical, los valores
locdel mapa del sitio y el destino de las redirecciones deben coincidir. Google considera las redirecciones y rel=canonical señales fuertes y el mapa del sitio una señal débil, y desaconseja declarar URL distintas con métodos distintos. Bing señala que los LLM agrupan casi duplicados y pueden elegir una URL obsoleta para representarlos.Fije lastmod a partir de cambios reales
Cambie
lastmodsolo cuando cambien el contenido principal, los datos estructurados o los enlaces, nunca por la hora de compilación. Google ignorapriorityychangefreq, y Bing dice lo mismo. Acompáñelo de una fecha visible y dedateModified.Notifique a IndexNow para Bing
IndexNow avisa de los cambios a Bing y a otros motores participantes. Google no participa. Un HTTP 200 significa que se recibió su URL, no que se indexó.
Compruebe que funcionóCompruebe que funciona
Ejecute
curl -sI https://example.com/page | grep -i -E '^HTTP/|^location'para cada variante de host y compare después el destino de la redirección con la canonical de la página y con su entrada en el mapa del sitio. Las tres deben ser la misma URL.
Organization JSON-LD
Plantilla de marcado de entidad con valores de ejemplo y enlaces sameAs.
Cualquiera
Cómo optimizar WordPress para la búsqueda con IA (y añadir llms.txt): paso a paso
Esta sección funciona en un sitio WordPress estándar, con o sin plugin de SEO. Cada paso termina con una comprobación de una línea, y el último paso ejecuta cuatro comandos de terminal que confirman toda la configuración.
Encuentre los ajustes de su plugin de SEO
La mayoría de las decisiones siguientes dependen de esta tabla. Localice primero su columna y siga después los pasos.
| Yoast SEO | Rank Math | AIOSEO | |
|---|---|---|---|
| llms.txt | Gratis desde la 25.3 (10 de junio de 2025). Yoast SEO > Settings > Site features > AI tools > LLMS.txt. Escribe un archivo físico, actualizado cada semana. Yoast ha indicado que no está disponible en multisitio (incidencia en GitHub). | Desde la 1.0.250 (31 de julio de 2025). Active el módulo en Rank Math SEO > Dashboard y después en Rank Math SEO > General Settings > Edit llms.txt. Está vacío hasta que lo configure. | Integrado; consulte el registro de cambios de AIOSEO. Incluye llms-full.txt y versiones Markdown de las entradas. All in One SEO > Sitemaps > pestaña LLMs.txt. Activado por defecto, escrito como archivo estático. |
| Editor de robots.txt | Yoast SEO > Tools > File editor > Create robots.txt file. Esto crea un archivo físico. | Rank Math SEO > General Settings > Edit robots.txt. Archivo virtual; según la base de conocimiento de Rank Math, un archivo físico en la raíz impide la edición. | All in One SEO > Tools > Robots.txt Editor > Enable Custom Robots.txt. Incluye una opción Block AI Crawlers. |
| URL del mapa del sitio | /sitemap_index.xml (sustituye al /wp-sitemap.xml del núcleo) | /sitemap_index.xml | Mapa del sitio virtual, gestionado en All in One SEO > Sitemaps |
| IndexNow | Solo en la versión premium | Módulo Instant Indexing | Integrado |
El núcleo de WordPress sirve /wp-sitemap.xml por sí mismo. Sin plugin de SEO, el plugin oficial de IndexNow cubre IndexNow.
PasosConfigure WordPress para la búsqueda con IA
Asegúrese de que el contenido está en el HTML
Abra una página clave, elija View Source (no Inspect) y busque una frase del cuerpo. O ejecute
curl -s https://example.com/page/ | grep -i "a sentence from the page". Los temas y los constructores de páginas habituales renderizan en el servidor, pero el contenido de pestañas AJAX, carruseles y widgets de «cargar más» puede no estar ahí.Asegúrese de que la navegación usa enlaces
<a href>reales, porque Google solo puede rastrear enlaces construidos así. Después abra Settings > Reading y confirme que «Search engine visibility» no está marcada. Cuando está activada, la versión actual de WordPress añade una metaetiqueta robots con noindex a todas las páginas, en lugar de un Disallow en robots.txt.Comprobación: su frase aparece en la salida de curl, y
curl -s https://example.com/ | grep -i noindexno devuelve nada.Tome el control de robots.txt
Sin archivo físico, WordPress genera un robots.txt virtual y lo pasa por el filtro
robots_txt. Un robots.txt físico en la raíz web anula ese filtro y todos los editores de plugins de la tabla, y el File editor de Yoast crea precisamente un archivo así. Averigüe en cuál de las dos situaciones está antes de editar nada.Si quiere un grupo de IA explícito, use el mu-plugin geo-robots.php que figura más abajo. Repite las reglas de administración dentro del grupo, porque, según el RFC 9309, un rastreador que encuentra un grupo que lo nombra obedece únicamente a ese grupo.
Deje desactivados Block AI Crawlers de AIOSEO y Bot blocker de Yoast Premium si quiere visibilidad en la búsqueda con IA. Si el sitio está detrás de Cloudflare, revise su robots.txt administrado, que añade reglas Disallow por encima de su archivo.
Comprobación:
curl -s https://example.com/robots.txtmuestra las reglas que espera. OpenAI indica que los cambios pueden tardar unas 24 horas en llegar a la búsqueda de ChatGPT.Decida qué bots permitir
Los bots de búsqueda y de citas son OAI-SearchBot, Claude-SearchBot y PerplexityBot. Los bots de entrenamiento, como GPTBot y ClaudeBot, son una decisión aparte, y bloquearlos no le elimina de la búsqueda de ese proveedor. La tabla completa de proveedores está en la sección de fundamentos.
Comprobación: ninguno de los bots que quiere en la búsqueda aparece nombrado en un grupo Disallow.
Publique llms.txt desde una sola fuente
Elija la función del plugin que figura en la tabla, o use geo-llms-txt.php si no tiene plugin. No ejecute nunca dos. Yoast no sobrescribe un archivo existente, y un archivo estático puede ocultar uno dinámico de otro plugin.
El beneficio es incierto, como se explica en la sección de llms.txt. La propia documentación de Rank Math indica que su adopción es limitada. Cuesta poco, así que trátelo como un índice ordenado de sus mejores páginas.
Comprobación:
curl -sI https://example.com/llms.txtdevuelve 200, y el cuerpo empieza por# Your site name.Añada datos estructurados mediante su plugin
No pegue un segundo bloque Organization. Yoast genera un único @graph enlazado y expone filtros como
wpseo_schema_organization(Schema API). Defina primero el nombre, el logotipo y los perfiles en Yoast SEO > Settings > Site representation. Rank Math permite ampliar el publicador medianterank_math/json_ld. Sin plugin, use geo-schema.php.Comprobación:
curl -s https://example.com/ | grep -c 'application/ld+json'; después pegue cada bloque en validator.schema.org y confirme que hay un solo nodo Organization.Complete los datos del autor y de la entidad
Complete Users > Profile (nombre público, información biográfica, sitio web), porque los plugins de SEO leen de ahí los datos del autor. Según la guía de Google sobre Article,
author.namecontiene solo el nombre yauthor.urlapunta a una página que identifica de forma única al autor. Para la empresa, el marcado Organization va en la página de inicio o en la página Acerca de, y recomienda name, url, logo, sameAs y datos de contacto.Comprobación: la firma de una entrada enlaza con una página de autor, y el código fuente de la página muestra el mismo nombre en el JSON-LD de Article.
Enlace internamente con textos de ancla descriptivos
Desde cada página principal (servicios, categoría, guía) enlace a las páginas de detalle con un texto de ancla que describa el destino. «Nuestra lista de verificación para configurar WooCommerce» dice más a un rastreador que «leer más».
Comprobación: cada página importante tiene al menos un enlace de texto que apunta a ella desde otra página.
Use un único generador de mapa del sitio
Use el del núcleo, Yoast, Rank Math o AIOSEO, no varios. Envíe la URL en Google Search Console y en Bing Webmaster Tools. Bing pide valores lastmod exactos en ISO 8601 con fecha y hora.
Comprobación: se carga la URL del mapa del sitio de la tabla, y lastmod cambia solo cuando edita realmente una página.
Active IndexNow con un único emisor
Elija el plugin oficial de IndexNow, Instant Indexing de Rank Math, AIOSEO o Yoast Premium. Usar dos duplica los envíos. IndexNow comparte las URL enviadas con todos los motores participantes.
Comprobación: publique una entrada de prueba y búsquela en la lista de envíos recientes del plugin.
Complete los datos de producto de WooCommerce
En cada producto, rellene Product data > Inventory > SKU y el campo «GTIN, UPC, EAN, or ISBN», y escriba una descripción corta real. WooCommerce 11.1.2 genera JSON-LD de Product con sku, gtin, offers y valoraciones, y permite ampliarlo con
woocommerce_structured_data_product. El archivo de filtros que figura más abajo añade una marca. Si un plugin de SEO también genera Product, compare los dos bloques.WooCommerce trunk tiene previsto para una versión posterior (marcada como 11.3.0) el marcado OnlineStore y MerchantReturnPolicy, por lo que no está en la 11.1.2.
Comprobación: vea el código fuente de una página de producto y confirme que hay exactamente un nodo Product con su GTIN.
Compruebe que funcionóVerifique todo desde un terminal
Sustituya el dominio y la frase, y ejecute los cuatro:
curl -s https://example.com/robots.txtmuestra los grupos que usted quería y una línea Sitemap.curl -sI https://example.com/llms.txtdevuelve 200 y text/plain.curl -s https://example.com/ | grep -c 'application/ld+json'devuelve el número de bloques que espera.curl -s https://example.com/some-page/ | grep -i "a sentence from the body"encuentra su texto.
Código que puede incorporar directamente
Coloque estos archivos en wp-content/mu-plugins/. WordPress carga automáticamente los archivos PHP del nivel superior de esa carpeta. Cada archivo está también en el kit de inicio.
<?php
/**
* Plugin Name: GEO robots.txt rules
* Description: Adds an explicit group for AI search crawlers to the virtual robots.txt.
*/
defined( 'ABSPATH' ) || exit;

add_filter(
'robots_txt',
function ( $output, $is_public ) {
	if ( ! $is_public ) {
		return $output;
	}
	$admin_path = wp_parse_url( admin_url(), PHP_URL_PATH );
	$ajax_path  = wp_parse_url( admin_url( 'admin-ajax.php' ), PHP_URL_PATH );
	// A crawler that finds a group naming it obeys only that group (RFC 9309).
	$bots  = array( 'OAI-SearchBot', 'ChatGPT-User', 'Claude-SearchBot', 'Claude-User', 'PerplexityBot', 'Perplexity-User' );
	$group = "\n# AI search and answer crawlers\n";
	foreach ( $bots as $bot ) {
		$group .= 'User-agent: ' . $bot . "\n";
	}
	$group .= 'Disallow: ' . $admin_path . "\n";
	$group .= 'Allow: ' . $ajax_path . "\n";
	return $output . $group;
},
99,
2
);
Resultado, añadido después del valor predeterminado del núcleo:
# AI search and answer crawlers
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Perplexity-User
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php<?php
/**
* Plugin Name: GEO llms.txt
* Description: Serves /llms.txt (llmstxt.org format) without an SEO plugin.
* A physical llms.txt in the web root wins over this code.
*/
defined( 'ABSPATH' ) || exit;
const GEO_LLMS_REWRITE_VERSION = '1';
add_action( 'init', function () {
add_rewrite_rule( '^llms\.txt$', 'index.php?geo_llms_txt=1', 'top' );
// mu-plugins have no activation hook, so flush once per rule version.
if ( get_option( 'geo_llms_rewrite_version' ) !== GEO_LLMS_REWRITE_VERSION ) {
flush_rewrite_rules( false );
update_option( 'geo_llms_rewrite_version', GEO_LLMS_REWRITE_VERSION );
}
} );
add_filter( 'query_vars', function ( $vars ) {
$vars[] = 'geo_llms_txt';
return $vars;
} );
// Priority 0 runs before redirect_canonical (priority 10).
add_action( 'template_redirect', function () {
if ( ! get_query_var( 'geo_llms_txt' ) ) {
return;
}
$body = get_transient( 'geo_llms_txt_body' );
if ( false === $body ) {
$body = geo_llms_build();
set_transient( 'geo_llms_txt_body', $body, 12 * HOUR_IN_SECONDS );
}
status_header( 200 );
header( 'Content-Type: text/plain; charset=utf-8' );
echo $body; // phpcs:ignore WordPress.Security.EscapeOutput.OutputNotEscaped
exit;
}, 0 );
add_action( 'save_post', function () {
delete_transient( 'geo_llms_txt_body' );
} );
function geo_llms_build() {
$clean = function ( $text ) {
$text = wp_strip_all_tags( html_entity_decode( (string) $text, ENT_QUOTES, 'UTF-8' ) );
return trim( preg_replace( '/\s+/', ' ', $text ) );
};
$lines = array( '# ' . $clean( get_bloginfo( 'name' ) ), '' );
$tagline = $clean( get_bloginfo( 'description' ) );
if ( '' !== $tagline ) {
$lines[] = '> ' . $tagline;
$lines[] = '';
}
$sections = array(
'Pages' => array( 'post_type' => 'page', 'orderby' => 'menu_order title', 'order' => 'ASC' ),
'Articles' => array( 'post_type' => 'post', 'orderby' => 'modified', 'order' => 'DESC' ),
);
if ( post_type_exists( 'product' ) ) {
$sections['Products'] = array( 'post_type' => 'product', 'orderby' => 'modified', 'order' => 'DESC' );
}
foreach ( $sections as $heading => $args ) {
$posts = get_posts( array_merge( $args, array(
'post_status' => 'publish', 'posts_per_page' => 50, 'has_password' => false, 'suppress_filters' => false,
) ) );
if ( ! $posts ) {
continue;
}
$lines[] = '## ' . $heading;
$lines[] = '';
foreach ( $posts as $post ) {
$summary = $clean( has_excerpt( $post ) ? get_the_excerpt( $post ) : wp_trim_words( strip_shortcodes( $post->post_content ), 30, '' ) );
$title = str_replace( array( '[', ']' ), array( '(', ')' ), $clean( get_the_title( $post ) ) );
$line = sprintf( '- [%s](%s)', $title, esc_url_raw( get_permalink( $post ) ) );
if ( '' !== $summary ) {
$line .= ': ' . $summary;
}
$lines[] = $line;
}
$lines[] = '';
}
return implode( "\n", $lines );
}Esta versión no tiene en cuenta los indicadores noindex por entrada de los plugins de SEO, que es otra razón para usarla solo en sitios que no tengan uno.
<?php
defined( 'ABSPATH' ) || exit;

function geo_print_jsonld( array $data ) {
echo '<script type="application/ld+json">'
	. wp_json_encode( $data, JSON_UNESCAPED_SLASHES | JSON_UNESCAPED_UNICODE | JSON_HEX_TAG )
	. "</script>\n";
}

// Organization on the front page (edit the values).
add_action( 'wp_head', function () {
if ( ! is_front_page() ) {
	return;
}
geo_print_jsonld( array(
	'@context'     => 'https://schema.org',
	'@type'        => 'Organization',
	'@id'          => home_url( '/#organization' ),
	'name'         => get_bloginfo( 'name' ),
	'url'          => home_url( '/' ),
	'logo'         => get_site_icon_url( 512 ),
	'description'  => get_bloginfo( 'description' ),
	'sameAs'       => array( 'https://www.linkedin.com/company/your-company' ),
	'contactPoint' => array( '@type' => 'ContactPoint', 'contactType' => 'sales', 'email' => 'hello@example.com' ),
) );
} );

// FAQPage from a "geo_faqs" custom field: [{"q":"...","a":"..."}]. Mark up only visible FAQs.
add_action( 'wp_head', function () {
if ( ! is_singular() ) {
	return;
}
$faqs = json_decode( (string) get_post_meta( get_queried_object_id(), 'geo_faqs', true ), true );
if ( ! is_array( $faqs ) || ! $faqs ) {
	return;
}
$entities = array();
foreach ( $faqs as $faq ) {
	if ( empty( $faq['q'] ) || empty( $faq['a'] ) ) {
		continue;
	}
	$entities[] = array(
		'@type'          => 'Question',
		'name'           => wp_strip_all_tags( $faq['q'] ),
		'acceptedAnswer' => array( '@type' => 'Answer', 'text' => wp_kses_post( $faq['a'] ) ),
	);
}
if ( $entities ) {
	geo_print_jsonld( array( '@context' => 'https://schema.org', '@type' => 'FAQPage', 'url' => get_permalink(), 'mainEntity' => $entities ) );
}
} );<?php
defined( 'ABSPATH' ) || exit;
// Yoast SEO: extend the Organization piece from Settings > Site representation.
add_filter( 'wpseo_schema_organization', function ( $data ) {
$data['description'] = 'One plain sentence on what the company does and for whom.';
$data['email'] = 'hello@example.com';
return $data;
} );
// Rank Math: the publisher entity lives at $data['publisher'].
add_filter( 'rank_math/json_ld', function ( $data, $jsonld ) {
if ( isset( $data['publisher'] ) && is_array( $data['publisher'] ) ) {
$data['publisher']['description'] = 'One plain sentence on what the company does and for whom.';
}
return $data;
}, 99, 2 );
// WooCommerce core Product markup: add a brand.
add_filter( 'woocommerce_structured_data_product', function ( $markup, $product ) {
$markup['brand'] = array( '@type' => 'Brand', 'name' => get_bloginfo( 'name' ) );
return $markup;
}, 10, 2 );geo-robots.php
Grupo de rastreadores de IA para el robots.txt virtual.
WordPress
geo-llms-txt.php
llms.txt sin plugin de SEO.
WordPressWooCommerce
geo-schema.php
JSON-LD de Organization y FAQ sin plugin de SEO.
WordPress
geo-schema-plugin-filters.php
Filtros para Yoast, Rank Math y WooCommerce.
WordPressWooCommerce
Si necesita ayuda práctica, consulte a nuestro equipo de desarrollo en WordPress.
Cómo optimizar Shopify para la búsqueda con IA y ChatGPT: paso a paso
Shopify ya hace la mayor parte del trabajo técnico. A fecha de 7 de octubre de 2026, todas las tiendas incluyen un sitemap.xml automático que no se puede editar, un robots.txt predeterminado y JSON-LD generado por el filtro structured_data en los temas Dawn y Horizon. Desde el 28 de mayo de 2026, todas las tiendas sirven también archivos predeterminados /agents.md, /llms.txt y /llms-full.txt, según el registro de cambios de Shopify.
Un límite: nada de lo que aquí se explica garantiza que ChatGPT, Copilot o Gemini muestren sus productos. Shopify indica que optimizar los datos de producto aumenta las probabilidades, no que lo asegure.
PasosConfigure una tienda Shopify para la búsqueda con IA
Compruebe qué sirve ya su tienda
Abra estas cuatro URL en su tienda y anote lo que ve:
/robots.txt,/llms.txt,/agents.mdy/sitemap.xml.No espere que su robots.txt coincida con el de otra tienda. El 7 de octubre de 2026 vimos tiendas más nuevas que servían un valor predeterminado cuyos comentarios remiten a los agentes a
/agents.md, y otras que seguían sirviendo el valor predeterminado anterior, con grupos adicionales para herramientas como Nutch, AhrefsBot y Pinterest. Ambos dejan a los rastreadores de IA bajo*.El
/llms.txtpredeterminado es un conjunto de instrucciones para agentes (descubrimiento UCP, un endpoint MCP, endpoints JSON de solo lectura, enlaces a políticas). No es un índice seleccionado de su contenido. Después pase una URL de producto por la Prueba de resultados enriquecidos de Google.Revise Agentic storefronts
En el panel de administración, vaya a Sales channels > Agentic. Según la ayuda de Shopify, está activado por defecto en las tiendas aptas y requiere aceptar las Agentic Storefronts Supplemental Terms. Shopify enumera actualmente ChatGPT, Microsoft Copilot, Google AI Mode y Gemini, y Meta.
Qué necesita cada canal:
- ChatGPT: es un referente de descubrimiento. Los compradores completan el pago en su propia tienda. Su tienda debe vender a clientes de Estados Unidos, aunque pueda tener su sede en otro lugar.
- Copilot y Google: ambos ofrecen un pago con tecnología de Shopify dentro del chat para las tiendas aptas de Estados Unidos, y ambos exigen que las políticas de su tienda estén completas. Google necesita además una cuenta de Merchant Center, con los productos sincronizados mediante el canal de Google y YouTube.
- Shopify Catalog: según la página de requisitos, hace falta el plan Starter o superior y una tienda que no esté en modo privado. Cada producto necesita un título, al menos una imagen, un precio superior a cero y su publicación en un canal con URL. Los productos no listados o ocultos en la búsqueda no cumplen los requisitos.
Use la vista previa de búsqueda de esa pantalla. Valora cada ficha según lo completa que sea la descripción, la cobertura de imágenes, las reseñas, los datos de variantes y las políticas. Desactivar el acceso de ChatGPT Catalog puede tardar hasta 7 días en surtir efecto.
Corrija los datos de producto
Aquí está la mayor parte de la mejora. La página de Shopify Optimizing products for AI platforms abarca título, descripción, imágenes, tipo, proveedor, colecciones, etiquetas, código de barras, nombres de las opciones de variante y políticas. Los puntos 1, 3, 4 y 9 son recomendaciones nuestras, con fuentes cuando las tenemos:
- Título: específico, con el tipo de producto, el atributo principal y la marca. Mantenga el título SEO cerca de los 60 caracteres.
- Descripción: responda a lo que preguntan los compradores (materiales, dimensiones, a quién va dirigido, cuidados).
- Imágenes: varias, cada una con un texto alternativo descriptivo.
- Categoría: defínala en Products > (su producto) > Category a partir de la Standard Product Taxonomy y rellene después los metacampos de la categoría.
- Tipo, proveedor, colecciones y etiquetas: rellene los cuatro.
- Código de barras: ISBN, UPC o GTIN en cada variante que lo tenga.
- Nombres de las opciones de variante: «Talla» y «Color», no «Opción 1».
- Políticas: reembolso, privacidad, condiciones y envío, completas.
- Reseñas: la vista previa de búsqueda las tiene en cuenta. El ejemplo de
structured_dataen shopify.dev no muestraaggregateRating, así que compruebe el JSON-LD generado por su aplicación de reseñas. - Aplicación Knowledge Base (opcional): usted revisa los datos de la tienda generados automáticamente y redacta respuestas de preguntas frecuentes para las plataformas de IA. Shopify indica que esas respuestas no aparecen en su tienda en línea y que la aplicación no cambia la frecuencia con la que aparece en los resultados de IA.
Personalice llms.txt con una plantilla del tema (opcional)
Vaya a Online Store > Themes > … > Edit code y añada una plantilla en la carpeta
templates. Según la documentación de agents.md.liquid,agents.md.liquidcubre las tres URL, mientras quellms.txt.liquidcubre solo esa. Shopify busca primero la plantilla específica de la ruta, despuésagents.md.liquidy por último su propio valor predeterminado.En estas plantillas solo existen los objetos
requestyagents. No se pueden recorrer colecciones ni artículos, así que escriba los enlaces a mano y manténgalos al día. Mantenga dinámicas las líneas UCP y MCP medianteagents.*en lugar de escribirlas fijas, y no incluya nunca datos privados como correos electrónicos o teléfonos.Las redirecciones, los archivos subidos (Files) y los proxies de aplicación no sirven para este archivo. Las redirecciones de URL solo se activan en URL rotas, y
/llms.txtahora devuelve 200. Los archivos subidos no se sirven desde la raíz. Los proxies de aplicación solo funcionan bajo/a,/apps,/communityy/tools. La plantilla es la vía admitida.Trate este archivo como una cortesía para los agentes, no como una palanca de posicionamiento, ya que Google Search no usa llms.txt.
Toque robots.txt.liquid solo si tiene que cambiar el acceso
Vaya a Online Store > Themes > … > Edit code > Add a new template > robots > Create template. Shopify lo considera no admitido, el soporte no puede ayudar con ello y advierte de que un error puede costarle todo el tráfico. Copie antes en otro lugar su
/robots.txtactual. Al eliminar la plantilla se restablece el valor predeterminado.Conserve el bucle predeterminado de Shopify y añada a su alrededor grupos de texto plano. El motivo habitual es excluir el entrenamiento de modelos, por ejemplo de GPTBot. OpenAI documenta que GPTBot y OAI-SearchBot son independientes, así que bloquear GPTBot no le elimina de la búsqueda de ChatGPT.
No añada grupos
Allowpara dar la bienvenida a los bots de IA. Consulte el primer error habitual más abajo.Deje el marcado Product al tema y enriquezca el resto
Dawn 16.0.0 y Horizon ya generan
{{ product | structured_data }}y{{ article | structured_data }}. No añada un segundo bloque Product escrito a mano. Dos entidades para un mismo producto entran en conflicto.Para reforzar los datos de su Organization, complete los enlaces sociales en Theme settings > Social media y suba un logotipo. En el encabezado de Dawn, alimentan
sameAs, y los ajustes vacíos se generan como cadenas vacías. Para una página de preguntas frecuentes visible, añada la secciónfaq-schema.liquidque figura más abajo, con el filtro| json, y solo para las preguntas que estén en la página.Publique contenido que responda a las preguntas de los compradores
Escriba guías de compra y comparativas en Content > Blog posts y enlácelas a productos y colecciones. Dé a cada colección una descripción real con su propio título SEO (Shopify recomienda hasta 60 caracteres) y una descripción de unos 160. Ponga unas preguntas frecuentes visibles en una página, en Online Store > Pages, y enlácelas después desde su
llms.txt.liquid.Compruebe que funcionóCompruebe que funciona
Ejecute esto desde un terminal, sustituyendo el dominio y el handle del producto:
curl -sI https://yourstore.com/llms.txt | head -n 5debería mostrar 200, y una petición GET debería mostrar su contenido editado.curl -s https://yourstore.com/llms.txt | head -n 20debería mostrar sus encabezados y enlaces.curl -sI https://yourstore.com/agents.mdycurl -sI https://yourstore.com/sitemap.xmldeberían devolver 200 ambos.curl -s https://yourstore.com/robots.txtdebería seguir conteniendo los Disallow de carrito y pago bajo*.curl -s https://yourstore.com/products/your-handle | grep -oE '"@type" ?: ?"(Product|ProductGroup)"' | sort | uniq -cdebería mostrar una sola entidad.Después, vuelva a revisar la vista previa de la búsqueda agéntica.
Código para Shopify
Su templates/llms.txt.liquid. Sustituya el texto de ejemplo y las rutas de página por las suyas:
# {{ agents.store_name }}

> Short, factual summary of what the store sells, who it is for, and where it ships.

## Key pages
- [All products]({{ agents.store_url }}/collections/all)
- [Best sellers]({{ agents.store_url }}/collections/best-sellers): our most ordered products
- [Size and fit guide]({{ agents.store_url }}/pages/size-guide)
- [FAQ]({{ agents.store_url }}/pages/faq): shipping, returns, care
- [Buying guides]({{ agents.store_url }}/blogs/guides)

## Policies
- [Refund policy]({{ agents.store_url }}/policies/refund-policy)
- [Shipping policy]({{ agents.store_url }}/policies/shipping-policy)

## For agents
- UCP discovery: {{ agents.ucp_discovery_url }}
- MCP endpoint: {{ agents.mcp_endpoint_url }}
- Sitemap: {{ agents.sitemap_url }}
- Prices are in {{ agents.currency }}.
El robots.txt.liquid siguiente conserva el bucle predeterminado de Shopify y añade una exclusión del entrenamiento. Según shopify.dev, los grupos de texto plano para un rastreador nuevo van fuera del bucle:
{% for group in robots.default_groups %}
{{- group.user_agent }}
{%- for rule in group.rules -%}
  {{ rule }}
{%- endfor -%}
{%- if group.sitemap != blank -%}
  {{ group.sitemap }}
{%- endif -%}
{% endfor %}

User-agent: GPTBot
Disallow: /
El patrón de datos estructurados del propio tema. Ya está en Dawn, así que solo lo necesita si crea un tema personalizado:
<script type="application/ld+json">
{{ product | structured_data }}
</script>

<script type="application/ld+json">
{{ article | structured_data }}
</script>
El bloque Organization de sections/header.liquid de Dawn 16.0.0, literal, de Shopify/dawn. Es una referencia, así que no necesita pegarlo en un tema Dawn sin modificar:
<script type="application/ld+json">
{
  "@context": "http://schema.org",
  "@type": "Organization",
  "name": {{ shop.name | json }},
  {% if settings.logo %}
    "logo": {{ settings.logo | image_url: width: 500 | prepend: "https:" | json }},
  {% endif %}
  "sameAs": [
    {{ settings.social_twitter_link | json }},
    {{ settings.social_facebook_link | json }},
    {{ settings.social_pinterest_link | json }},
    {{ settings.social_instagram_link | json }},
    {{ settings.social_tiktok_link | json }},
    {{ settings.social_tumblr_link | json }},
    {{ settings.social_snapchat_link | json }},
    {{ settings.social_youtube_link | json }},
    {{ settings.social_vimeo_link | json }}
  ],
  "url": {{ request.origin | append: page.url | json }}
}
</script>
Una sección FAQPage manual para una página de preguntas frecuentes visible. El texto de la pregunta es un ejemplo: sustitúyalo por las preguntas y respuestas exactas que se muestran en la página.
{%- comment -%} Add to the FAQ page template only {%- endcomment -%}
<script type="application/ld+json">
{
"@context": "https://schema.org",
"@type": "FAQPage",
"mainEntity": [
  {
    "@type": "Question",
    "name": {{ "How long does shipping take?" | json }},
    "acceptedAnswer": {
      "@type": "Answer",
      "text": {{ "Orders ship in 1 to 2 business days. US delivery takes 3 to 5 days." | json }}
    }
  }
]
}
</script>
Google eliminó el resultado enriquecido de preguntas frecuentes, así que no añada esto esperando estrellas ni fragmentos desplegables. El marcado sigue describiendo la página con exactitud a cualquier analizador que lo lea.
llms.txt.liquid
Plantilla dinámica de llms.txt para un tema de Shopify.
Shopify
robots.txt.liquid
Bucle predeterminado conservado, más una exclusión del entrenamiento.
Shopify
Sección de esquema FAQ
JSON-LD de FAQPage para una página de preguntas frecuentes visible.
Shopify
React, Next.js y Astro: paso a paso
Las tecnologías a medida tienen un fallo que importa más que cualquier archivo que añada: la respuesta no está en el HTML que envía el servidor. Compruébelo primero, en cualquier framework, con una sola prueba. Descargue la página como lo hace un rastreador que no ejecuta JavaScript y busque una frase del cuerpo.
Compruebe si la respuesta está en el HTML del servidor antes que nada. El estudio de Vercel y MERJ concluyó que varios rastreadores de IA importantes no renderizaban JavaScript, y el seguimiento de 2026 de Vercel concluyó que un cliente que solo descarga el HTML no podía obtener una respuesta que existía únicamente mediante JavaScript. Las fechas y los detalles están en el fundamento del HTML del servidor. Google afirma que el renderizado en el servidor o el prerrenderizado sigue siendo una gran idea, y califica el renderizado dinámico de solución provisional, no de solución a largo plazo.
#!/usr/bin/env bash
# Usage: ./check-ai-crawl.sh https://www.example.com/your-page "a sentence from the page"
# Fetches the page the way a crawler that does not run JavaScript sees it.
# This only tests user-agent rules. Firewalls that verify crawler IPs will treat
# your request as an impostor, so confirm with server logs as well.
URL="$1"; PHRASE="$2"
UA='Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot'
HTML=$(curl -sL -A "$UA" "$URL")
HEAD=${HTML%%</head>*}
echo "Status:        $(curl -s -o /dev/null -w '%{http_code}' -A "$UA" "$URL")"
echo "Redirects to:  $(curl -s -o /dev/null -w '%{redirect_url}' -A "$UA" "$URL")"
echo "Title in head: $(grep -o '<title>[^<]*' <<<"$HEAD" | sed 's/<title>//' | head -1)"
echo "Canonical:     $(grep -o '<link rel="canonical"[^>]*' <<<"$HEAD" | grep -o 'href="[^"]*' | sed 's/href="//' | head -1)"
echo "JSON-LD blocks: $(grep -o 'application/ld+json' <<<"$HTML" | wc -l | tr -d ' ')"
if grep -qF "$PHRASE" <<<"$HTML"; then echo "Phrase in raw HTML: YES"; else echo "Phrase in raw HTML: NO (content likely needs JavaScript)"; fi
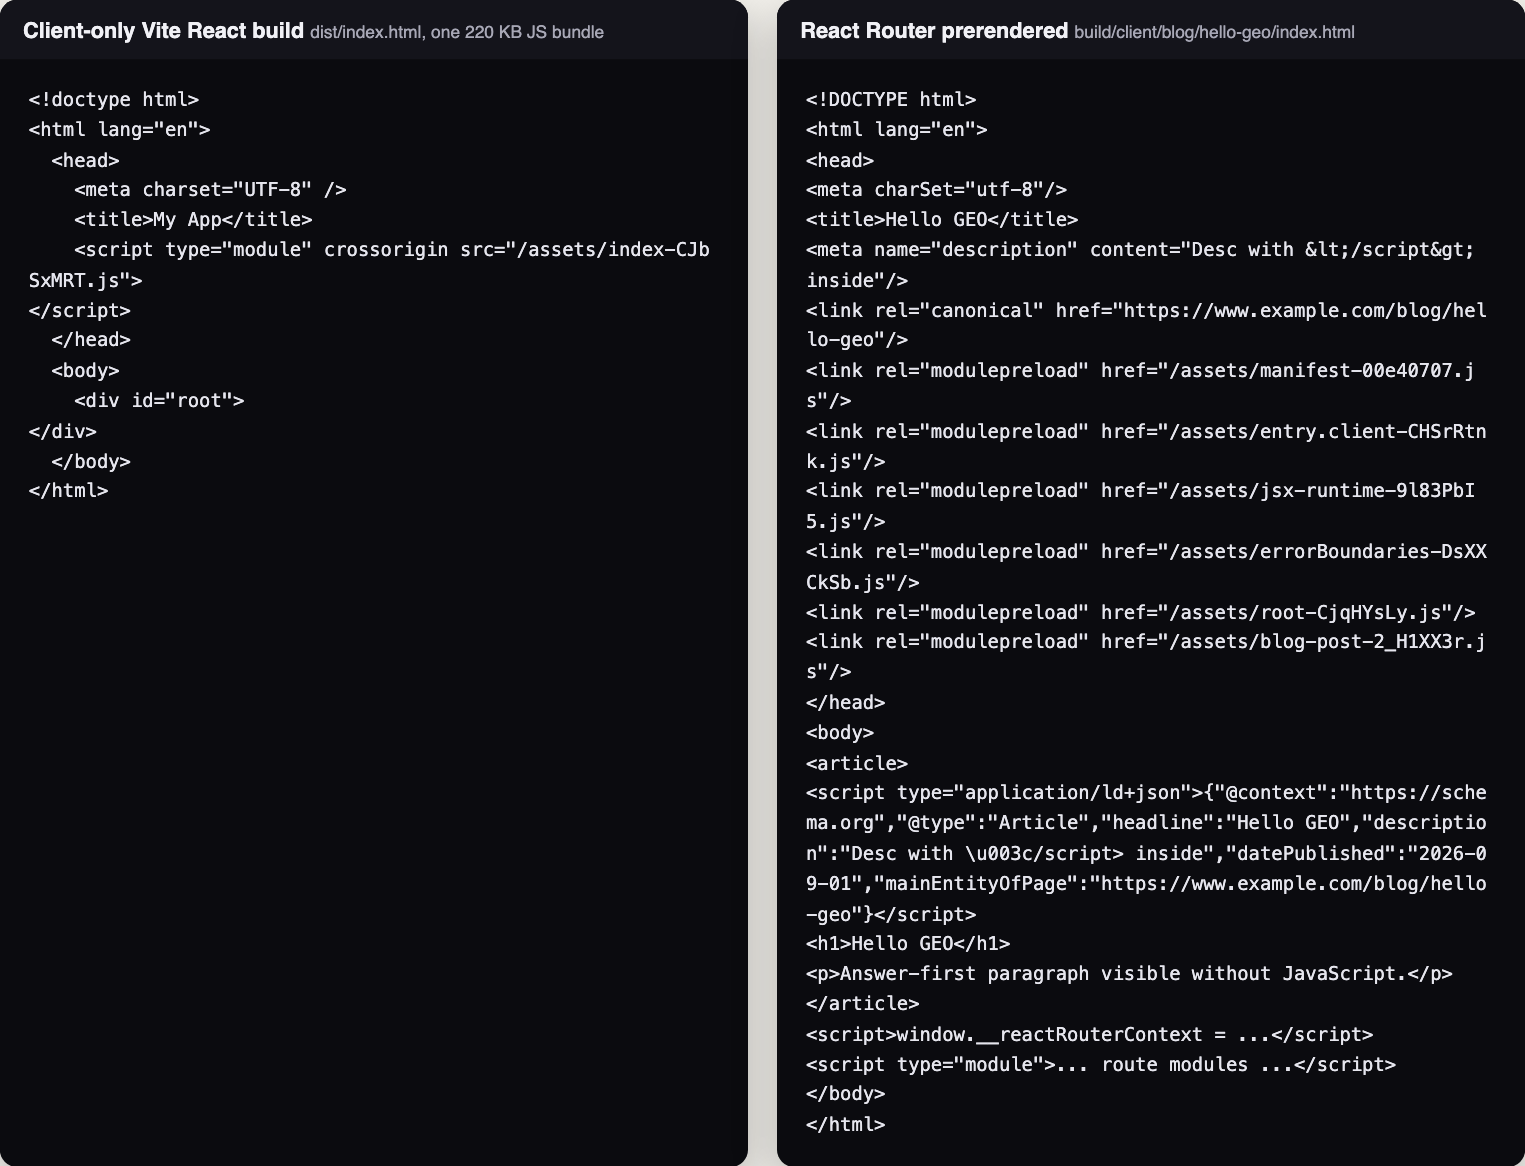
Lo ejecutamos sobre dos compilaciones del mismo artículo. La aplicación Vite que solo funciona en el cliente devolvió un div id="root" vacío, el título «My App» y ningún JSON-LD. El texto estaba en un paquete de JavaScript de 220 KB. El mismo contenido prerrenderizado con React Router devolvió el título real, la canonical, el JSON-LD y la frase.
Abrir a tamaño completo (pestaña nueva)
SEO de React para rastreadores de IA: prerrenderice el HTML
Una aplicación React renderizada en el cliente puede posicionarse en Google y, aun así, estar vacía para otros rastreadores, porque Googlebot renderiza JavaScript. Probar solo en Google oculta el problema.
PasosHaga que una SPA de React se pueda leer sin JavaScript
Diagnostique con view-source
Abra su página clave, elija View Source (no DevTools) y busque su titular. Un
div id="root"vacío significa que los rastreadores que no renderizan no obtienen nada. Después ejecute elcheck-ai-crawl.shanterior y busque «Phrase in raw HTML: YES».Elija una solución, en este orden
- React Router en modo framework con
prerenderyssr: false. Su documentación indica que el prerrenderizado es útil para el SEO, sobre todo en despliegues sin renderizado en el servidor. - Pasar a Next.js, que se explica a continuación.
- Para un sitio de marketing con mucho contenido, Astro con islas de React.
- Un prerrenderizado propio con
react-dom/static. Funciona, pero es de bajo nivel, y los frameworks lo llaman normalmente por usted.
Descarte el renderizado dinámico. Create React App está obsoleto para aplicaciones nuevas desde el 14 de febrero de 2025. Consulte la documentación de React Router de la versión que tenga instalada, ya que las opciones de prerrenderizado se documentan por versión.
- React Router en modo framework con
Prerrenderice todas las URL de contenido, incluidos los slugs
prerender: trueomite las rutas dinámicas como/blog/:slug. Use la forma de función y añada usted mismo los slugs.react-router.config.ts import type { Config } from '@react-router/dev/config' import { getPostSlugs } from './app/lib/posts' export default { // No runtime server: every listed URL becomes a static HTML file at build time. ssr: false, async prerender({ getStaticPaths }) { const slugs = await getPostSlugs() return [...getStaticPaths(), ...slugs.map((s) => '/blog/' + s)] }, } satisfies ConfigPonga las etiquetas del head en el componente de la ruta
React Router recomienda los elementos integrados
title,metaylinken lugar de la exportaciónmetadel módulo de la ruta. React 19 los lleva al head del documento. En nuestra compilación acabaron en elheaddel archivo prerrenderizado. Añada el JSON-LD en el mismo componente y escape<, porqueJSON.stringifydeja intacto</script>.app/routes/blog-post.tsx import { data, useLoaderData } from 'react-router' import { getPost } from '../lib/posts' const SITE_URL = 'https://www.example.com' // With prerendering, this loader runs at build time, so the post is in the HTML file. export async function loader({ params }: { params: { slug?: string } }) { const post = await getPost(params.slug ?? '') if (!post) throw data('Not found', { status: 404 }) return { post } } export default function BlogPost() { const { post } = useLoaderData<typeof loader>() const url = SITE_URL + '/blog/' + post.slug const article = { '@context': 'https://schema.org', '@type': 'Article', headline: post.title, description: post.description, datePublished: post.publishedAt, mainEntityOfPage: url, } return ( <article> <title>{post.title}</title> <meta name="description" content={post.description} /> <link rel="canonical" href={url} /> <script type="application/ld+json" dangerouslySetInnerHTML={{ __html: JSON.stringify(article).replace(/</g, '\u003c') }} /> <h1>{post.title}</h1> <p>{post.body}</p> </article> ) }Despliegue con una alternativa acotada
Sirva
build/client. Reescriba a__spa-fallback.htmlúnicamente las rutas que no haya prerrenderizado. Esa reescritura responde 200 a cualquier URL desconocida, así que mantenga exacto su mapa del sitio. En sus datos de 2024, Vercel observó que el rastreador de ChatGPT dedicaba una parte importante de sus descargas a errores 404, de modo que las URL rotas o perdidas le salen caras.Compruebe que funcionóCompruebe que funciona
El registro de la compilación debería imprimir una línea como
Prerender (html): /blog/hello-geo -> build/client/blog/hello-geo/index.html. Abra ese archivo, confirme que contiene el título, la canonical y el texto del artículo, y ejecute despuéscheck-ai-crawl.shcontra la URL desplegada. Lo que debe ver esPhrase in raw HTML: YES.
react-router.config.ts
Configuración de prerrenderizado con slugs dinámicos.
React
Ruta de entrada de blog
Etiquetas del head y JSON-LD con escape en el componente de la ruta.
React
SEO de Next.js y llms.txt (App Router)
Next.js puede enviar HTML completo, pero es fácil construir una página que no lo haga. Estos pasos se construyeron y probaron en Next.js 16.4.0 (la documentación corresponde a la misma versión).
PasosEnvíe el texto de la respuesta y los metadatos en la primera respuesta
Mantenga el texto de la respuesta en Server Components
Las páginas y los layouts son Server Components por defecto. Los Client Components también se prerrenderizan, pero los datos cargados en
useEffectno están en ese HTML. En nuestra prueba con la 16.4.0, una página'use client'que cargaba su texto en un efecto envió un HTML que solo contenía «Loading…». Use los Client Components para la interactividad, no para la respuesta.Defina los metadatos raíz con metadataBase
En
app/layout.tsx, exportemetadataconmetadataBase: new URL(SITE_URL), una plantilla de título,alternates.canonicalyopenGraph. Las exportaciones de metadatos solo funcionan en Server Components.Use generateMetadata y generateStaticParams
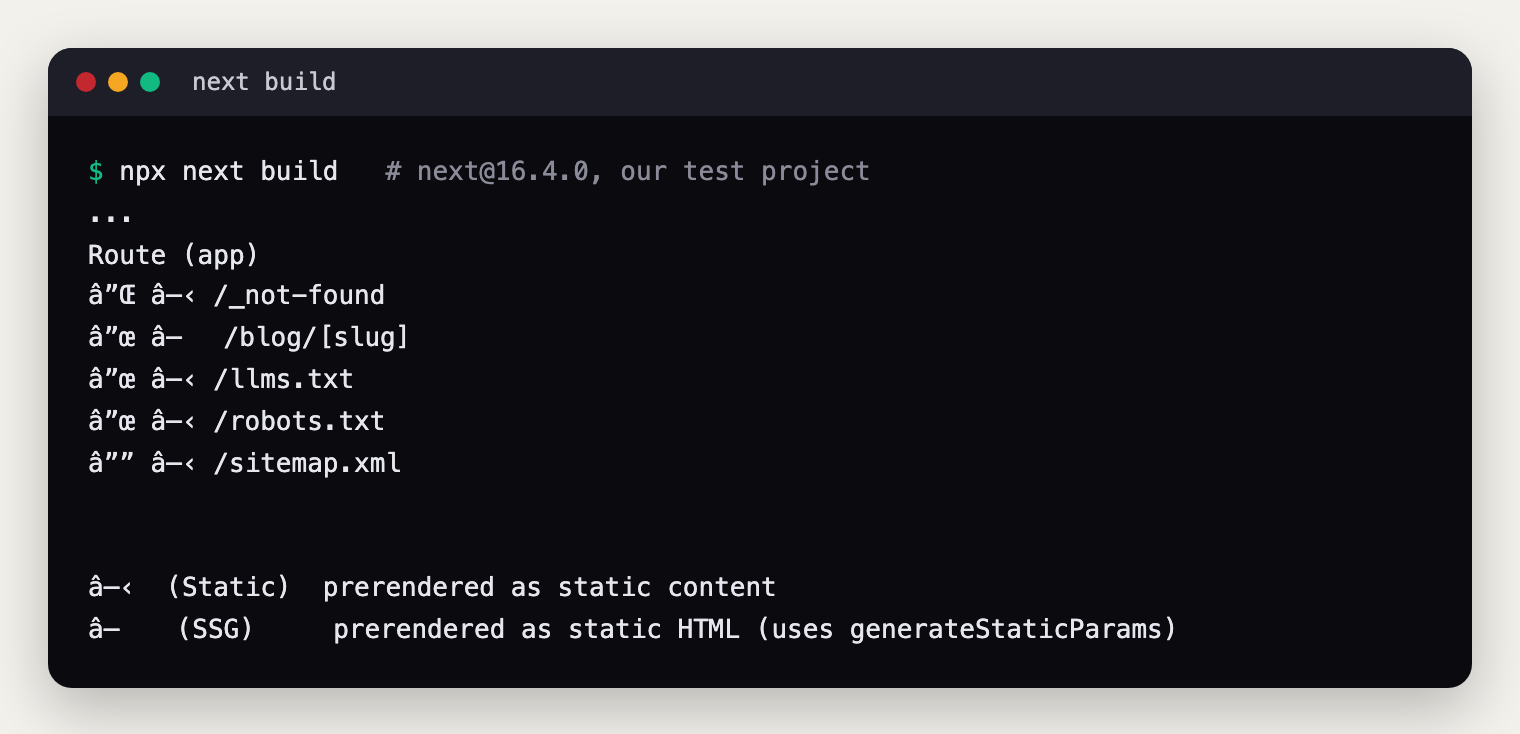
paramses una Promise en las versiones actuales. Al prerrenderizar las entradas, los metadatos y el artículo completo están en el HTML inicial, y la ruta aparece como SSG en la tabla de la compilación.app/blog/[slug]/page.tsx import type { Metadata } from 'next' import { notFound } from 'next/navigation' import { getPost, getPosts } from '@/lib/posts' import { SITE_URL } from '@/lib/site' import { jsonLd } from '@/lib/json-ld' type Props = { params: Promise<{ slug: string }> } // Prerender every post at build time so the full article is in the HTML response. export async function generateStaticParams() { return (await getPosts()).map((p) => ({ slug: p.slug })) } export async function generateMetadata({ params }: Props): Promise<Metadata> { const { slug } = await params const post = await getPost(slug) if (!post) return {} return { title: post.title, description: post.description, alternates: { canonical: '/blog/' + post.slug }, } } export default async function Page({ params }: Props) { const { slug } = await params const post = await getPost(slug) if (!post) notFound() const article = { '@context': 'https://schema.org', '@type': 'Article', headline: post.title, datePublished: post.publishedAt, dateModified: post.updatedAt ?? post.publishedAt, mainEntityOfPage: SITE_URL + '/blog/' + post.slug, } return ( <article> <script type="application/ld+json" dangerouslySetInnerHTML={{ __html: jsonLd(article) }} /> <h1>{post.title}</h1> <div>{post.body}</div> </article> ) }Genere el JSON-LD como un script nativo, con escape
La guía de JSON-LD de Next.js indica que se use una etiqueta
scriptnormal, nonext/script, y que se sustituya<por su escape Unicode, porqueJSON.stringifyno sanea. Póngalo en una única función auxiliar.lib/json-ld.ts // JSON.stringify does not escape "<", so "</script>" inside a value would end the tag early. export function jsonLd(data: object): string { return JSON.stringify(data).replace(/</g, '\u003c') }Escriba robots.ts con los Disallow repetidos
app/robots.tsacepta un array parauserAgent. Un rastreador obedece únicamente su grupo coincidente más específico, así que repita los Disallow. Trate los rastreadores de entrenamiento como una decisión distinta de la de los bots de búsqueda.app/robots.ts import type { MetadataRoute } from 'next' import { SITE_URL } from '@/lib/site' export default function robots(): MetadataRoute.Robots { return { rules: [ { userAgent: '*', allow: '/', disallow: ['/api/', '/account/'] }, { userAgent: [ 'OAI-SearchBot', 'ChatGPT-User', 'Claude-SearchBot', 'Claude-User', 'PerplexityBot', 'Perplexity-User', 'GPTBot', 'ClaudeBot', 'Google-Extended', ], allow: '/', disallow: ['/api/', '/account/'], }, ], sitemap: SITE_URL + '/sitemap.xml', } }Escriba sitemap.ts con un lastModified real
Google ignora priority y changefreq y usa lastmod solo cuando es sistemáticamente exacto. Tome la fecha del contenido, nunca de
new Date().app/sitemap.ts import type { MetadataRoute } from 'next' import { getPosts } from '@/lib/posts' import { SITE_URL } from '@/lib/site' export default async function sitemap(): Promise<MetadataRoute.Sitemap> { const posts = await getPosts() return [ { url: SITE_URL, lastModified: '2026-10-01' }, ...posts.map((p) => ({ url: SITE_URL + '/blog/' + p.slug, lastModified: p.updatedAt ?? p.publishedAt, })), ] }Sirva llms.txt desde un route handler
Los Route Handlers GET no se almacenan en caché por defecto, así que añada
force-static. Si activacacheComponents, elimine esa línea: la opción se suprime en ese modo, y un handler que no lee datos de la petición se prerrenderiza. Construya la lista con la misma función de entradas que usan las páginas.app/llms.txt/route.ts import { getPosts } from '@/lib/posts' import { SITE_NAME, SITE_URL } from '@/lib/site' // Delete this line if cacheComponents is enabled. export const dynamic = 'force-static' export async function GET() { const posts = await getPosts() const body = [ '# ' + SITE_NAME, '', '> One or two sentences: what you do, for whom, and where.', '', '## Guides', ...posts.map((p) => '- [' + p.title + '](' + SITE_URL + '/blog/' + p.slug + '): ' + p.description), '', ].join('\n') return new Response(body, { headers: { 'Content-Type': 'text/plain; charset=utf-8' } }) }Se aplica la misma salvedad de antes: este archivo es un complemento del HTML del servidor, no un sustituto.
Trate las rutas en tiempo de petición: la trampa de htmlLimitedBots
Las rutas que leen cookies, cabeceras o datos sin caché se renderizan en el momento de la petición. Desde Next.js 15.2, la salida de su
generateMetadatase transmite albodypara cualquier bot que no esté en la lista de bots con HTML limitado. Leímos la lista predeterminada en el código fuente y no incluye ningún rastreador de IA. En nuestra prueba con la 16.4.0, GPTBot y ClaudeBot recibían eltitleen elbodypor defecto y en elheaddespués de añadirlos.Al definir la opción se sustituye la lista predeterminada, así que copie la predeterminada y añada al final los bots de IA. Vuelva a revisar la copia en cada actualización de Next.js. Las páginas totalmente prerrenderizadas no se ven afectadas. La documentación de Next.js dice que el streaming no perjudica al SEO; esa afirmación se refiere a Google, que ejecuta JavaScript, así que no la extienda a los rastreadores de IA.
next.config.ts import type { NextConfig } from 'next' // Copied from the Next.js default (canary html-bots.ts, October 2026). Re-check on upgrade. const NEXT_DEFAULT = String.raw`[\w-]+-Google|Google-[\w-]+|Chrome-Lighthouse|Slurp|DuckDuckBot|baiduspider|yandex|sogou|bitlybot|tumblr|vkShare|quora link preview|redditbot|ia_archiver|Bingbot|BingPreview|applebot|facebookexternalhit|facebookcatalog|Twitterbot|LinkedInBot|Slackbot|Discordbot|WhatsApp|SkypeUriPreview|Yeti|googleweblight` const AI_CRAWLERS = 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User' const nextConfig: NextConfig = { htmlLimitedBots: new RegExp(NEXT_DEFAULT + '|' + AI_CRAWLERS, 'i'), } export default nextConfigDecida si necesita exportación estática
Con
output: 'export', Next.js escribe el HTML enout/y los Route Handlers deben serforce-staticpara prerrenderizarse. Es adecuado para un sitio de presentación alojado en un almacenamiento simple.Compruebe que funcionóCompruebe que funciona
En la tabla de rutas de
next build, sus rutas de contenido deberían aparecer como estáticas o SSG, no como dinámicas. Después descargue/robots.txt,/sitemap.xmly/llms.txt(el último debería devolvertext/plain; charset=utf-8) y ejecutecheck-ai-crawl.shsobre una entrada. Un slug desconocido debería devolver 404.
Abrir a tamaño completo (pestaña nueva)
Metadatos de App Router y JSON-LD
generateMetadata, generateStaticParams y un script JSON-LD nativo.
Next.js
robots, sitemap y llms.txt
robots.ts con Disallow repetidos. Los archivos de ruta del sitemap y de llms.txt están en la misma carpeta.
Next.js
next.config.ts
htmlLimitedBots con los rastreadores de IA añadidos al final.
Next.js
SEO de Astro y llms.txt
Astro es el más sencillo de los tres, porque las páginas y los endpoints se prerrenderizan en la compilación por defecto. La mayor parte del trabajo consiste en evitar errores.
PasosAñada archivos legibles por la IA a un sitio Astro
Mantenga el texto de la respuesta fuera de client:only
Los componentes sin una directiva
client:*se renderizan como HTML simple.client:onlyomite por completo el renderizado en el servidor, así que no ponga nunca en uno de ellos el texto de la respuesta.Añada un componente JSON-LD que aplique el escape
Astro no aplica escape a
set:html, yJSON.stringifydeja intacto</script>. En nuestra prueba con Astro 7.0.5, una descripción que contenía</script>terminó el bloque antes de tiempo y falló el análisis del JSON. Escapar<lo resolvió. Astro no procesa una etiqueta script que tenga atributos distintos desrc, así que el bloque se genera tal como está escrito.src/components/JsonLd.astro --- interface Props { data: Record<string, unknown>; } const { data } = Astro.props; const json = JSON.stringify(data).replace(/</g, '\u003c'); --- <script type="application/ld+json" set:html={json} />Genere llms.txt a partir de la colección de contenido
Un endpoint de archivo estático en
src/pages/llms.txt.tsconstruye/llms.txten la compilación. Si lee degetCollection(), no puede desviarse de las páginas publicadas.src/pages/llms.txt.ts import type { APIRoute } from 'astro'; import { getCollection } from 'astro:content'; export const GET: APIRoute = async ({ site }) => { const url = (path: string) => new URL(path, site).href; const posts = (await getCollection('blog', ({ data }) => !data.draft)).sort( (a, b) => b.data.publishDate.getTime() - a.data.publishDate.getTime(), ); const body = [ '# Example Co', '', '> One or two sentences: what you do, for whom, and where.', '', '## Guides', ...posts.map((p) => '- [' + p.data.title + '](' + url('/blog/' + p.id) + '): ' + p.data.description), '', ].join('\n'); return new Response(body, { headers: { 'Content-Type': 'text/plain; charset=utf-8' } }); };Elija una única fuente para robots.txt
Use
public/robots.txto un endpoint, no ambos. El endpoint puede reutilizarsitey repetir las reglas en el grupo de IA, como muestran para los mapas del sitio los documentos de la integración de sitemap.src/pages/robots.txt.tsUse esto O public/robots.txt import type { APIRoute } from 'astro'; const AI_AGENTS = [ 'OAI-SearchBot', 'ChatGPT-User', 'Claude-SearchBot', 'Claude-User', 'PerplexityBot', 'Perplexity-User', 'GPTBot', 'ClaudeBot', 'Google-Extended', ]; export const GET: APIRoute = ({ site }) => { const sitemapURL = new URL('sitemap-index.xml', site); const rules = 'Allow: /\nDisallow: /api/'; return new Response( [ 'User-agent: *\n' + rules, // A crawler that matches a named group ignores the * group, so repeat the rules. AI_AGENTS.map((ua) => 'User-agent: ' + ua).join('\n') + '\n' + rules, 'Sitemap: ' + sitemapURL.href, '', ].join('\n\n'), ); };Defina lastmod del mapa del sitio a partir del frontmatter, para .md y .mdx
@astrojs/sitemapnecesita la opciónsitey no puede listar rutas dinámicas SSR. Useserialize()para fijarlastmoda partir de cada entrada. Cubra ambas extensiones, o convertir una entrada a MDX hará que pierda su fecha sin avisar. Lo descubrimos en nuestro propio sitio.astro.config.mjs import { defineConfig } from 'astro/config'; import sitemap from '@astrojs/sitemap'; import { readdirSync, readFileSync } from 'node:fs'; const postDates = Object.fromEntries( readdirSync('./src/content/blog') .filter((f) => /\.mdx?$/.test(f)) .map((f) => { const fm = readFileSync('./src/content/blog/' + f, 'utf8').split('---')[1] ?? ''; const date = fm.match(/^updatedDate:\s*(\S+)/m)?.[1] ?? fm.match(/^publishDate:\s*(\S+)/m)?.[1]; return ['/blog/' + f.replace(/\.mdx?$/, ''), date]; }), ); export default defineConfig({ site: 'https://www.example.com', integrations: [ sitemap({ serialize(item) { const path = new URL(item.url).pathname.replace(/\/$/, ''); const date = postDates[path]; if (date) item.lastmod = new Date(date).toISOString(); return item; }, }), ], });Enlace el archivo para que los agentes lo encuentren
Añada
link rel="alternate" type="text/plain" href="/llms.txt"o un enlace en el pie de página. La especificación llms.txt v2 usarel="describedby"para esto.Compruebe que funcionóCompruebe que funciona
Ejecute
npx astro build. Abradist/llms.txt,dist/robots.txt,dist/sitemap-0.xmly undist/blog/your-post/index.html. Tras el despliegue, ejecutecheck-ai-crawl.shsobre la URL publicada y busque «Phrase in raw HTML: YES».
JsonLd.astro
Componente JSON-LD que aplica el escape del signo menor que.
Astro
Endpoint de llms.txt
Construye llms.txt a partir de la colección de contenido.
Astro
Endpoint de robots.txt
Repite las reglas dentro del grupo de IA.
Astro
Serializador del mapa del sitio
Define lastmod a partir del frontmatter para .md y .mdx.
Astro
maxenius.com como ejemplo real en Astro
Este sitio está construido tal como describen los pasos anteriores, y puede inspeccionarlo.
src/lib/llms.ts,src/pages/llms.txt.tsysrc/pages/llms-full.txt.tsconstruyen /llms.txt y /llms-full.txt a partir de los mismos datos que las páginas.public/robots.txtrepite sus reglas dentro del grupo con nombre de los rastreadores de IA. Es una política de máxima visibilidad: da la bienvenida a todos los rastreadores indicados, incluidos los de entrenamiento. Elija su propia política de forma deliberada, como se explica en el fundamento de robots.txt.Seo.astroysrc/lib/seo.tsgeneran una metaetiqueta robots conmax-snippet:-1, unlink rel="alternate" type="text/plain"a/llms.txty un grafo JSON-LD con Organization, WebSite, WebPage, Article, FAQPage y BreadcrumbList.astro.config.mjsusa salida estática y toma ellastmoddel mapa del sitio del frontmatter de cada entrada.
Elija lo que elija, el HTML del servidor es el cimiento. Los archivos y el marcado de esta sección son complementos añadidos encima.
Medir y probar
Necesita cinco fuentes, porque ninguna lo cubre todo: Search Console para Google, GA4 o Plausible para los clics, Bing Webmaster Tools para las citas de Copilot, los registros del servidor para los bots y las pruebas de prompts para saber qué dicen las respuestas. Cada una responde a una pregunta distinta y tiene puntos ciegos, así que léalas juntas.
Dónde informa cada fuente
| Fuente | Qué muestra | Qué no muestra |
|---|---|---|
| Rendimiento de Search Console | Clics e impresiones de AI Overviews y AI Mode, contados dentro del tipo de búsqueda Web. Cuenta un clic en un enlace externo en cualquiera de las dos funciones. | Todos los enlaces de un AI Overview comparten una misma posición, por lo que una página citada puede mostrar una buena posición y un CTR minúsculo. Una pregunta de seguimiento en AI Mode cuenta como una consulta nueva. Se excluyen los experimentos de Search Labs. La página de funciones de IA de Google confirma el tipo Web. |
| Informe de IA generativa de Search Console | Impresiones en AI Overviews y AI Mode por página, país, dispositivo y fecha. Anunciado el 3 de junio de 2026; para todos los sitios desde el 31 de agosto de 2026. | Sin clics, CTR, posición ni consultas. Puede no aparecer si su sitio tiene muy pocas impresiones de IA. Es un subconjunto de los datos Web, así que no lo sume al informe de Rendimiento. |
| AI Performance de Bing Webmaster Tools | Versión preliminar pública desde el 10 de febrero de 2026: Total Citations, Average Cited Pages, grounding queries (muestreadas) y actividad de citas por página. Desde el 16 de junio de 2026: Intents, Topics, Citation Share y Compare, en versión preliminar. | Una cita no es un clic ni una visita. Los datos son muestreados, y las grounding queries son frases agrupadas, no prompts reales. Citation Share no expone los dominios de la competencia. |
| GA4 y Plausible | Visitas con referente o UTM. GA4 tiene un canal predeterminado AI Assistant desde el 13 de mayo de 2026. Plausible tiene un canal AI Assistants. | El canal de GA4 excluye AI Overviews y AI Mode, que cuentan como Organic Search. OpenAI documenta solo utm_source=chatgpt.com, así que los demás asistentes dependen de los referentes. |
| Registros del servidor | Cada petición de bots, incluidas las descargas activadas por el usuario que nunca ejecutan JavaScript. | Quién leyó la respuesta o hizo clic. Requiere comprobar las IP, porque los agentes de usuario pueden falsificarse. |
| Pruebas de prompts | Lo que cada motor dice realmente de usted hoy. | Una posición estable. Google indica que AI Overviews y AI Mode pueden usar modelos distintos y variar sus enlaces, por lo que una sola ejecución engaña. |
Configure la medición, paso a paso
PasosMida la visibilidad en la búsqueda con IA
Separe las impresiones de las funciones de IA
Empiece por aquí con cualquier página que tenga muchas impresiones y casi ningún clic.
- En Search Console, abra Performance, filtre Page por su URL y anote las impresiones, los clics, el CTR y la posición media.
- Abra el informe de rendimiento de IA generativa, vaya a la pestaña Pages y busque la misma URL.
- Compare los dos recuentos de impresiones. El informe de IA es un subconjunto de Web, así que no los sume nunca. Si las funciones de IA acumulan la mayoría de las impresiones, es esperable una buena posición con un CTR bajo, porque todos los enlaces de un AI Overview comparten una misma posición.
- Si falta el informe, Google indica que el sitio todavía no ha tenido suficientes impresiones de IA. No es un error.
- Abra Settings > Search generative AI y confirme que la propiedad no está en Exclude ni hereda Exclude de una propiedad superior. Consulte Search generative AI control.
- Añada una anotación el día en que publique los cambios: haga clic con el botón derecho en el gráfico de Performance, hasta 120 caracteres (ayuda sobre anotaciones).
Use el canal AI Assistant integrado
En GA4, vaya a Reports > Acquisition > Traffic acquisition. Fije la dimensión principal en Session default channel group y busque la fila AI Assistant. Añada Session source como dimensión secundaria para ver qué asistente envió cada sesión. Los clics de AI Overviews y AI Mode no estarán aquí. En Plausible, abra Sources > Channels > AI Assistants.
Añada un grupo de canales personalizado
Vaya a Admin > Data display > Channel groups, cree un grupo y añada un canal en el que Source coincida con la expresión regular siguiente. Arrástrelo por encima de Referral, porque el tráfico va al primer canal con el que coincide. Las propiedades estándar admiten 2 grupos personalizados, y los grupos personalizados no están en la exportación a BigQuery.
La expresión regular de ejemplo de Google en ese artículo de ayuda coincidía de más en nuestra prueba: también capturaba help.openai.com, github.com/copilot, chatgptlist.org y «shanghai». Use en su lugar esta, más estricta.
ga4-ai-sources.regex111 caracteres, anclada ^(.*\.)?(chatgpt\.com|chat\.openai\.com|perplexity\.ai|claude\.ai|copilot\.microsoft\.com|gemini\.google\.com)$Acepta chatgpt.com, chat.openai.com, www.perplexity.ai, claude.ai, copilot.microsoft.com y gemini.google.com. Rechaza google, mail.google.com, openai.com, help.openai.com, notchatgpt.com, perplexity.ai.evil.com y bing.com. Cubre el host con www y el antiguo host de ChatGPT porque chat.openai.com redirige a chatgpt.com y perplexity.ai redirige a www.perplexity.ai. La expresión regular de GA4 es de coincidencia completa y distingue mayúsculas de minúsculas por defecto, usa RE2, y los filtros de informes se limitan a 250 caracteres. Las anclas mantienen correcto este patrón en ambos modos de coincidencia. Añada otros asistentes solo después de que aparezcan en su propio informe de Session source.
Vigile los UTM perdidos
Busque en Session source / medium filas de chatgpt.com situadas en Unassigned o Referral, porque Google no documenta cómo resuelve GA4 un utm_source sin medium frente a la regla de AI Assistant. Una redirección que descarta la cadena de consulta, como una regla de barra final, de www o de http a https, descarta también el UTM. Pruebe una URL etiquetada a través de todas las redirecciones que tenga.
Cree una Exploration (opcional)
Sáltese este paso si el informe de canales integrado responde a su pregunta. En Explore, empiece una exploración en blanco. Importe las dimensiones Session source, Session source / medium, Landing page + query string y Session default channel group, además de las métricas Sessions, Engaged sessions y Key events. Ponga Session source y después Landing page + query string en Rows, y filtre Session source con la misma expresión regular.
Lea las citas de Copilot y Bing
- Verifique el sitio en Bing Webmaster Tools y abra el informe AI Performance.
- Lea Total Citations, Average Cited Pages, las grounding queries y la lista Pages. Haga clic en una grounding query para ver sus páginas citadas, o en una página para ver sus grounding queries.
- Use Compare para superponer el periodo posterior a la publicación de los cambios. Intents, Topics y Citation Share son funciones en versión preliminar.
- Exporte a CSV o Excel cada mes. Lea las preguntas frecuentes para conocer las reglas de muestreo y actualización.
- Envíe las URL modificadas a través de IndexNow. Bing lo recomienda para que las respuestas de IA usen la versión actual de la página.
Cuente los accesos de bots de IA en los registros del servidor
Busque estos agentes de usuario. Búsqueda: OAI-SearchBot, Claude-SearchBot, PerplexityBot, Googlebot, bingbot. Entrenamiento: GPTBot, ClaudeBot. Activados por el usuario: ChatGPT-User, Claude-User, Perplexity-User. Google-Extended no aparecerá nunca, porque es un token de robots.txt sin agente de usuario propio.
Los accesos activados por el usuario son los que más importan. Cada uno significa que una conversación real leyó su página y, como estas descargas no ejecutan JavaScript, GA4 y Plausible no las ven nunca.
Un recuento rápido a partir de un registro en formato combinado. Esta versión con awk cuenta cada línea una sola vez, mientras que un grep sencillo contaba bingbot dos veces por línea:
terminalCuenta cada línea una sola vez awk 'match($0, /OAI-SearchBot|ChatGPT-User|GPTBot|Claude-SearchBot|Claude-User|ClaudeBot|PerplexityBot|Perplexity-User|Googlebot|bingbot/) { print substr($0, RSTART, RLENGTH), $7 }' access.log | sort | uniq -c | sort -rnLos agentes de usuario son fáciles de falsificar, así que verifique las IP. Nuestro
ai_bot_report.py(Python 3, solo biblioteca estándar, incluido en el kit) cuenta los accesos por día, bot, estado y ruta, y comprueba cada IP con la lista publicada por el operador de OpenAI, Anthropic, Perplexity, Google y Bing. Una fila conip_verified=NOes un agente de usuario falsificado. Señala un GPTBot falso procedente de una IP no incluida en la lista.terminal python3 ai_bot_report.py access.log > ai-bots.csv zcat access.log.*.gz | python3 ai_bot_report.py - > ai-bots.csvSin el script, use la doble búsqueda: el DNS inverso de la IP debe devolver un nombre de host de Google (googlebot.com, google.com o googleusercontent.com) o uno que termine en search.msn.com para Bingbot, y una búsqueda directa de ese nombre debe devolver la misma IP.
En Vercel, vaya a Firewall > Rules > Bot Management y ponga el conjunto de reglas AI Bots en Log, no en Deny (WAF managed rulesets). Después use Firewall > Traffic y agrupe por User Agents y Request Paths (observability). Los Runtime Logs solo muestran las peticiones estáticas servidas desde la caché. Un registro completo requiere Drains, que están en los planes Pro y Enterprise, con
proxy.userAgenten cada registro:vercel-drain-bots.shRequiere jq jq -r 'select(.proxy) | [(.proxy.timestamp/1000|todate), .proxy.clientIp, .proxy.path, (.proxy.statusCode|tostring), (.proxy.userAgent|join(" "))] | @tsv' drain.ndjson \ | awk -F'\t' 'match($5, /OAI-SearchBot|ChatGPT-User|GPTBot|Claude-SearchBot|Claude-User|ClaudeBot|PerplexityBot|Perplexity-User|Googlebot|bingbot/) { print substr($5, RSTART, RLENGTH) "\t" $3 }' \ | sort | uniq -c | sort -rnEn Cloudflare, abra AI Crawl Control. Si los accesos de rastreadores de IA son casi nulos, compruebe si el ajuste de robots.txt administrado está anteponiendo reglas Disallow para GPTBot, ClaudeBot o Google-Extended.
Ejecute una prueba de prompts repetible
Ninguna herramienta oficial informa de las citas en ChatGPT, Claude o Perplexity, así que pruebe a mano con un protocolo fijo.
- Escriba entre 20 y 40 prompts que abarquen preguntas de cómo hacer algo, comparaciones, preguntas específicas de plataforma y dos o tres preguntas sobre la marca. Dé a cada uno un identificador permanente. Para cambiar la redacción, retire el identificador y añada uno nuevo.
- Motores: ChatGPT con la búsqueda activada, Google AI Mode, Google AI Overviews (una búsqueda normal), Gemini, Perplexity, Microsoft Copilot, Claude con la búsqueda web activada.
- Mantenga constantes los ajustes: país, idioma, con sesión iniciada o sin ella. En ChatGPT use Temporary chat configurado como Unpersonalized, que omite la memoria y las instrucciones personalizadas. Personalized aún puede usar recuerdos existentes. En los demás, use un perfil nuevo o una sesión sin iniciar y anote el modo o el modelo.
- Ejecute cada prompt 3 veces por motor. Las respuestas varían de una ejecución a otra.
- Periodicidad: una referencia base mensual, más una nueva ejecución entre 2 y 4 semanas después de un cambio importante de contenido.
- Registre cada ejecución en
ai-prompt-tracker.csv(26 columnas, dos filas de ejemplo claramente etiquetadas). Calcule la tasa de menciones, la tasa de citas y la cuota de citas (sus URL citadas divididas entre todas las URL citadas, la misma idea que la métrica de Bing). - Conserve las capturas de pantalla como prueba privada. No publique interfaces de terceros.
Google Sheets or ExcelDatos en una hoja llamada runs Mention rate =COUNTIF(runs!N2:N1000,"yes")/COUNTA(runs!C2:C1000) Citation rate =COUNTIF(runs!P2:P1000,"yes")/COUNTA(runs!C2:C1000) Citation share =SUM(runs!R2:R1000)/SUM(runs!S2:S1000)Compruebe que funcionóCompruebe que funciona
Confirme cuatro cosas:
- Tiene una cifra previa para la URL (impresiones totales e impresiones en funciones de IA) y una anotación con la fecha de publicación.
- El filtro de GA4 devuelve únicamente hosts de asistentes.
- La salida de bots muestra sus propias peticiones. Haga una con
curl -A 'OAI-SearchBot' -s -o /dev/null https://yourdomain.com/robots.txty busque después una fila con ese nombre de bot y estado 200. - El registro de prompts tiene una fila de referencia para cada identificador de prompt y cada motor.
Si prefiere que le configuremos y le interpretemos la medición, consulte nuestros servicios de SEO con IA.
Herramientas de terceros
Brand Radar de Ahrefs registra menciones y citas en AI Overviews, AI Mode, ChatGPT, Gemini, Perplexity y Copilot, a partir de un índice de prompts que Ahrefs afirma haber modelado con datos de búsqueda, más los prompts personalizados que usted elija. El Semrush AI Visibility Toolkit ofrece una puntuación de visibilidad, investigación de prompts y seguimiento diario de prompts. Cloudflare AI Crawl Control informa de la actividad de los rastreadores en los sitios que están detrás de Cloudflare. Estas herramientas muestrean prompts en lugar de leer conversaciones reales de usuarios, y Google afirma que ninguna herramienta de terceros tiene acceso a sus sistemas de posicionamiento con IA. Considere sus cifras orientativas y compárelas con sus propios datos de origen.
Lista de verificación de autoauditoría
Repase esta lista en su propio sitio. Cada punto enlaza con la sección que lo explica. Su progreso se guarda solo en este navegador, así que no le acompañará a otro dispositivo.
Autoauditoría GEO
0 de 33 hechos
Kit de inicio de GEO
Todo lo que se puede copiar en esta guía está en una descarga gratuita, sin registro y sin formulario de correo electrónico.
Descargar el kit de inicio de GEO completo
53 archivos en un solo paquete: robots.txt, llms.txt, JSON-LD, IndexNow, WordPress, Shopify, Next.js, React, Astro, scripts, un registro de prompts y una ficha de contenido.
Cualquiera
Lista de verificación de autoauditoría imprimible
La lista de verificación anterior, en dos páginas A4, lista para imprimir o guardar.
Cualquiera
Registro de prompts
El registro de 26 columnas. Las fórmulas y el protocolo de pruebas están en la misma carpeta.
Cualquiera
Plantilla de ficha de contenido
Una ficha de contenido que empieza por la respuesta.
Cualquiera
Script de informe de bots
Cuenta los accesos de bots de IA de un registro y comprueba cada IP con los rangos publicados.
Cualquiera
Expresión regular de fuentes de IA de GA4
La expresión regular más estricta para un grupo de canales personalizado.
Cualquiera
Fragmento de head de HTML
Metaetiqueta robots y marcado data-nosnippet.
Cualquiera
Ping a IndexNow
Un comando de ping por lotes, con un ejemplo de archivo de clave en la misma carpeta.
Cualquiera
Los archivos de cada plataforma están enlazados en la sección correspondiente más arriba. Todos usan valores de ejemplo, como example.com, claves de muestra y nombres de muestra. Sustituya cada uno antes de desplegar y ejecute el paso de comprobación de la sección correspondiente.
Próximos pasos
Empiece por la lista de verificación de autoauditoría anterior y corrija el primer punto que falle, que suele ser el acceso de los bots o el HTML del servidor. Si prefiere que el trabajo lo hagamos y lo verifiquemos en su propio sitio, Maxenius realiza auditorías e implementación de SEO con IA y GEO. Comprobamos el acceso de los rastreadores, el renderizado, los datos estructurados y la medición según los pasos de esta guía, e informamos de lo que cambió con pruebas. Nadie puede garantizar citas de IA, por lo que no las ofrecemos.
Reservar una auditoría de búsqueda con IASi el trabajo es un desarrollo, también hacemos desarrollo en Shopify, desarrollo en WordPress y desarrollo de software a medida. La documentación de los proveedores cambia con frecuencia. Vuelva a revisar cada mes las fuentes que figuran a continuación.
Fuentes y fechas
Todas abiertas y comprobadas el 7 de octubre de 2026. Los títulos de las fuentes se mantienen en su idioma original (inglés).
- Google Search Console Help, What are impressions, position, and clicks
- Google Search Console Help, Generative AI performance report
- Google Search Console Help, Search generative AI control
- Google Search Console Help, Search Console annotations
- Google Search Central Blog, Introducing Search Generative AI performance reports
- Google Search Central, AI features and your website
- Google, Google’s common crawlers
- Google, Verify requests from Google crawlers and fetchers
- Google Analytics Help, What’s new in Google Analytics, Default channel group, Custom channel groups, About regular expressions
- Microsoft Bing Webmaster Blog, Introducing AI Performance in Bing Webmaster Tools Public Preview
- Microsoft Bing Webmaster Tools Help, AI Performance FAQ
- Microsoft Bing Search Blog, New AI Visibility Insights in Bing Webmaster Tools
- OpenAI, Overview of OpenAI Crawlers
- OpenAI Help Center, Publishers and Developers FAQ, Temporary chat
- Anthropic, Does Anthropic crawl data from the web
- Perplexity, Perplexity Crawlers
- IndexNow.org, Documentation and FAQ
- Vercel, WAF Managed Rulesets, Firewall Observability, Runtime Logs
- Cloudflare, Managed robots.txt
- Plausible, Top referrers
- Ahrefs, Brand Radar
- Semrush, AI Visibility Toolkit