KI & SEO
KI-Suche optimieren (GEO): Anleitung und Vorlagen
Veröffentlicht · Zuletzt aktualisiert
Auf dieser Seite
Diese Anleitung zeigt Ihnen, wie Sie eine Website so einrichten, dass KI-Suchprodukte sie finden, verstehen und zitieren können, mit konkreten Schritten für jede Plattform und einer Prüfung nach jedem Schritt. Sie richtet sich an Website-Betreiber, Marketingverantwortliche und Entwickler, die die Arbeit selbst erledigen wollen. Niemand kann eine Zitierung in ChatGPT, Perplexity, Claude oder Google garantieren, und Google sagt, dass die Optimierung für generative KI-Suche weiterhin SEO ist. Ein kostenloses Starterpaket mit Dateien zum Kopieren finden Sie am Ende.
Das Wichtigste in Kürze
- Lassen Sie die richtigen Bots herein. Suchbots entscheiden, ob Sie zitiert werden können, Trainingsbots nicht, und Ihr CDN oder Ihre Firewall kann die robots.txt aushebeln.
- Legen Sie die Antwort in serverseitig gerendertes HTML. Mehrere große KI-Crawler führten bei der letzten Messung kein JavaScript aus, testen Sie deshalb mit einfachem curl.
- Schreiben Sie Abschnitte mit der Antwort zuerst: ein Thema pro URL, unter jeder Überschrift eine direkte Antwort, ausdrückliche Fakten.
- Strukturierte Daten müssen zum sichtbaren Text passen. Für die KI-Funktionen von Google ist kein besonderes Schema nötig.
- llms.txt ist optional, und die Google-Suche ignoriert sie. Sie ist günstig zu haben, kümmern Sie sich also erst nach den Grundlagen darum.
- Messen Sie mit den Werkzeugen der Anbieter (Search Console, Bing Webmaster Tools, GA4) und wiederholen Sie Ihre Prompt-Tests über die Zeit.
Sie sind unsicher, welche Plattform zu Ihrem Unternehmen passt? Lesen Sie zuerst WordPress oder Shopify.
Was ist GEO?
Generative Engine Optimization (GEO) bedeutet, Ihre Seiten so aufzubereiten, dass KI-Suchprodukte sie leicht finden, verstehen und zitieren können. Answer Engine Optimization (AEO) ist ein überlappender Begriff für dieselbe Arbeit, und für keinen der beiden gibt es eine einheitliche Definition, wie der Wikipedia-Eintrag festhält. Google ordnet es dem SEO zu, während die Bing Webmaster Guidelines den Begriff GEO verwenden und ausdrücklich sagen, dass er weder Grounding noch Zitierungen garantiert.
Wie generative Engines Quellen finden, auswählen und zitieren
Jede Engine folgt ungefähr demselben Weg, auch wenn die Details je nach Anbieter abweichen.
- Crawlen: Googlebot (speist auch AI Overviews und AI Mode); Bingbot (Bing, Copilot, Grounding-API); OAI-SearchBot; Claude-SearchBot; PerplexityBot
- Indexieren: Google: indexiert und snippet-fähig; Bing: Copilot nutzt Crawl, Index und Ranking mit; ChatGPT: Suchanbieter von Drittanbietern plus OAI-SearchBot; Perplexity: Websuche in Echtzeit
- Frage erweitern: Google: Query Fan-out; ChatGPT: Umformulierung der Anfrage
- Passagen abrufen und auswählen: Google: Grounding aus dem Suchindex; Copilot: zerlegt Seiten in kleinere Abschnitte; Grenzen: nosnippet, max-snippet, data-nosnippet, Bing NOARCHIVE und NOCACHE
- Antwort erzeugen und zitieren: Google: Links zu belegenden Seiten; Perplexity: nummerierte Quellenangaben; ChatGPT: Quellenangaben; Bing: gezählte Quellenangaben
- Messen: Search Console Bericht zu generativer KI (nur Impressionen); Search Console Leistung (KI-Klicks unter Web); Bing AI Performance; GA4 utm_source=chatgpt.com; Server-Logs
Trainings-Bots sind getrennt: GPTBot, ClaudeBot, Google-Extended (nur Token). Durch Nutzer ausgelöste Abrufe: ChatGPT-User, Claude-User, Perplexity-User.
1. Crawlen. Bots müssen die Seite erreichen. Die KI-Übersichten und der KI-Modus von Google nutzen das normale Search-Crawling, der Crawler von Bing speist Copilot, die ChatGPT-Suche stützt sich auf OAI-SearchBot, die Claude-Suche auf Claude-SearchBot und Perplexity auf PerplexityBot.
2. Indexieren. Google sagt, eine Seite müsse indexiert und snippet-fähig sein, weitere Anforderungen gebe es nicht. Bing sagt, Copilot teile sich dasselbe Fundament aus Crawling, Index und Ranking. OpenAI sagt, ChatGPT schicke umformulierte Anfragen an Suchanbieter von Drittanbietern und nutze zusätzlich den eigenen Crawler.
3. Die Frage auffächern. Der Leitfaden von Google beschreibt Query Fan-out, bei dem verwandte Teilanfragen abgesetzt werden. OpenAI sagt, ChatGPT formuliere einen Prompt in eine oder mehrere gezielte Anfragen um.
4. Passagen abrufen und auswählen. Google ruft mit seinen zentralen Ranking-Systemen ab. Microsoft sagt, Copilot zerlege Seiten in kleinere Teile, sodass wichtige Angaben in Tabs, Bildern oder PDFs übersprungen werden können.
5. Generieren und zitieren. Perplexity versieht seine Antworten mit nummerierten Quellenangaben. OpenAI sagt, eine Platzierung in der ChatGPT-Suche sei nicht garantiert.
Danach wird gemessen, was am Ende behandelt wird. Wenn Sie speziell an ChatGPT arbeiten, lesen Sie unseren Leitfaden zum Ranking bei ChatGPT, und zum übergeordneten Thema unseren Leitfaden zur Answer Engine Optimization.
Trainingsbots, Suchbots und nutzerausgelöste Abrufe
Jeder Anbieter trennt sein Crawling nach Zweck. Die praktische Regel: Wer ein Trainings-Token blockiert, verschwindet damit nicht aus der KI-Suche dieses Anbieters, wer einen Suchbot blockiert, schon.
| Anbieter | Suche und Antworten | Modelltraining | Nutzerausgelöster Abruf |
|---|---|---|---|
| OpenAI | OAI-SearchBot | GPTBot | ChatGPT-User |
| Anthropic | Claude-SearchBot | ClaudeBot | Claude-User |
| Perplexity | PerplexityBot | Nicht für Training genutzt | Perplexity-User |
| Googlebot (Suche, KI-Übersichten, KI-Modus) | Google-Extended-Token (Gemini-Training und Grounding) | Nutzerausgelöste Abrufe von Google | |
| Apple | Applebot | Applebot-Extended-Token | Keine dokumentiert |
| Microsoft | Bingbot (Bing und Copilot) | Kein eigenes Token; Meta-Tags NOARCHIVE und NOCACHE | Keine dokumentiert |
Quellen: OpenAI, Anthropic, Perplexity, Google, Apple, Bing. Geprüft am 7. Oktober 2026.
SEO, AEO und GEO im Vergleich
| SEO | AEO | GEO | |
|---|---|---|---|
| Was man darunter versteht | Sichtbarkeit in klassischen Suchergebnissen gewinnen | Die Antwort in Featured Snippets, Sprachassistenten und KI-Antworten sein | Innerhalb generierter Antworten zitiert werden |
| Wo die Antwort erscheint | Rangierte Links | Antwortboxen und Assistenten | KI-Übersichten, KI-Modus, ChatGPT, Copilot, Perplexity, Claude |
| Was Sie steuern | Crawlbarkeit, Inhalte, Links, Seitenerlebnis | Inhalte mit der Antwort zuerst und klare Struktur | Dieselben Stellschrauben, plus Bot-Zugang und Klarheit über die Organisation |
| Was Sie messen | Impressionen, Klicks, Rankings | Präsenz in Snippets und Antworten | Zitierungen, Impressionen in KI-Berichten, Referral-Sitzungen |
| Einschränkung | Rankings verändern sich | Die Begriffe überlappen mit SEO | Keine einheitliche Definition, keine garantierten Zitierungen |
Google sagt, die Optimierung für generative KI-Suche sei weiterhin SEO. Betrachten Sie die drei Begriffe als Umfang, nicht als verschiedene Disziplinen.
Sechs Mythen, die Sie vor dem Start ablegen sollten
Die Grundlagen, die jede Plattform braucht
Diese sechs Schritte gelten für jeden Stack. Die späteren Plattformabschnitte zeigen, wo sie sich jeweils in WordPress, Shopify, React, Next.js und Astro finden.
1. Die richtigen Bots hereinlassen: robots.txt und Ihr CDN
SchritteSuchbots den Zugang öffnen
Ihre Linie festlegen
Vorlage A macht Sie in der KI-Suche sichtbar und schließt zugleich das Modelltraining aus. Vorlage B heißt alles willkommen, auch Trainings-Crawler, und ist die Linie, die maxenius.com für maximale Sichtbarkeit nutzt.
Die Datei schreiben und gemeinsame Regeln wiederholen
Ein Crawler befolgt nur die am genauesten passende Gruppe, und laut Googles Spezifikation werden benannte Gruppen und die Gruppe
*nicht kombiniert. Wiederholen Sie daher jede benötigte Disallow-Zeile in jeder benannten Gruppe.public/robots.txtVorlage A: in der KI-Suche sichtbar, Training ausgeschlossen User-agent: * Disallow: /api/ Disallow: /cart/ Allow: / User-agent: OAI-SearchBot User-agent: ChatGPT-User User-agent: Claude-SearchBot User-agent: Claude-User User-agent: PerplexityBot User-agent: Perplexity-User Disallow: /api/ Disallow: /cart/ Allow: / User-agent: GPTBot User-agent: ClaudeBot User-agent: Applebot-Extended User-agent: CCBot Disallow: / Sitemap: https://www.example.com/sitemap.xmlpublic/robots.txtVorlage B: maximale Sichtbarkeit, Trainings-Crawler eingeschlossen User-agent: * Disallow: /api/ Allow: / User-agent: OAI-SearchBot User-agent: ChatGPT-User User-agent: GPTBot User-agent: Claude-SearchBot User-agent: Claude-User User-agent: ClaudeBot User-agent: PerplexityBot User-agent: Perplexity-User User-agent: Google-Extended User-agent: Applebot-Extended Disallow: /api/ Allow: / Sitemap: https://www.example.com/sitemap.xmlDie Mechanik sauber halten
Setzen Sie Disallow-Zeilen vor
Allow: /, weil einfache Parser wie der robotparser von Python beim ersten Treffer aufhören. Liefern Sie pro Host genau eine Datei unter/robots.txtaus. Nach RFC 9309 bedeutet eine 5xx-Antwort, dass Crawler von einem Komplettverbot ausgehen, und ein 404, dass sie alles crawlen dürfen. Die robots.txt ist keine Zugriffskontrolle. OpenAI und Perplexity sagen beide, dass Änderungen etwa 24 Stunden zur Anwendung brauchen.Die Ebene über der robots.txt prüfen
OpenAI sagt, Ihr Host oder CDN müsse die veröffentlichten IP-Bereiche zulassen, und Perplexity dokumentiert WAF-Regeln, die User-Agent und IP-Listen kombinieren. Zwei Fallstricke: Seit dem 15. September 2026 blockiert Cloudflare Crawler mit gemischtem Zweck, darunter Googlebot, Applebot und BingBot, sobald ein Kunde die Blockade für Training aktiviert, und die verwaltete robots.txt setzt Disallow-Regeln voran, die auch Google-Extended umfassen. Bei Vercel blockiert das AI-Bots-Regelset auf „Deny“ auch Suchbots.
Funktion prüfenPrüfen, ob es funktioniert
Führen Sie
curl -s https://yourdomain.com/robots.txtaus und prüfen Sie, ob die Live-Datei zu Ihrem Repository passt, denn ein CDN kann sie umschreiben. Schauen Sie dann in den Server- oder CDN-Logs nach Antworten mit Status 200 an OAI-SearchBot, Claude-SearchBot, PerplexityBot und Bingbot. Wer mit curl einen User-Agent vortäuscht, testet nur User-Agent-Regeln, keine IP-basierten.
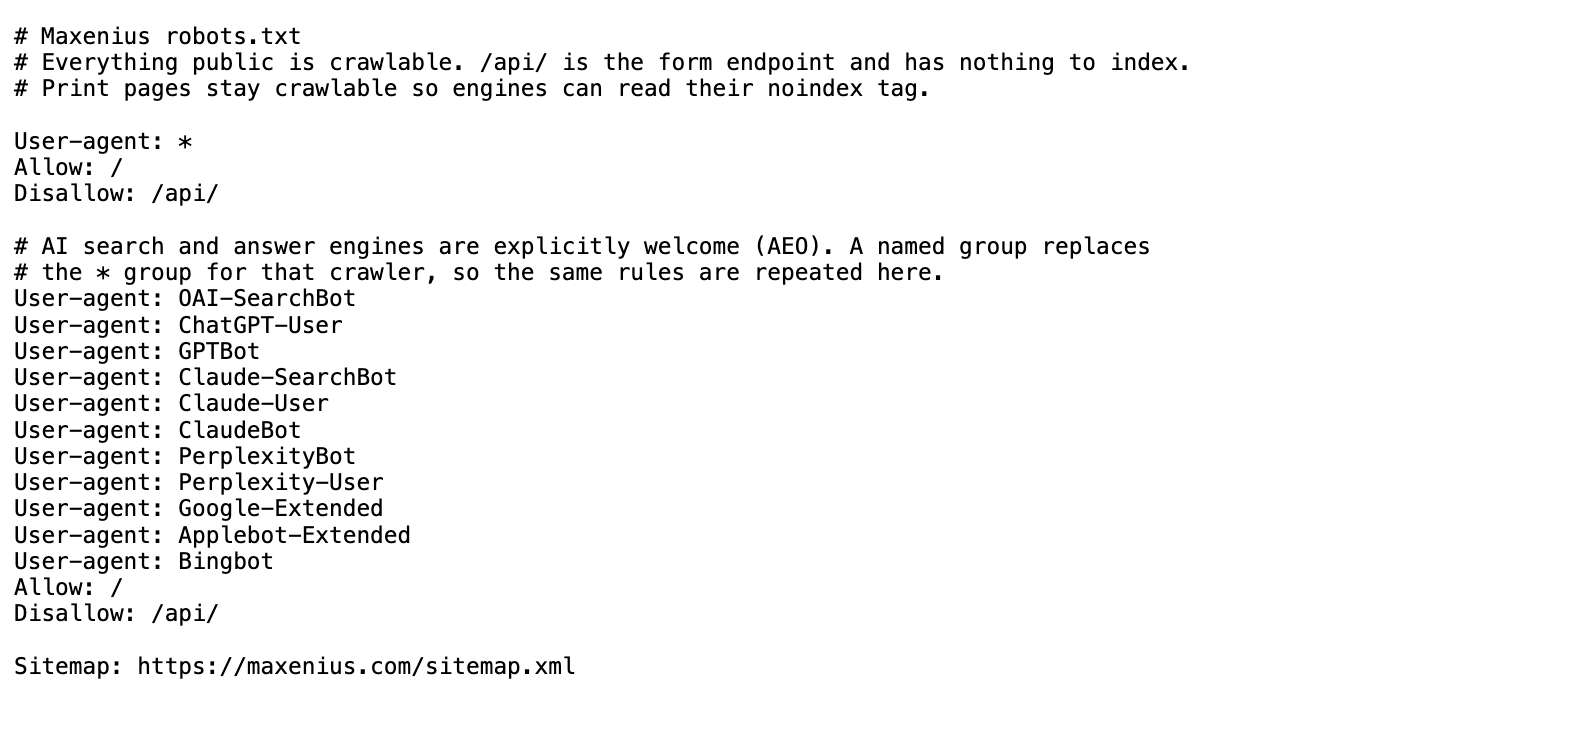
In voller Größe öffnen (neuer Tab)
robots.txt-Vorlagen A und B
Vorlage A: Suchbots erlaubt, Trainingsbots blockiert. Vorlage B, die Linie für maximale Sichtbarkeit, liegt im selben Ordner des Pakets.
Alle
2. Die Antwort in serverseitig gerendertes HTML legen
SchritteDie Seite ohne JavaScript lesbar machen
Zuerst die datierten Befunde lesen
Im Dezember 2024 stellten Vercel und MERJ fest, dass keiner der untersuchten großen KI-Crawler JavaScript rendert, abgesehen von Gemini über Googlebot und Applebot. Vercels Leitfaden von 2026, Make your site readable by AI agents, rät weiterhin, die Inhalte, die gelesen werden sollen, serverseitig zu rendern. Das sind datierte Befunde, kein Versprechen für jeden Crawler. OpenAI sagt nicht, ob OAI-SearchBot rendert, testen Sie also, statt etwas anzunehmen.
Das Wesentliche auf dem Server rendern
Titel, Haupttext, Canonical, JSON-LD und Navigationslinks sollten im ursprünglichen HTML stehen. Google sagt, nicht alle Bots führten JavaScript aus, auch wenn Googlebot es in der Regel tut.
Antworten nicht verstecken
Halten Sie wichtige Antworten aus geschlossenen Tabs, Bildern und PDFs heraus. Microsoft und Bing warnen beide davor, entscheidende Inhalte hinter clientseitigem Rendering zu verbergen.
Funktion prüfenPrüfen, ob es funktioniert
Rufen Sie die Seite so ab, wie es ein Crawler ohne Rendering tut, zum Beispiel mit dem Skript aus dem Paket:
./ai-bot-check.sh https://www.example.com/page "a sentence from the body". Jede Bot-Zeile sollte Status 200 zeigen, eine Wortzahl nahe an dem, was Sie im Browser sehen, und PHRASE = yes. Das Paket enthält zwei Skripte:ai-bot-check.shtestet sieben Bot-User-Agents, undcheck-ai-crawl.sh(im Abschnitt zu den Frameworks gezeigt) prüft einen Abruf auf Titel, Canonical und JSON-LD.
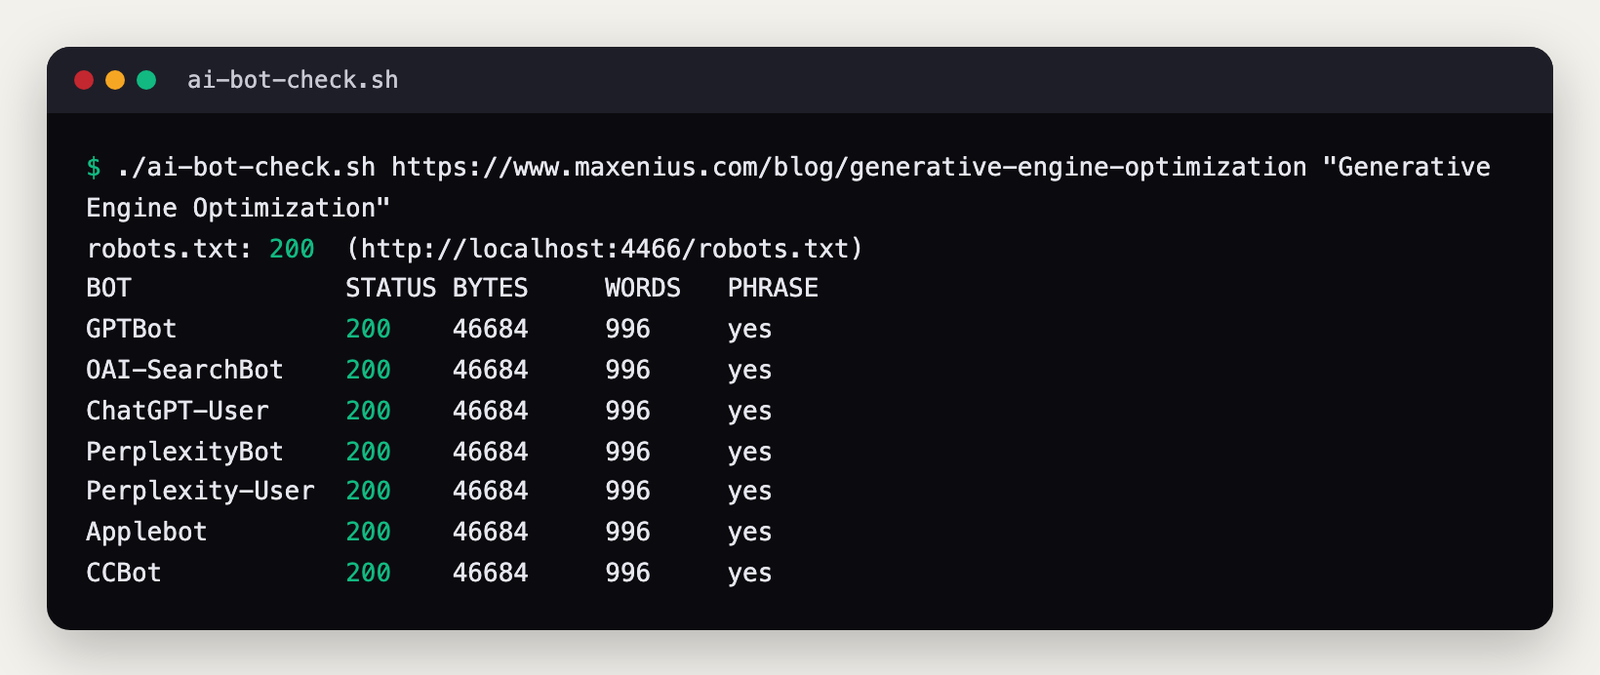
In voller Größe öffnen (neuer Tab)
3. Abschnitte mit der Antwort zuerst schreiben
SchritteJeden Abschnitt übernehmbar machen
Mit der Antwort beginnen
Setzen Sie die direkte Antwort in die ersten Sätze unter jeder Überschrift und formulieren Sie Überschriften konkret. Die Richtlinien von Bing raten, wichtige Informationen früh zu nennen und Fakten auf der URL ausdrücklich zu benennen.
Ein Thema pro URL, keine skalierten Seiten
Legen Sie nicht für jede Fan-out-Variante einer Anfrage eine Seite an. Google nennt das Scaled Content Abuse. Ergänzen Sie stattdessen Erfahrungswissen aus erster Hand und Details, die nicht Allgemeingut sind, statt wiederzugeben, was andere sagen.
Kein versteckter Text für Modelle
Bing behandelt Prompt Injection und versteckte Anweisungen für LLMs als Missbrauch, der eine Website abwerten oder aus dem Index nehmen kann. Google sagt, es gebe keine ideale Länge und keinen Zwang zur Zerlegung in Blöcke, schreiben Sie also für Menschen.
Funktion prüfenPrüfen, ob es funktioniert
Lesen Sie jeden H2-Abschnitt für sich. Wenn er seine eigene Überschrift beantwortet, ohne den Absatz davor zu brauchen, besteht er die Prüfung.
4. Strukturierte Daten, die zur Seite passen
SchritteMarkup ergänzen, das die Wahrheit sagt
Die Anforderung prüfen
Google sagt, für KI-Funktionen sei kein besonderes Schema nötig, und das Markup müsse zum sichtbaren Text passen. Verwenden Sie trotzdem Article oder BlogPosting, Organization, Product und BreadcrumbList, wo sie zutreffen.
JSON-LD verwenden, maskieren und Datumsangaben setzen
JSON-LD darf im Head oder im Body stehen, und Google liest per Skript eingefügtes JSON-LD, Crawler ohne JavaScript dagegen nicht. Wenn Sie JSON in ein Script-Tag serialisieren, ersetzen Sie jedes
<durch<(ein Backslash gefolgt von u003c), damit ein Wert mit schließendem Script-Tag den Block nicht vorzeitig beendet. Die React-, Next.js- und Astro-Beispiele unten tun das. Zeigen Sie ein sichtbares Datum an und setzen SiedatePublishedunddateModifiedpassend dazu, wie in Googles Hinweisen zur Autorenzeile beschrieben.FAQ-Schema als optional behandeln
Google hat das FAQ-Rich-Result am 7. Mai 2026 eingestellt. Behalten Sie FAQ-Markup nur, wenn es sichtbare Fragen abbildet, und rechnen Sie nicht mit zusätzlichem Platz in den Suchergebnissen.
Funktion prüfenPrüfen, ob es funktioniert
Rufen Sie den Seitenquelltext auf und prüfen Sie, ob das JSON-LD im rohen HTML steht. Führen Sie den Rich-Results-Test oder den Schema Markup Validator aus und vergleichen Sie dann jeden Wert mit dem, was Besucher sehen.
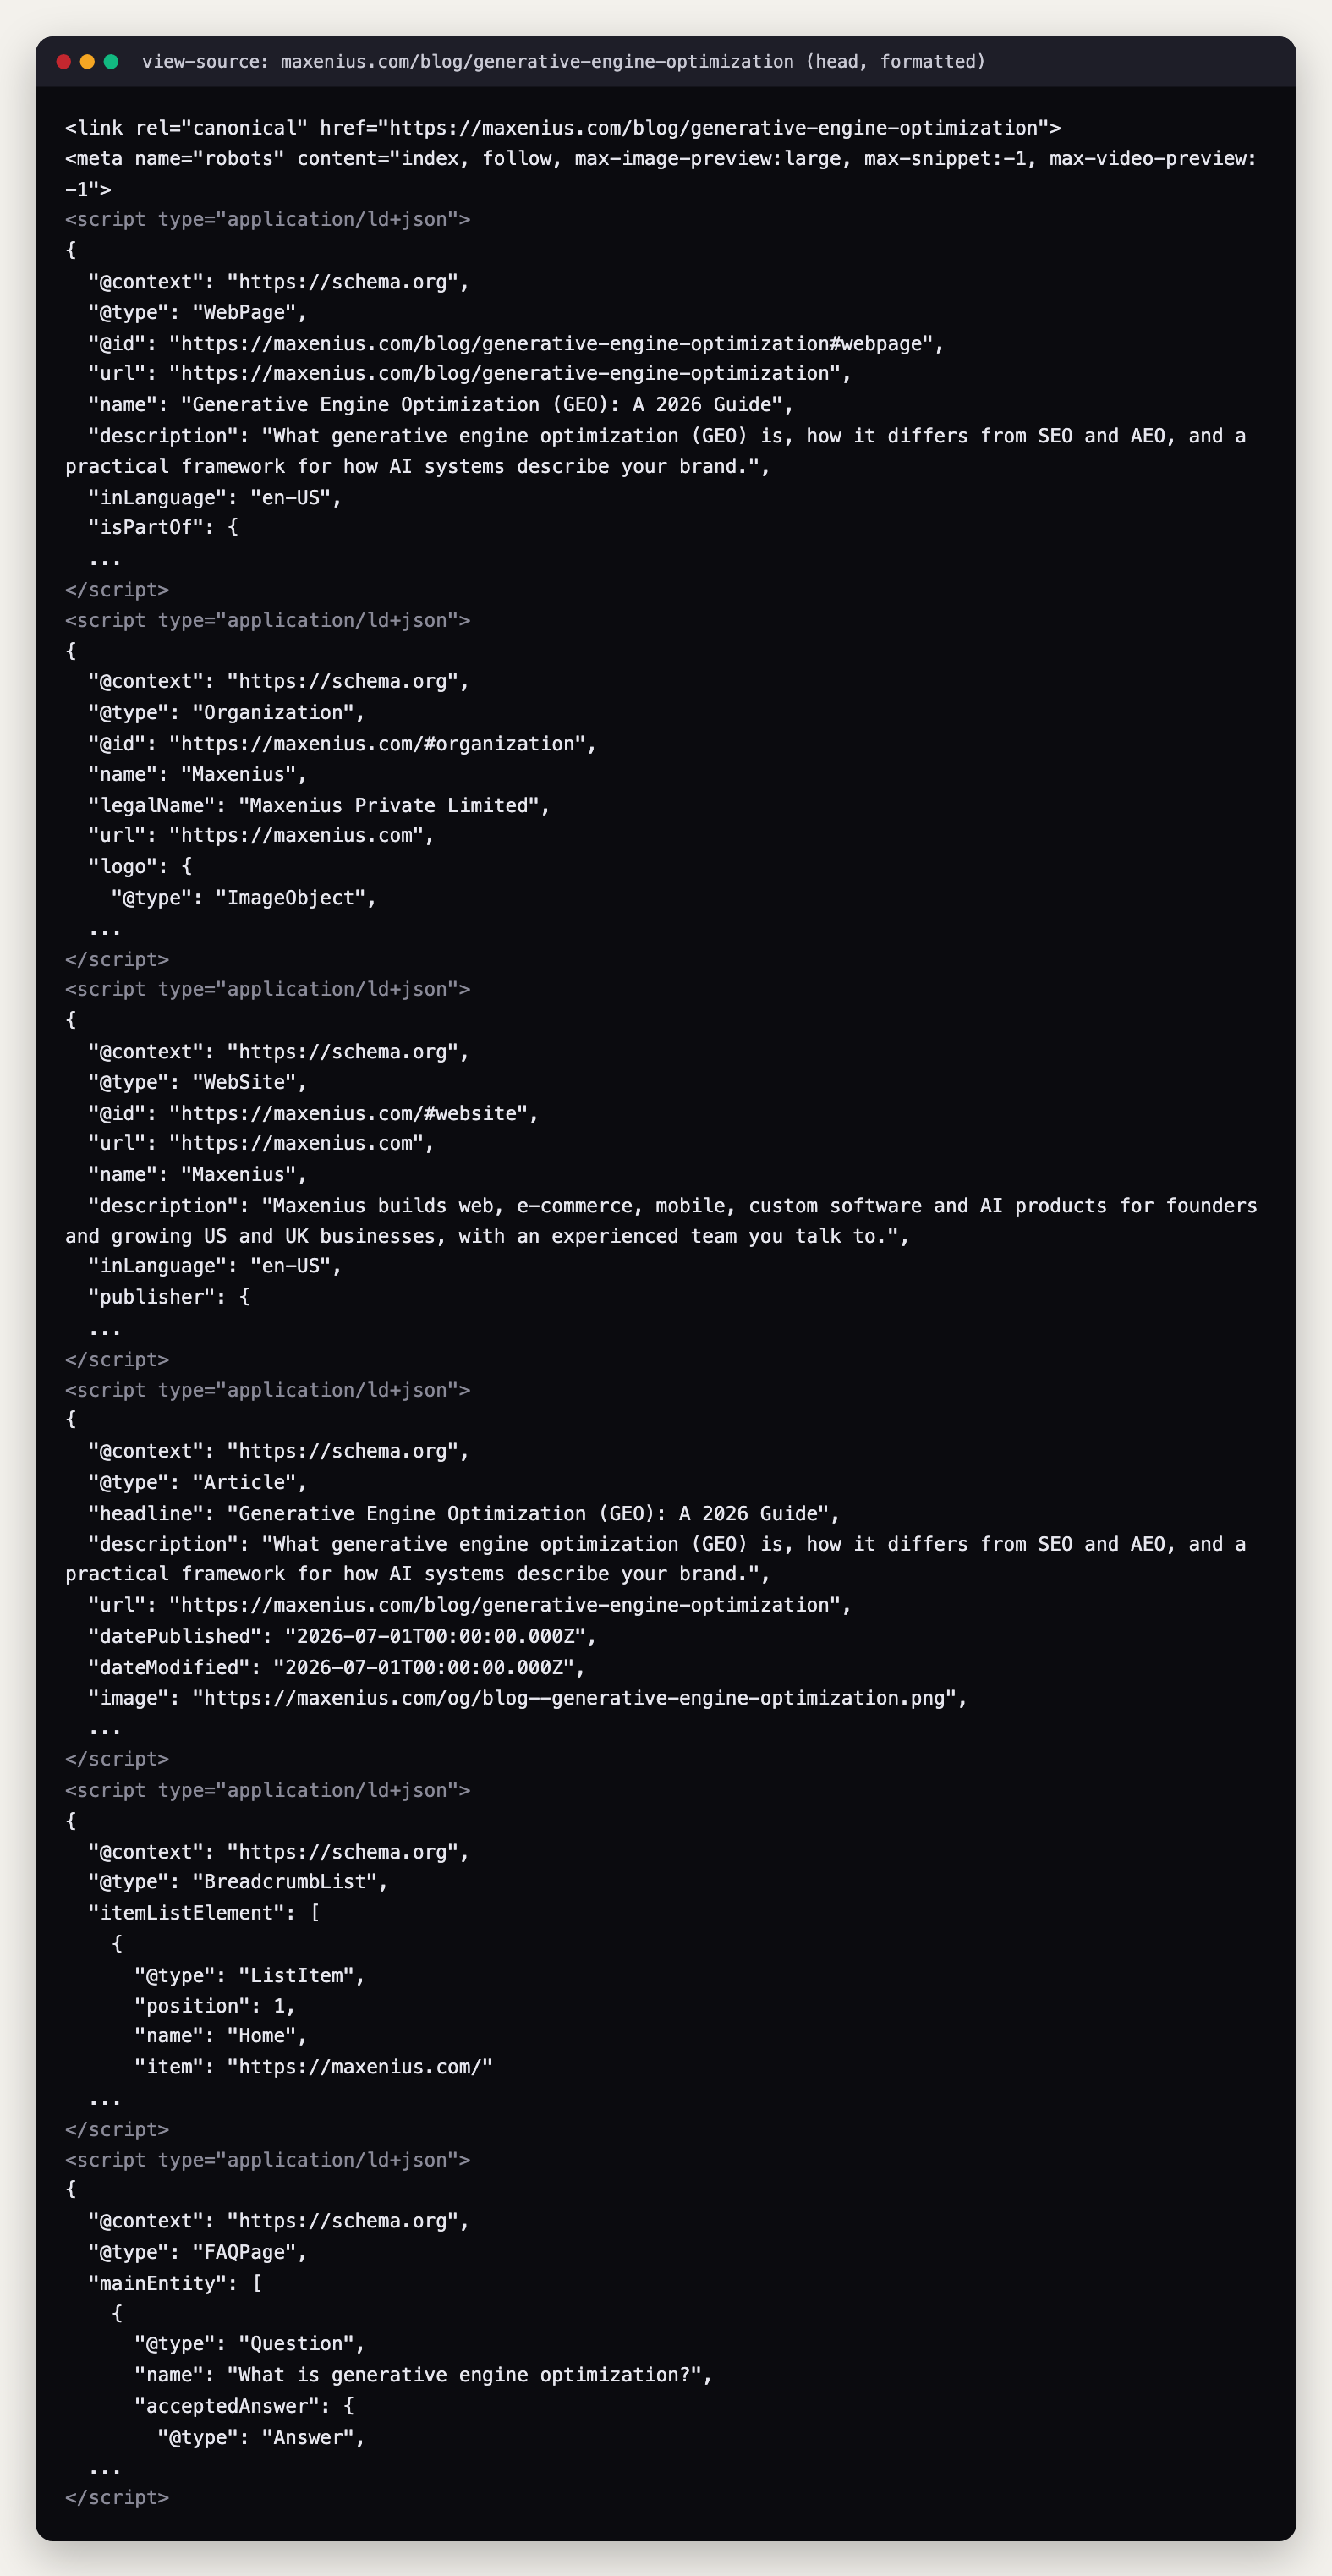
In voller Größe öffnen (neuer Tab)
5. Was ist llms.txt, und brauchen Sie eine?
llms.txt ist ein optionaler Vorschlag aus der Community: eine Markdown-Datei unter /llms.txt, die Ihre wichtigsten Seiten für KI-Werkzeuge auflistet. Google sagt, die Suche nutze sie nicht, Sie können also darauf verzichten, ohne etwas zu verlieren.
SchritteEntscheiden, ob Sie llms.txt veröffentlichen
Wissen, was llms.txt ist
llms.txt ist eine Markdown-Datei im Stammverzeichnis Ihrer Website, die Jeremy Howard am 3. September 2024 vorgeschlagen hat, mit einem im August 2026 veröffentlichten Format v2. Sie hat eine H1 (der einzige Pflichtteil), eine optionale Zusammenfassung als Zitatblock und H2-Abschnitte, die Links als
- [name](url): notesauflisten.Was sie heute leistet
Google sagt, die Suche profitiere davon weder, noch werde sie dadurch beeinträchtigt. In keinem der von uns geprüften Crawler-Dokumente von OpenAI, Anthropic, Perplexity, Bing, Apple oder Meta steht, dass deren Crawler sie lesen. Das Lighthouse von Chrome hat ein Audit für Agentic Browsing, das als „Nicht zutreffend“ markiert wird, wenn die Datei fehlt. Vercels Leitfaden von 2026 berichtet, dass llms.txt den Abruf nicht veränderte, wenn die Antwort bereits im Server-HTML stand, und dass 86 Prozent der zugeordneten Abrufe über Seitenlinks kamen.
Entscheiden, ob Sie sie veröffentlichen
Optional und günstig, machen Sie sie also nach den Grundlagen. Halten Sie sie klein.
llms-full.txtist eine Konvention, die manche Dokumentationsplattformen erzeugen, kein Teil der Spezifikation, und echte Dateien erreichen zig Megabyte. Die Standard-/llms.txtvon Shopify liefert Anweisungen für Agenten, wie im Shopify-Abschnitt beschrieben.public/llms.txtPlatzhalterangaben, Format v2 # Example Co > Example Co makes refillable cleaning products and sells them online to customers in the US and Canada. Key facts: - Free shipping on US orders over $50; returns accepted within 30 days. - Support: support@example.com, Monday to Friday. ## Products - [All products](https://www.example.com/collections/all): Full catalog with prices and stock status - [Refill subscriptions](https://www.example.com/pages/subscriptions): How refills are billed, paused and cancelled ## Policies - [Shipping policy](https://www.example.com/policies/shipping-policy): Carriers, delivery times and costs - [Refund policy](https://www.example.com/policies/refund-policy): Return window and how refunds are paidFunktion prüfenPrüfen, ob es funktioniert
Führen Sie
curl -sI https://yourdomain.com/llms.txtaus und erwarten Sie Status 200 mit einem Text-Content-Type. Fügen Sie dann nur die Datei in einen Assistenten ein und stellen Sie ihm Fragen zu Ihrem Unternehmen.
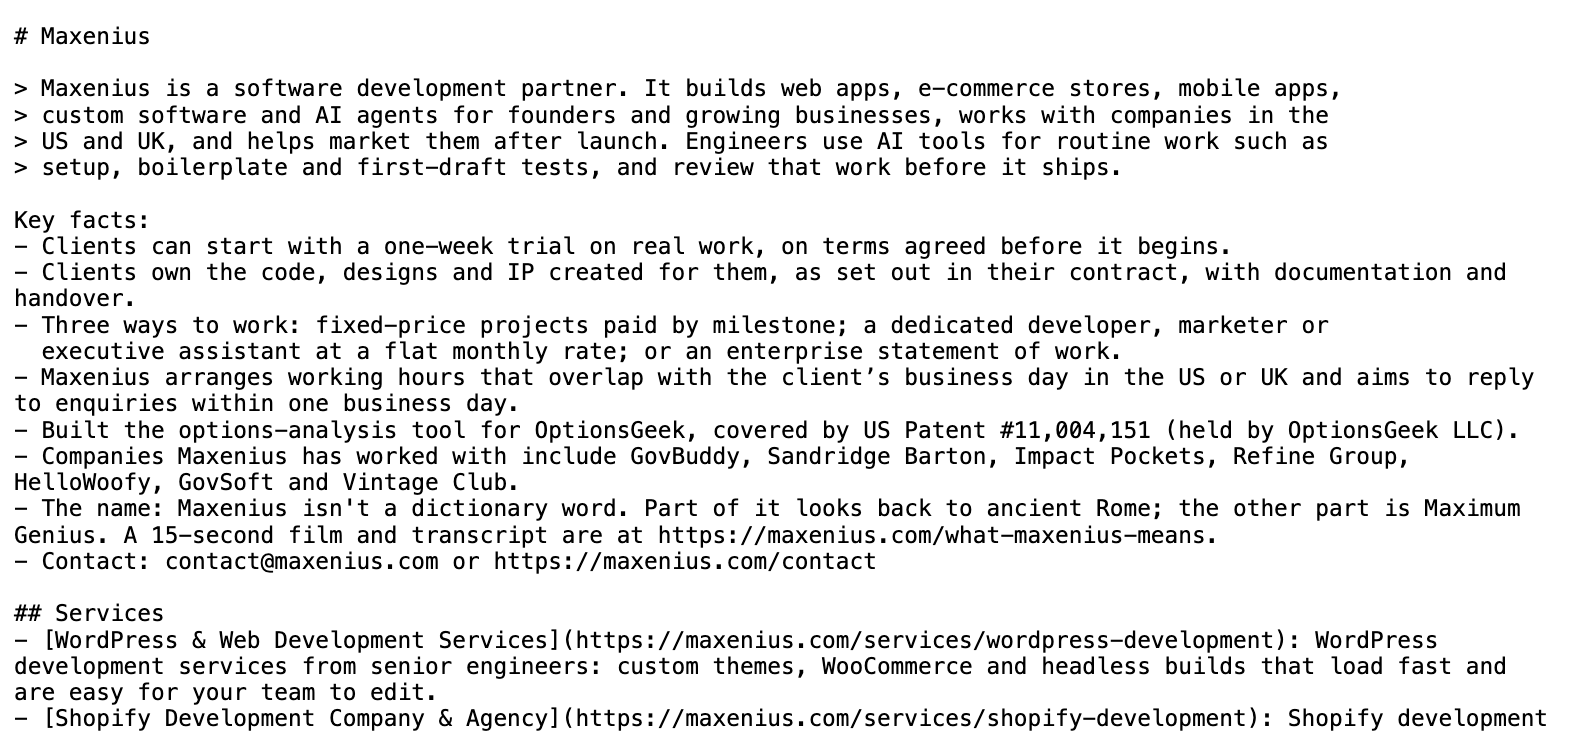
In voller Größe öffnen (neuer Tab)
llms.txt-Starter
Das Beispiel oben als Download, mit Platzhalterangaben zum Ersetzen.
Alle
6. Organisation und URLs konsistent halten
SchritteEinmal sagen, wer Sie sind, unter einer Adresse
Organization-Markup veröffentlichen
Fügen Sie auf der Startseite Organization-JSON-LD mit Name, URL, Logo, Beschreibung und
sameAs-Links zu Ihren echten Profilen hinzu, gemäß Googles Organization-Dokumentation. Verwenden Sie überall denselben Namen, wie es die Richtlinien von Bing verlangen, und halten Sie Daten in Business Profile, Bing Places und Merchant Center auf demselben Stand.Einen Host wählen
Ihr Canonical-Tag, die
loc-Werte der Sitemap und das Weiterleitungsziel müssen übereinstimmen. Google wertet Weiterleitungen und rel=canonical als starke Signale und die Sitemap als schwaches und rät davon ab, verschiedene URLs mit verschiedenen Methoden anzugeben. Bing weist darauf hin, dass LLMs nahezu doppelte Seiten bündeln und eine veraltete URL als Vertreter wählen können.lastmod aus echten Änderungen setzen
Ändern Sie
lastmodnur, wenn sich Hauptinhalt, strukturierte Daten oder Links ändern, nie auf die Build-Zeit. Google ignoriertpriorityundchangefreq, und Bing sagt dasselbe. Kombinieren Sie es mit einem sichtbaren Datum unddateModified.IndexNow für Bing anpingen
IndexNow benachrichtigt Bing und andere teilnehmende Suchmaschinen über Änderungen. Google nimmt nicht teil. Ein HTTP 200 bedeutet, dass Ihre URL empfangen wurde, nicht, dass sie indexiert ist.
Funktion prüfenPrüfen, ob es funktioniert
Führen Sie für jede Host-Variante
curl -sI https://example.com/page | grep -i -E '^HTTP/|^location'aus und vergleichen Sie dann das Weiterleitungsziel mit dem Canonical der Seite und ihrem Sitemap-Eintrag. Alle drei müssen dieselbe URL sein.
Organization-JSON-LD
Vorlage für Organisations-Markup mit Platzhalterwerten und sameAs-Links.
Alle
WordPress für die KI-Suche optimieren (und llms.txt ergänzen): Schritt für Schritt
Dieser Abschnitt funktioniert auf einer gewöhnlichen WordPress-Website mit oder ohne SEO-Plugin. Jeder Schritt endet mit einer einzeiligen Prüfung, und der letzte Schritt führt vier Terminalbefehle aus, die das gesamte Setup bestätigen.
Die Einstellungen Ihres SEO-Plugins finden
Die meisten der folgenden Entscheidungen hängen von dieser Tabelle ab. Suchen Sie zuerst Ihre Spalte und folgen Sie dann den Schritten.
| Yoast SEO | Rank Math | AIOSEO | |
|---|---|---|---|
| llms.txt | Kostenlos seit 25.3 (10. Juni 2025). Yoast SEO > Settings > Site features > AI tools > LLMS.txt. Schreibt eine physische Datei, wöchentlich aktualisiert. Yoast hat gesagt, sie sei bei Multisite nicht verfügbar (GitHub-Issue). | Seit 1.0.250 (31. Juli 2025). Modul unter Rank Math SEO > Dashboard aktivieren, dann Rank Math SEO > General Settings > Edit llms.txt. Leer, bis Sie sie konfigurieren. | Integriert, siehe das AIOSEO-Changelog. Enthält llms-full.txt und Markdown-Versionen von Beiträgen. All in One SEO > Sitemaps > Tab LLMs.txt. Standardmäßig aktiviert, als statische Datei geschrieben. |
| robots.txt-Editor | Yoast SEO > Tools > File editor > Create robots.txt file. Dies erstellt eine physische Datei. | Rank Math SEO > General Settings > Edit robots.txt. Virtuelle Datei; laut Rank Maths Wissensdatenbank verhindert eine physische Datei im Stammverzeichnis die Bearbeitung. | All in One SEO > Tools > Robots.txt Editor > Enable Custom Robots.txt. Enthält eine Option „Block AI Crawlers“. |
| Sitemap-URL | /sitemap_index.xml (die /wp-sitemap.xml des Cores wird ersetzt) | /sitemap_index.xml | Virtuelle Sitemap, verwaltet unter All in One SEO > Sitemaps |
| IndexNow | Nur Premium | Modul Instant Indexing | Integriert |
WordPress-Core liefert /wp-sitemap.xml von sich aus aus. Ohne SEO-Plugin deckt das offizielle IndexNow-Plugin IndexNow ab.
SchritteWordPress für die KI-Suche einrichten
Sicherstellen, dass der Inhalt im HTML steht
Öffnen Sie eine wichtige Seite, wählen Sie „Seitenquelltext anzeigen“ (nicht „Untersuchen“) und suchen Sie nach einem Satz aus dem Haupttext. Oder führen Sie
curl -s https://example.com/page/ | grep -i "a sentence from the page"aus. Themes und gängige Page Builder rendern auf dem Server, Inhalte in AJAX-Tabs, Slidern und „Mehr laden“-Widgets sind dort aber womöglich nicht enthalten.Stellen Sie sicher, dass die Navigation echte
<a href>-Links nutzt, denn Google kann nur so aufgebaute Links crawlen. Öffnen Sie dann Einstellungen > Lesen und prüfen Sie, dass „Sichtbarkeit für Suchmaschinen“ nicht aktiviert ist. Ist sie an, ergänzt aktuelles WordPress auf jeder Seite ein noindex-Robots-Meta, statt ein Disallow in der robots.txt zu setzen.Prüfung: Ihr Satz erscheint in der curl-Ausgabe, und
curl -s https://example.com/ | grep -i noindexliefert nichts.Die robots.txt selbst in die Hand nehmen
Ohne physische Datei baut WordPress eine virtuelle robots.txt und leitet sie durch den Filter
robots_txt. Eine physische robots.txt im Web-Root überschreibt diesen Filter und jeden Plugin-Editor aus der Tabelle, und der File editor von Yoast erstellt genau so eine Datei. Klären Sie, in welcher Situation Sie sind, bevor Sie etwas bearbeiten.Wenn Sie eine eigene KI-Gruppe wollen, nutzen Sie das mu-plugin geo-robots.php unten. Es wiederholt die Admin-Regeln innerhalb der Gruppe, denn nach RFC 9309 befolgt ein Crawler, der eine Gruppe mit seinem Namen findet, nur diese Gruppe.
Lassen Sie „Block AI Crawlers“ von AIOSEO und den Bot blocker von Yoast Premium ausgeschaltet, wenn Sie Sichtbarkeit in der KI-Suche wollen. Liegt die Website hinter Cloudflare, prüfen Sie dessen verwaltete robots.txt, die Disallow-Regeln oberhalb Ihrer Datei ergänzt.
Prüfung:
curl -s https://example.com/robots.txtzeigt die erwarteten Regeln. OpenAI sagt, Änderungen können etwa 24 Stunden brauchen, bis sie die ChatGPT-Suche erreichen.Entscheiden, welche Bots Sie zulassen
Such- und Zitierbots sind OAI-SearchBot, Claude-SearchBot und PerplexityBot. Trainingsbots wie GPTBot und ClaudeBot sind eine eigene Entscheidung, und ihr Blockieren entfernt Sie nicht aus der Suche des jeweiligen Anbieters. Die vollständige Anbietertabelle steht im Grundlagenabschnitt.
Prüfung: Kein Bot, den Sie in der Suche haben wollen, wird in einer Disallow-Gruppe genannt.
llms.txt aus nur einer Quelle veröffentlichen
Wählen Sie die Plugin-Funktion aus der Tabelle oder nutzen Sie geo-llms-txt.php, wenn Sie kein Plugin haben. Setzen Sie nie zwei ein. Yoast überschreibt keine vorhandene Datei, und eine statische Datei kann eine dynamische eines anderen Plugins überdecken.
Der Nutzen ist ungewiss, wie im llms.txt-Abschnitt beschrieben. Auch die Dokumentation von Rank Math sagt, die Verbreitung sei begrenzt. Sie kostet wenig, betrachten Sie sie also als aufgeräumtes Inhaltsverzeichnis Ihrer besten Seiten.
Prüfung:
curl -sI https://example.com/llms.txtliefert 200, und der Body beginnt mit# Your site name.Strukturierte Daten über Ihr Plugin ergänzen
Fügen Sie keinen zweiten Organization-Block ein. Yoast gibt einen verknüpften @graph aus und stellt Filter wie
wpseo_schema_organizationbereit (Schema API). Legen Sie Name, Logo und Profile zuerst unter Yoast SEO > Settings > Site representation fest. Rank Math erlaubt es, den Publisher überrank_math/json_ldzu erweitern. Ohne Plugin nutzen Sie geo-schema.php.Prüfung:
curl -s https://example.com/ | grep -c 'application/ld+json', fügen Sie dann jeden Block in validator.schema.org ein und prüfen Sie, dass es genau einen Organization-Knoten gibt.Autoren- und Organisationsangaben ergänzen
Füllen Sie Benutzer > Profil aus (Anzeigename, biografische Angaben, Website), denn SEO-Plugins lesen die Autorendaten von dort. Laut Article-Hinweisen von Google enthält
author.namenur den Namen, undauthor.urlverweist auf eine Seite, die den Autor eindeutig identifiziert. Für das Unternehmen gehört das Organization-Markup auf die Startseite oder die Über-uns-Seite, empfohlen werden name, url, logo, sameAs und Kontaktangaben.Prüfung: Die Autorenzeile eines Beitrags verlinkt auf eine Autorenseite, und der Seitenquelltext zeigt im Article-JSON-LD denselben Namen.
Mit aussagekräftigen Ankertexten intern verlinken
Verlinken Sie von jeder Hub-Seite (Leistungen, Kategorie, Leitfaden) auf Detailseiten, mit Ankertext, der das Ziel beschreibt. „Unsere Checkliste zur WooCommerce-Einrichtung“ sagt einem Crawler mehr als „Weiterlesen“.
Prüfung: Jede wichtige Seite hat mindestens einen Textlink von einer anderen Seite.
Einen Sitemap-Generator verwenden
Nutzen Sie Core, Yoast, Rank Math oder AIOSEO, nicht mehrere. Reichen Sie die URL in der Google Search Console und in den Bing Webmaster Tools ein. Bing wünscht sich genaue lastmod-Werte im ISO-8601-Format mit Datum und Uhrzeit.
Prüfung: Die Sitemap-URL aus der Tabelle lässt sich laden, und lastmod ändert sich nur, wenn Sie eine Seite tatsächlich bearbeiten.
IndexNow aktivieren, mit einem Sender
Wählen Sie das offizielle IndexNow-Plugin, Instant Indexing von Rank Math, AIOSEO oder Yoast Premium. Zwei gleichzeitig führen zu doppelten Übermittlungen. IndexNow teilt übermittelte URLs mit allen teilnehmenden Suchmaschinen.
Prüfung: Veröffentlichen Sie einen Testbeitrag und suchen Sie ihn in der Liste der letzten Übermittlungen des Plugins.
WooCommerce-Produktdaten vervollständigen
Füllen Sie für jedes Produkt Produktdaten > Inventar > Artikelnummer (SKU) und das Feld „GTIN, UPC, EAN oder ISBN“ aus und schreiben Sie eine echte Kurzbeschreibung. WooCommerce 11.1.2 gibt Product-JSON-LD mit sku, gtin, offers und Bewertungen aus und lässt sich mit
woocommerce_structured_data_producterweitern. Die Filterdatei unten ergänzt eine Marke. Gibt auch ein SEO-Plugin Product aus, vergleichen Sie die beiden Blöcke.Für WooCommerce trunk ist Markup für OnlineStore und MerchantReturnPolicy in einer späteren Version geplant (markiert mit 11.3.0), es ist in 11.1.2 also nicht enthalten.
Prüfung: Rufen Sie den Quelltext einer Produktseite auf und prüfen Sie, dass es genau einen Product-Knoten mit Ihrer GTIN gibt.
Funktion prüfenAlles im Terminal prüfen
Ersetzen Sie Domain und Phrase und führen Sie dann alle vier Befehle aus:
curl -s https://example.com/robots.txtzeigt Ihre vorgesehenen Gruppen und eine Sitemap-Zeile.curl -sI https://example.com/llms.txtliefert 200 und text/plain.curl -s https://example.com/ | grep -c 'application/ld+json'liefert die Zahl der erwarteten Blöcke.curl -s https://example.com/some-page/ | grep -i "a sentence from the body"findet Ihren Text.
Code zum Einfügen
Legen Sie diese Dateien in wp-content/mu-plugins/ ab. WordPress lädt dort PHP-Dateien der obersten Ebene automatisch. Jede Datei ist auch im Starterpaket enthalten.
<?php
/**
* Plugin Name: GEO robots.txt rules
* Description: Adds an explicit group for AI search crawlers to the virtual robots.txt.
*/
defined( 'ABSPATH' ) || exit;

add_filter(
'robots_txt',
function ( $output, $is_public ) {
	if ( ! $is_public ) {
		return $output;
	}
	$admin_path = wp_parse_url( admin_url(), PHP_URL_PATH );
	$ajax_path  = wp_parse_url( admin_url( 'admin-ajax.php' ), PHP_URL_PATH );
	// A crawler that finds a group naming it obeys only that group (RFC 9309).
	$bots  = array( 'OAI-SearchBot', 'ChatGPT-User', 'Claude-SearchBot', 'Claude-User', 'PerplexityBot', 'Perplexity-User' );
	$group = "\n# AI search and answer crawlers\n";
	foreach ( $bots as $bot ) {
		$group .= 'User-agent: ' . $bot . "\n";
	}
	$group .= 'Disallow: ' . $admin_path . "\n";
	$group .= 'Allow: ' . $ajax_path . "\n";
	return $output . $group;
},
99,
2
);
Ausgabe, nach dem Core-Standard angehängt:
# AI search and answer crawlers
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Perplexity-User
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php<?php
/**
* Plugin Name: GEO llms.txt
* Description: Serves /llms.txt (llmstxt.org format) without an SEO plugin.
* A physical llms.txt in the web root wins over this code.
*/
defined( 'ABSPATH' ) || exit;
const GEO_LLMS_REWRITE_VERSION = '1';
add_action( 'init', function () {
add_rewrite_rule( '^llms\.txt$', 'index.php?geo_llms_txt=1', 'top' );
// mu-plugins have no activation hook, so flush once per rule version.
if ( get_option( 'geo_llms_rewrite_version' ) !== GEO_LLMS_REWRITE_VERSION ) {
flush_rewrite_rules( false );
update_option( 'geo_llms_rewrite_version', GEO_LLMS_REWRITE_VERSION );
}
} );
add_filter( 'query_vars', function ( $vars ) {
$vars[] = 'geo_llms_txt';
return $vars;
} );
// Priority 0 runs before redirect_canonical (priority 10).
add_action( 'template_redirect', function () {
if ( ! get_query_var( 'geo_llms_txt' ) ) {
return;
}
$body = get_transient( 'geo_llms_txt_body' );
if ( false === $body ) {
$body = geo_llms_build();
set_transient( 'geo_llms_txt_body', $body, 12 * HOUR_IN_SECONDS );
}
status_header( 200 );
header( 'Content-Type: text/plain; charset=utf-8' );
echo $body; // phpcs:ignore WordPress.Security.EscapeOutput.OutputNotEscaped
exit;
}, 0 );
add_action( 'save_post', function () {
delete_transient( 'geo_llms_txt_body' );
} );
function geo_llms_build() {
$clean = function ( $text ) {
$text = wp_strip_all_tags( html_entity_decode( (string) $text, ENT_QUOTES, 'UTF-8' ) );
return trim( preg_replace( '/\s+/', ' ', $text ) );
};
$lines = array( '# ' . $clean( get_bloginfo( 'name' ) ), '' );
$tagline = $clean( get_bloginfo( 'description' ) );
if ( '' !== $tagline ) {
$lines[] = '> ' . $tagline;
$lines[] = '';
}
$sections = array(
'Pages' => array( 'post_type' => 'page', 'orderby' => 'menu_order title', 'order' => 'ASC' ),
'Articles' => array( 'post_type' => 'post', 'orderby' => 'modified', 'order' => 'DESC' ),
);
if ( post_type_exists( 'product' ) ) {
$sections['Products'] = array( 'post_type' => 'product', 'orderby' => 'modified', 'order' => 'DESC' );
}
foreach ( $sections as $heading => $args ) {
$posts = get_posts( array_merge( $args, array(
'post_status' => 'publish', 'posts_per_page' => 50, 'has_password' => false, 'suppress_filters' => false,
) ) );
if ( ! $posts ) {
continue;
}
$lines[] = '## ' . $heading;
$lines[] = '';
foreach ( $posts as $post ) {
$summary = $clean( has_excerpt( $post ) ? get_the_excerpt( $post ) : wp_trim_words( strip_shortcodes( $post->post_content ), 30, '' ) );
$title = str_replace( array( '[', ']' ), array( '(', ')' ), $clean( get_the_title( $post ) ) );
$line = sprintf( '- [%s](%s)', $title, esc_url_raw( get_permalink( $post ) ) );
if ( '' !== $summary ) {
$line .= ': ' . $summary;
}
$lines[] = $line;
}
$lines[] = '';
}
return implode( "\n", $lines );
}Diese Version kennt keine noindex-Markierungen einzelner Beiträge aus SEO-Plugins, ein weiterer Grund, sie nur auf Websites ohne ein solches Plugin einzusetzen.
<?php
defined( 'ABSPATH' ) || exit;

function geo_print_jsonld( array $data ) {
echo '<script type="application/ld+json">'
	. wp_json_encode( $data, JSON_UNESCAPED_SLASHES | JSON_UNESCAPED_UNICODE | JSON_HEX_TAG )
	. "</script>\n";
}

// Organization on the front page (edit the values).
add_action( 'wp_head', function () {
if ( ! is_front_page() ) {
	return;
}
geo_print_jsonld( array(
	'@context'     => 'https://schema.org',
	'@type'        => 'Organization',
	'@id'          => home_url( '/#organization' ),
	'name'         => get_bloginfo( 'name' ),
	'url'          => home_url( '/' ),
	'logo'         => get_site_icon_url( 512 ),
	'description'  => get_bloginfo( 'description' ),
	'sameAs'       => array( 'https://www.linkedin.com/company/your-company' ),
	'contactPoint' => array( '@type' => 'ContactPoint', 'contactType' => 'sales', 'email' => 'hello@example.com' ),
) );
} );

// FAQPage from a "geo_faqs" custom field: [{"q":"...","a":"..."}]. Mark up only visible FAQs.
add_action( 'wp_head', function () {
if ( ! is_singular() ) {
	return;
}
$faqs = json_decode( (string) get_post_meta( get_queried_object_id(), 'geo_faqs', true ), true );
if ( ! is_array( $faqs ) || ! $faqs ) {
	return;
}
$entities = array();
foreach ( $faqs as $faq ) {
	if ( empty( $faq['q'] ) || empty( $faq['a'] ) ) {
		continue;
	}
	$entities[] = array(
		'@type'          => 'Question',
		'name'           => wp_strip_all_tags( $faq['q'] ),
		'acceptedAnswer' => array( '@type' => 'Answer', 'text' => wp_kses_post( $faq['a'] ) ),
	);
}
if ( $entities ) {
	geo_print_jsonld( array( '@context' => 'https://schema.org', '@type' => 'FAQPage', 'url' => get_permalink(), 'mainEntity' => $entities ) );
}
} );<?php
defined( 'ABSPATH' ) || exit;
// Yoast SEO: extend the Organization piece from Settings > Site representation.
add_filter( 'wpseo_schema_organization', function ( $data ) {
$data['description'] = 'One plain sentence on what the company does and for whom.';
$data['email'] = 'hello@example.com';
return $data;
} );
// Rank Math: the publisher entity lives at $data['publisher'].
add_filter( 'rank_math/json_ld', function ( $data, $jsonld ) {
if ( isset( $data['publisher'] ) && is_array( $data['publisher'] ) ) {
$data['publisher']['description'] = 'One plain sentence on what the company does and for whom.';
}
return $data;
}, 99, 2 );
// WooCommerce core Product markup: add a brand.
add_filter( 'woocommerce_structured_data_product', function ( $markup, $product ) {
$markup['brand'] = array( '@type' => 'Brand', 'name' => get_bloginfo( 'name' ) );
return $markup;
}, 10, 2 );geo-robots.php
Gruppe für KI-Crawler in der virtuellen robots.txt.
WordPress
geo-llms-txt.php
llms.txt ohne SEO-Plugin.
WordPressWooCommerce
geo-schema.php
Organization- und FAQ-JSON-LD ohne SEO-Plugin.
WordPress
geo-schema-plugin-filters.php
Filter für Yoast, Rank Math und WooCommerce.
WordPressWooCommerce
Wenn Sie praktische Unterstützung wünschen, sehen Sie sich unser Team für WordPress-Entwicklung an.
Shopify für die KI-Suche und ChatGPT optimieren: Schritt für Schritt
Shopify erledigt bereits den Großteil der technischen Arbeit. Stand 7. Oktober 2026 liefert jeder Shop eine automatische sitemap.xml, die sich nicht bearbeiten lässt, eine Standard-robots.txt und JSON-LD aus dem Filter structured_data in den Themes Dawn und Horizon. Seit dem 28. Mai 2026 liefert außerdem jeder Shop Standarddateien unter /agents.md, /llms.txt und /llms-full.txt aus, laut Shopify-Changelog.
Eine Grenze gilt: Nichts hier garantiert, dass ChatGPT, Copilot oder Gemini Ihre Produkte anzeigen. Shopify sagt, die Optimierung der Produktdaten erhöhe die Chancen, nicht, dass sie sie sicherstelle.
SchritteEinen Shopify-Shop für die KI-Suche einrichten
Prüfen, was Ihr Shop bereits ausliefert
Öffnen Sie diese vier URLs in Ihrem Shop und notieren Sie, was Sie sehen:
/robots.txt,/llms.txt,/agents.mdund/sitemap.xml.Erwarten Sie nicht, dass Ihre robots.txt der eines anderen Shops gleicht. Am 7. Oktober 2026 sahen wir bei neueren Shops einen Standard, dessen Kommentare Agenten auf
/agents.mdverweisen, und bei anderen Shops weiterhin den älteren Standard mit zusätzlichen Gruppen für Werkzeuge wie Nutch, AhrefsBot und Pinterest. Beide lassen KI-Crawler unter*.Die Standard-
/llms.txtist eine Sammlung von Agentenanweisungen (UCP-Discovery, ein MCP-Endpunkt, schreibgeschützte JSON-Endpunkte, Links zu Richtlinien). Sie ist kein kuratierter Index Ihrer Inhalte. Lassen Sie dann eine Produkt-URL durch den Rich-Results-Test von Google laufen.Agentic Storefronts prüfen
Gehen Sie im Admin zu Sales channels > Agentic. Laut Shopify-Hilfe ist dies für berechtigte Shops standardmäßig aktiviert, und es setzt die Zustimmung zu den Agentic Storefronts Supplemental Terms voraus. Shopify listet derzeit ChatGPT, Microsoft Copilot, Google AI Mode und Gemini sowie Meta.
Was die einzelnen Kanäle brauchen:
- ChatGPT: Es ist ein Discovery-Referrer. Käufer schließen den Checkout in Ihrem eigenen Shop ab. Ihr Shop muss an Kunden in den USA verkaufen, kann aber anderswo ansässig sein.
- Copilot und Google: Beide bieten für berechtigte US-Shops einen von Shopify betriebenen Checkout im Chat, und beide setzen vollständige Shop-Richtlinien voraus. Google braucht außerdem ein Merchant-Center-Konto, mit Produkten, die über den Kanal Google & YouTube synchronisiert werden.
- Shopify Catalog: Laut der Anforderungsseite brauchen Sie den Tarif Starter oder höher und einen Shop, der nicht im privaten Modus ist. Jedes Produkt braucht einen Titel, mindestens ein Bild, einen Preis über null und die Veröffentlichung in einem Kanal mit URL. Nicht gelistete oder in der Suche versteckte Produkte qualifizieren sich nicht.
Nutzen Sie die Suchvorschau auf diesem Bildschirm. Sie bewertet jeden Eintrag nach Vollständigkeit der Beschreibung, Bildabdeckung, Bewertungen, Variantendaten und Richtlinien. Bis das Abschalten des ChatGPT-Katalogzugriffs wirkt, können bis zu 7 Tage vergehen.
Produktdaten korrigieren
Hier liegt der größte Gewinn. Shopifys Seite Optimizing products for AI platforms behandelt Titel, Beschreibung, Bilder, Typ, Anbieter, Kollektionen, Tags, Barcode, Namen der Variantenoptionen und Richtlinien. Die Punkte 1, 3, 4 und 9 unten sind unsere eigenen Empfehlungen, mit Quellen, wo wir welche haben:
- Titel: konkret, mit Produkttyp, wichtigstem Merkmal und Marke. Halten Sie den SEO-Titel bei etwa 60 Zeichen.
- Beschreibung: beantworten Sie, was Käufer fragen (Material, Maße, für wen geeignet, Pflege).
- Bilder: mehrere, jeweils mit beschreibendem Alt-Text.
- Kategorie: unter Products > (Ihr Produkt) > Category aus der Standard Product Taxonomy festlegen, dann die Kategorie-Metafelder ausfüllen.
- Typ, Anbieter, Kollektionen und Tags: alle vier ausfüllen.
- Barcode: ISBN, UPC oder GTIN bei jeder Variante, die einen hat.
- Namen der Variantenoptionen: „Größe“ und „Farbe“, nicht „Option 1“.
- Richtlinien: Rückerstattung, Datenschutz, Bedingungen und Versand, vollständig.
- Bewertungen: Die Suchvorschau zählt sie. Das Beispiel zu
structured_dataauf shopify.dev zeigt keinaggregateRating, prüfen Sie also das gerenderte JSON-LD Ihrer Bewertungs-App. - Knowledge-Base-App (optional): Sie prüfen automatisch erzeugte Shop-Fakten und schreiben FAQ-Antworten für KI-Plattformen. Shopify sagt, diese Antworten erschienen nicht in Ihrer Storefront, und die App ändere nicht, wie oft Sie in KI-Ergebnissen erscheinen.
llms.txt mit einem Theme-Template anpassen (optional)
Gehen Sie zu Online Store > Themes > … > Edit code und fügen Sie im Ordner
templatesein Template hinzu. Laut den Dokumenten zu agents.md.liquid decktagents.md.liquidalle drei URLs ab,llms.txt.liquidnur diese eine. Shopify sucht das pfadspezifische Template, dannagents.md.liquid, dann den eigenen Standard.In diesen Templates gibt es nur die Objekte
requestundagents. Sie können nicht über Kollektionen oder Artikel iterieren, schreiben Sie Ihre Links also von Hand und halten Sie sie aktuell. Lassen Sie die UCP- und MCP-Zeilen überagents.*dynamisch, statt sie fest einzutragen, und geben Sie nie private Daten wie E-Mail-Adressen oder Telefonnummern aus.Weiterleitungen, Dateien und App-Proxys funktionieren für diese Datei nicht. URL-Weiterleitungen greifen nur bei defekten URLs, und
/llms.txtliefert jetzt 200. Hochgeladene Dateien werden nicht aus dem Stammverzeichnis ausgeliefert. App-Proxys funktionieren nur unter/a,/apps,/communityund/tools. Das Template ist der unterstützte Weg.Betrachten Sie diese Datei als Entgegenkommen für Agenten, nicht als Ranking-Hebel, denn die Google-Suche nutzt llms.txt nicht.
robots.txt.liquid nur anfassen, wenn Sie den Zugang ändern müssen
Gehen Sie zu Online Store > Themes > … > Edit code > Add a new template > robots > Create template. Shopify bezeichnet dies als nicht unterstützt, der Support kann dabei nicht helfen, und es warnt, dass ein Fehler Sie den gesamten Traffic kosten kann. Kopieren Sie zuerst Ihre aktuelle
/robots.txtan einen sicheren Ort. Das Löschen des Templates stellt den Standard wieder her.Behalten Sie die Standardschleife von Shopify bei und ergänzen Sie Klartext-Gruppen darum herum. Der übliche Grund ist der Ausschluss vom Modelltraining, zum Beispiel für GPTBot. OpenAI dokumentiert, dass GPTBot und OAI-SearchBot unabhängig sind, das Blockieren von GPTBot entfernt Sie also nicht aus der ChatGPT-Suche.
Fügen Sie keine
Allow-Gruppen hinzu, um KI-Bots willkommen zu heißen. Siehe den ersten Fallstrick unten.Product-Markup dem Theme überlassen und den Rest anreichern
Dawn 16.0.0 und Horizon geben bereits
{{ product | structured_data }}und{{ article | structured_data }}aus. Fügen Sie keinen zweiten handgeschriebenen Product-Block hinzu. Zwei Entitäten für ein Produkt widersprechen sich.Um Ihre Organization-Daten zu stärken, tragen Sie die Social-Media-Links unter Theme settings > Social media ein und laden Sie ein Logo hoch. Im Header von Dawn speisen diese
sameAs, und leere Einstellungen werden als leere Zeichenketten ausgegeben. Für eine sichtbare FAQ-Seite fügen Sie den Abschnittfaq-schema.liquidunten hinzu, mit dem Filter| jsonund nur für Fragen, die auf der Seite stehen.Inhalte veröffentlichen, die Käuferfragen beantworten
Schreiben Sie Kaufratgeber und Vergleiche unter Content > Blog posts und verlinken Sie sie mit Produkten und Kollektionen. Geben Sie jeder Kollektion eine echte Beschreibung mit eigenem SEO-Titel (Shopify empfiehlt bis zu 60 Zeichen) und einer Beschreibung von etwa 160 Zeichen. Legen Sie eine sichtbare FAQ auf einer Seite unter Online Store > Pages an und verlinken Sie sie dann aus Ihrer
llms.txt.liquid.Funktion prüfenPrüfen, ob es funktioniert
Führen Sie diese Befehle in einem Terminal aus und ersetzen Sie Domain und Produkt-Handle:
curl -sI https://yourstore.com/llms.txt | head -n 5sollte 200 zeigen, und ein GET sollte Ihren bearbeiteten Inhalt zeigen.curl -s https://yourstore.com/llms.txt | head -n 20sollte Ihre Überschriften und Links zeigen.curl -sI https://yourstore.com/agents.mdundcurl -sI https://yourstore.com/sitemap.xmlsollten beide 200 liefern.curl -s https://yourstore.com/robots.txtsollte unter*weiterhin die Disallows für Warenkorb und Checkout enthalten.curl -s https://yourstore.com/products/your-handle | grep -oE '"@type" ?: ?"(Product|ProductGroup)"' | sort | uniq -csollte eine Entität zeigen.Prüfen Sie danach die Agentic-Suchvorschau erneut.
Shopify-Code
Ihre templates/llms.txt.liquid. Ersetzen Sie den Platzhaltertext und die Seitenpfade durch Ihre eigenen:
# {{ agents.store_name }}

> Short, factual summary of what the store sells, who it is for, and where it ships.

## Key pages
- [All products]({{ agents.store_url }}/collections/all)
- [Best sellers]({{ agents.store_url }}/collections/best-sellers): our most ordered products
- [Size and fit guide]({{ agents.store_url }}/pages/size-guide)
- [FAQ]({{ agents.store_url }}/pages/faq): shipping, returns, care
- [Buying guides]({{ agents.store_url }}/blogs/guides)

## Policies
- [Refund policy]({{ agents.store_url }}/policies/refund-policy)
- [Shipping policy]({{ agents.store_url }}/policies/shipping-policy)

## For agents
- UCP discovery: {{ agents.ucp_discovery_url }}
- MCP endpoint: {{ agents.mcp_endpoint_url }}
- Sitemap: {{ agents.sitemap_url }}
- Prices are in {{ agents.currency }}.
Die robots.txt.liquid unten behält die Standardschleife von Shopify bei und ergänzt einen Ausschluss vom Training. Laut shopify.dev kommen Klartext-Gruppen für einen neuen Crawler außerhalb der Schleife:
{% for group in robots.default_groups %}
{{- group.user_agent }}
{%- for rule in group.rules -%}
  {{ rule }}
{%- endfor -%}
{%- if group.sitemap != blank -%}
  {{ group.sitemap }}
{%- endif -%}
{% endfor %}

User-agent: GPTBot
Disallow: /
Das Muster des Themes für strukturierte Daten. Es ist bereits in Dawn enthalten, Sie brauchen es also nur, wenn Sie ein eigenes Theme bauen:
<script type="application/ld+json">
{{ product | structured_data }}
</script>

<script type="application/ld+json">
{{ article | structured_data }}
</script>
Der Organization-Block aus sections/header.liquid von Dawn 16.0.0, wörtlich aus Shopify/dawn. Er dient als Referenz, Sie müssen ihn also nicht in ein unverändertes Dawn-Theme einfügen:
<script type="application/ld+json">
{
  "@context": "http://schema.org",
  "@type": "Organization",
  "name": {{ shop.name | json }},
  {% if settings.logo %}
    "logo": {{ settings.logo | image_url: width: 500 | prepend: "https:" | json }},
  {% endif %}
  "sameAs": [
    {{ settings.social_twitter_link | json }},
    {{ settings.social_facebook_link | json }},
    {{ settings.social_pinterest_link | json }},
    {{ settings.social_instagram_link | json }},
    {{ settings.social_tiktok_link | json }},
    {{ settings.social_tumblr_link | json }},
    {{ settings.social_snapchat_link | json }},
    {{ settings.social_youtube_link | json }},
    {{ settings.social_vimeo_link | json }}
  ],
  "url": {{ request.origin | append: page.url | json }}
}
</script>
Ein manueller FAQPage-Abschnitt für eine sichtbare FAQ-Seite. Der Fragetext ist ein Platzhalter: Ersetzen Sie ihn durch die genauen Fragen und Antworten, die auf der Seite stehen.
{%- comment -%} Add to the FAQ page template only {%- endcomment -%}
<script type="application/ld+json">
{
"@context": "https://schema.org",
"@type": "FAQPage",
"mainEntity": [
  {
    "@type": "Question",
    "name": {{ "How long does shipping take?" | json }},
    "acceptedAnswer": {
      "@type": "Answer",
      "text": {{ "Orders ship in 1 to 2 business days. US delivery takes 3 to 5 days." | json }}
    }
  }
]
}
</script>
Google hat das FAQ-Rich-Result entfernt, fügen Sie dies also nicht in der Erwartung von Sternen oder aufklappbaren Snippets hinzu. Das Markup beschreibt die Seite jedem Parser, der es liest, weiterhin korrekt.
llms.txt.liquid
Dynamisches llms.txt-Template für ein Shopify-Theme.
Shopify
robots.txt.liquid
Standardschleife beibehalten, plus Ausschluss vom Training.
Shopify
FAQ-Schema-Abschnitt
FAQPage-JSON-LD für eine sichtbare FAQ-Seite.
Shopify
React, Next.js und Astro: Schritt für Schritt
Bei eigenen Stacks zählt ein Fehler mehr als jede Datei, die Sie hinzufügen: Die Antwort fehlt im HTML, das der Server sendet. Prüfen Sie das zuerst, in jedem Framework, mit einem einzigen Test. Rufen Sie die Seite so ab, wie es ein Crawler tut, der kein JavaScript ausführt, und suchen Sie nach einem Satz aus dem Haupttext.
Prüfen Sie vor allem anderen, ob die Antwort im Server-HTML steht. Die Studie von Vercel und MERJ ergab, dass mehrere große KI-Crawler kein JavaScript rendern, und Vercels Folgeleitfaden von 2026 stellte fest, dass ein Client, der nur abruft, keine Antwort erhielt, die ausschließlich über JavaScript existierte. Daten und Details stehen in der Grundlage zum Server-HTML. Google sagt, serverseitiges Rendering oder Pre-Rendering sei weiterhin eine sehr gute Idee, und nennt Dynamic Rendering einen Workaround, keine Dauerlösung.
#!/usr/bin/env bash
# Usage: ./check-ai-crawl.sh https://www.example.com/your-page "a sentence from the page"
# Fetches the page the way a crawler that does not run JavaScript sees it.
# This only tests user-agent rules. Firewalls that verify crawler IPs will treat
# your request as an impostor, so confirm with server logs as well.
URL="$1"; PHRASE="$2"
UA='Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot'
HTML=$(curl -sL -A "$UA" "$URL")
HEAD=${HTML%%</head>*}
echo "Status:        $(curl -s -o /dev/null -w '%{http_code}' -A "$UA" "$URL")"
echo "Redirects to:  $(curl -s -o /dev/null -w '%{redirect_url}' -A "$UA" "$URL")"
echo "Title in head: $(grep -o '<title>[^<]*' <<<"$HEAD" | sed 's/<title>//' | head -1)"
echo "Canonical:     $(grep -o '<link rel="canonical"[^>]*' <<<"$HEAD" | grep -o 'href="[^"]*' | sed 's/href="//' | head -1)"
echo "JSON-LD blocks: $(grep -o 'application/ld+json' <<<"$HTML" | wc -l | tr -d ' ')"
if grep -qF "$PHRASE" <<<"$HTML"; then echo "Phrase in raw HTML: YES"; else echo "Phrase in raw HTML: NO (content likely needs JavaScript)"; fi
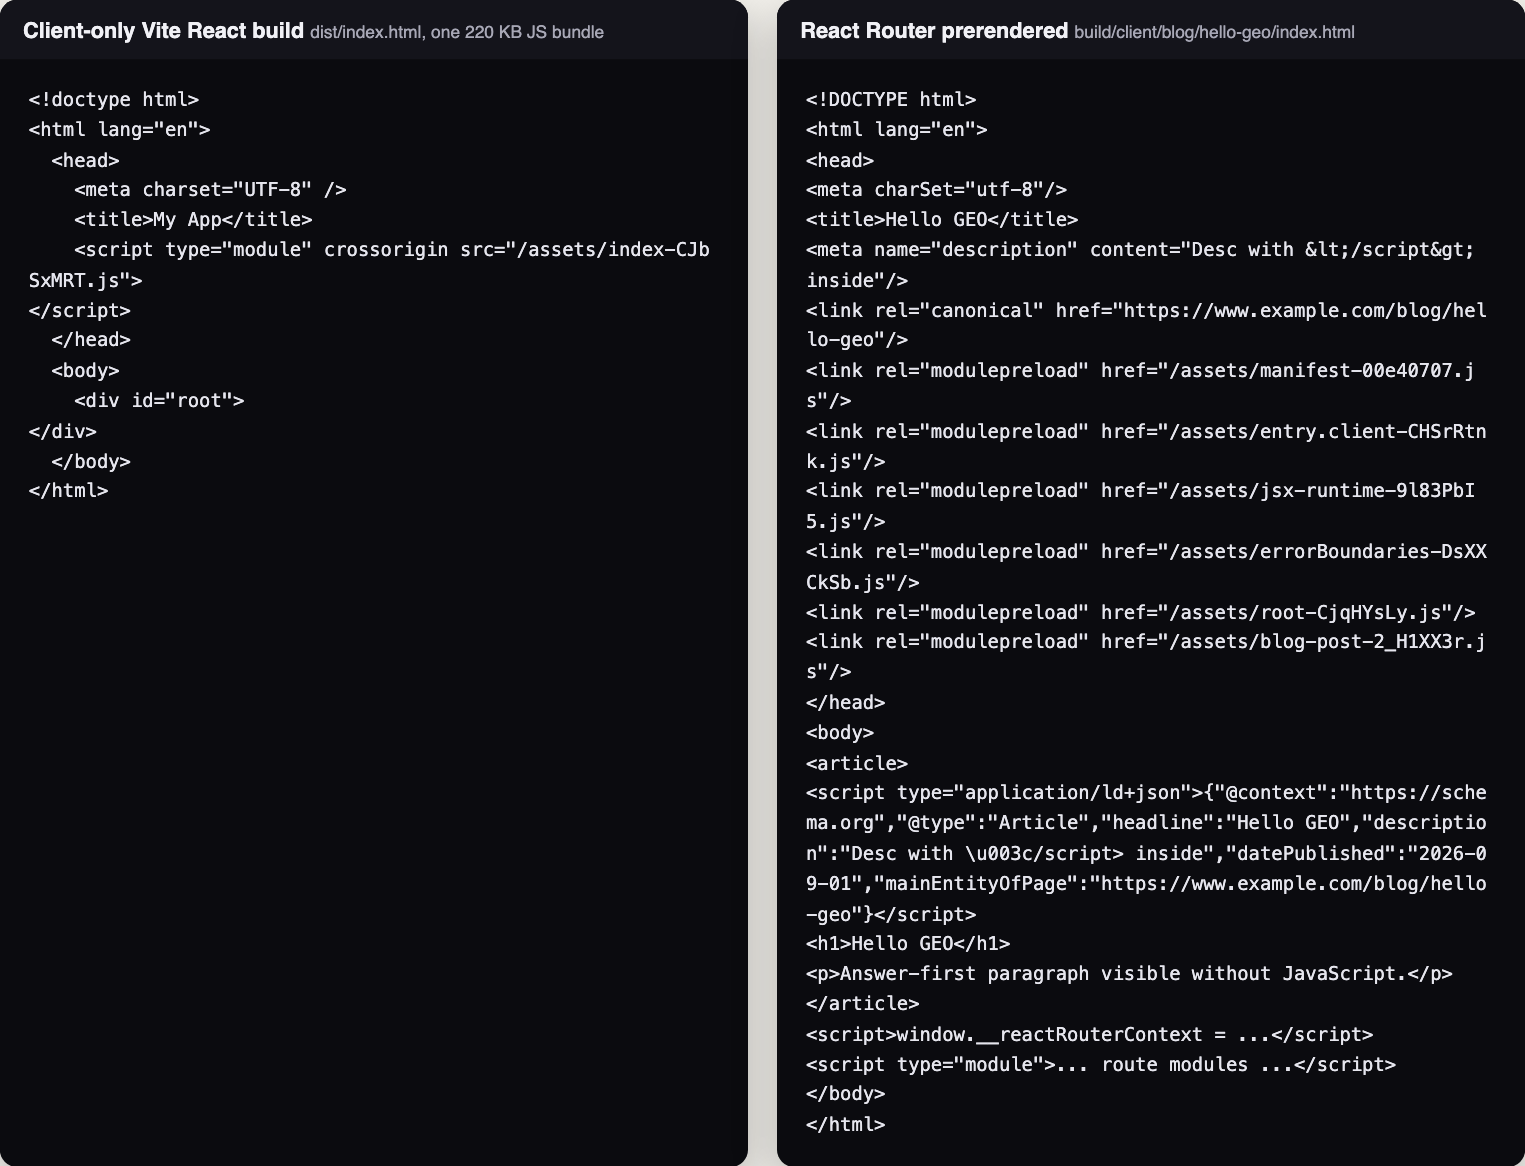
Wir haben es mit zwei Builds desselben Artikels ausgeführt. Die reine Client-App mit Vite lieferte ein leeres div id="root", den Titel „My App“ und kein JSON-LD. Der Text steckte in einem 220-KB-JavaScript-Bundle. Derselbe Inhalt, mit React Router vorab gerendert, lieferte den echten Titel, das Canonical, das JSON-LD und die Phrase.
In voller Größe öffnen (neuer Tab)
React-SEO für KI-Crawler: das HTML vorab rendern
Eine clientseitig gerenderte React-App kann in Google ranken und für andere Crawler trotzdem leer sein, weil Googlebot JavaScript rendert. Wer nur in Google testet, übersieht das Problem.
SchritteEine React-SPA ohne JavaScript lesbar machen
Mit dem Seitenquelltext diagnostizieren
Öffnen Sie Ihre wichtige Seite, wählen Sie „Seitenquelltext anzeigen“ (nicht DevTools) und suchen Sie Ihre Überschrift. Ein leeres
div id="root"bedeutet, dass Crawler ohne Rendering nichts erhalten. Führen Sie dann das obigecheck-ai-crawl.shaus und suchen Sie nach „Phrase in raw HTML: YES“.Eine Lösung wählen, in dieser Reihenfolge
- React Router im Framework-Modus mit
prerenderundssr: false. Die Dokumentation sagt, Pre-Rendering sei nützlich für SEO, besonders bei Deployments ohne serverseitiges Rendering. - Auf Next.js umsteigen, siehe den nächsten Abschnitt.
- Für eine inhaltsstarke Marketing-Website: Astro mit React-Islands.
- Ein eigenes Pre-Rendering mit
react-dom/static. Das funktioniert, ist aber low-level, und Frameworks rufen es normalerweise für Sie auf.
Verzichten Sie auf Dynamic Rendering. Create React App ist seit dem 14. Februar 2025 für neue Apps veraltet. Prüfen Sie die React-Router-Dokumentation für Ihre installierte Version, denn die Prerender-Optionen sind je Version dokumentiert.
- React Router im Framework-Modus mit
Jede Inhalts-URL vorab rendern, Slugs eingeschlossen
prerender: trueüberspringt dynamische Pfade wie/blog/:slug. Nutzen Sie die Funktionsform und ergänzen Sie die Slugs selbst.react-router.config.ts import type { Config } from '@react-router/dev/config' import { getPostSlugs } from './app/lib/posts' export default { // No runtime server: every listed URL becomes a static HTML file at build time. ssr: false, async prerender({ getStaticPaths }) { const slugs = await getPostSlugs() return [...getStaticPaths(), ...slugs.map((s) => '/blog/' + s)] }, } satisfies ConfigHead-Tags in die Route-Komponente setzen
React Router empfiehlt die eingebauten Elemente
title,metaundlinkstatt des Exportsmetades Route-Moduls. React 19 hebt sie in den Dokument-Head. In unserem Build landeten sie imheadder vorab gerenderten Datei. Fügen Sie JSON-LD in derselben Komponente hinzu und maskieren Sie<, dennJSON.stringifylässt</script>unverändert.app/routes/blog-post.tsx import { data, useLoaderData } from 'react-router' import { getPost } from '../lib/posts' const SITE_URL = 'https://www.example.com' // With prerendering, this loader runs at build time, so the post is in the HTML file. export async function loader({ params }: { params: { slug?: string } }) { const post = await getPost(params.slug ?? '') if (!post) throw data('Not found', { status: 404 }) return { post } } export default function BlogPost() { const { post } = useLoaderData<typeof loader>() const url = SITE_URL + '/blog/' + post.slug const article = { '@context': 'https://schema.org', '@type': 'Article', headline: post.title, description: post.description, datePublished: post.publishedAt, mainEntityOfPage: url, } return ( <article> <title>{post.title}</title> <meta name="description" content={post.description} /> <link rel="canonical" href={url} /> <script type="application/ld+json" dangerouslySetInnerHTML={{ __html: JSON.stringify(article).replace(/</g, '\u003c') }} /> <h1>{post.title}</h1> <p>{post.body}</p> </article> ) }Mit einem schmalen Fallback ausliefern
Liefern Sie
build/clientaus. Schreiben Sie nur Pfade, die Sie nicht vorab gerendert haben, auf__spa-fallback.htmlum. Diese Umschreibung antwortet bei jeder unbekannten URL mit 200, halten Sie Ihre Sitemap also exakt. In seinen Daten von 2024 sah Vercel, dass der Crawler von ChatGPT einen großen Teil seiner Abrufe auf 404-Seiten verbrachte, defekte oder verirrte URLs kosten Sie also etwas.Funktion prüfenPrüfen, ob es funktioniert
Das Build-Log sollte eine Zeile wie
Prerender (html): /blog/hello-geo -> build/client/blog/hello-geo/index.htmlausgeben. Öffnen Sie diese Datei, prüfen Sie, dass Titel, Canonical und Artikeltext darin stehen, und führen Sie danncheck-ai-crawl.shgegen die bereitgestellte URL aus. Sie wollenPhrase in raw HTML: YESsehen.
react-router.config.ts
Prerender-Konfiguration mit dynamischen Slugs.
React
Route für Blogbeiträge
Head-Tags und maskiertes JSON-LD in der Route-Komponente.
React
Next.js-SEO und llms.txt (App Router)
Next.js kann vollständiges HTML senden, aber man baut leicht eine Seite, die es nicht tut. Diese Schritte wurden mit Next.js 16.4.0 gebaut und getestet (die Dokumentation gilt für dieselbe Version).
SchritteAntworttext und Metadaten in der ersten Antwort ausliefern
Antworttext in Server Components halten
Seiten und Layouts sind standardmäßig Server Components. Client Components werden ebenfalls vorab gerendert, aber Daten, die in
useEffectgeladen werden, stehen nicht in diesem HTML. In unserem Test mit 16.4.0 lieferte eine'use client'-Seite, die ihren Text in einem Effect lud, HTML mit nur „Loading…“. Nutzen Sie Client Components für Interaktivität, nicht für die Antwort.Root-Metadaten mit metadataBase setzen
Exportieren Sie in
app/layout.tsxmetadatamitmetadataBase: new URL(SITE_URL), einem Titel-Template,alternates.canonicalundopenGraph. Metadata-Exporte funktionieren nur in Server Components.generateMetadata und generateStaticParams verwenden
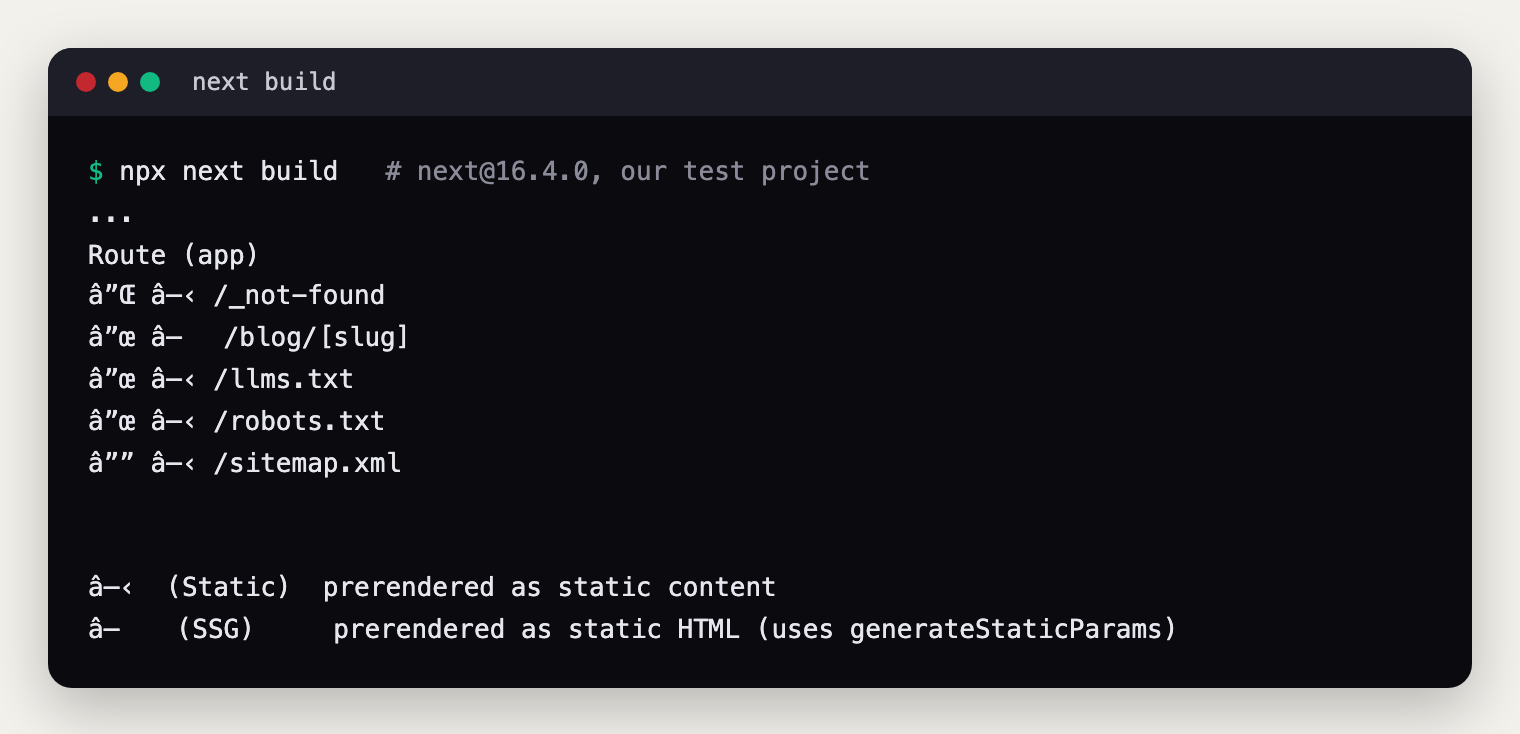
paramsist in aktuellen Versionen ein Promise. Wenn Beiträge vorab gerendert werden, stehen Metadaten und der vollständige Artikel im ursprünglichen HTML, und die Route erscheint in der Build-Tabelle als SSG.app/blog/[slug]/page.tsx import type { Metadata } from 'next' import { notFound } from 'next/navigation' import { getPost, getPosts } from '@/lib/posts' import { SITE_URL } from '@/lib/site' import { jsonLd } from '@/lib/json-ld' type Props = { params: Promise<{ slug: string }> } // Prerender every post at build time so the full article is in the HTML response. export async function generateStaticParams() { return (await getPosts()).map((p) => ({ slug: p.slug })) } export async function generateMetadata({ params }: Props): Promise<Metadata> { const { slug } = await params const post = await getPost(slug) if (!post) return {} return { title: post.title, description: post.description, alternates: { canonical: '/blog/' + post.slug }, } } export default async function Page({ params }: Props) { const { slug } = await params const post = await getPost(slug) if (!post) notFound() const article = { '@context': 'https://schema.org', '@type': 'Article', headline: post.title, datePublished: post.publishedAt, dateModified: post.updatedAt ?? post.publishedAt, mainEntityOfPage: SITE_URL + '/blog/' + post.slug, } return ( <article> <script type="application/ld+json" dangerouslySetInnerHTML={{ __html: jsonLd(article) }} /> <h1>{post.title}</h1> <div>{post.body}</div> </article> ) }JSON-LD als natives Script rendern, maskiert
Der JSON-LD-Leitfaden von Next.js sagt, man solle ein einfaches
script-Tag stattnext/scriptnutzen und<durch sein Unicode-Escape ersetzen, weilJSON.stringifynicht bereinigt. Legen Sie das in einen einzigen Helfer.lib/json-ld.ts // JSON.stringify does not escape "<", so "</script>" inside a value would end the tag early. export function jsonLd(data: object): string { return JSON.stringify(data).replace(/</g, '\u003c') }robots.ts mit wiederholten Disallows schreiben
app/robots.tsakzeptiert füruserAgentein Array. Ein Crawler befolgt nur die am genauesten passende Gruppe, wiederholen Sie also die Disallows. Behandeln Sie Trainings-Crawler als eigene Entscheidung, getrennt von Suchbots.app/robots.ts import type { MetadataRoute } from 'next' import { SITE_URL } from '@/lib/site' export default function robots(): MetadataRoute.Robots { return { rules: [ { userAgent: '*', allow: '/', disallow: ['/api/', '/account/'] }, { userAgent: [ 'OAI-SearchBot', 'ChatGPT-User', 'Claude-SearchBot', 'Claude-User', 'PerplexityBot', 'Perplexity-User', 'GPTBot', 'ClaudeBot', 'Google-Extended', ], allow: '/', disallow: ['/api/', '/account/'], }, ], sitemap: SITE_URL + '/sitemap.xml', } }sitemap.ts mit echtem lastModified schreiben
Google ignoriert priority und changefreq und nutzt lastmod nur, wenn es durchgehend korrekt ist. Nehmen Sie das Datum aus dem Inhalt, nie aus
new Date().app/sitemap.ts import type { MetadataRoute } from 'next' import { getPosts } from '@/lib/posts' import { SITE_URL } from '@/lib/site' export default async function sitemap(): Promise<MetadataRoute.Sitemap> { const posts = await getPosts() return [ { url: SITE_URL, lastModified: '2026-10-01' }, ...posts.map((p) => ({ url: SITE_URL + '/blog/' + p.slug, lastModified: p.updatedAt ?? p.publishedAt, })), ] }llms.txt über einen Route Handler ausliefern
GET-Route Handler werden standardmäßig nicht gecacht, ergänzen Sie also
force-static. Wenn SiecacheComponentsaktivieren, löschen Sie diese Zeile: Die Option entfällt in diesem Modus, und ein Handler, der keine Anfragedaten liest, wird vorab gerendert. Bauen Sie die Liste mit derselben Beitragsfunktion, die auch die Seiten nutzen.app/llms.txt/route.ts import { getPosts } from '@/lib/posts' import { SITE_NAME, SITE_URL } from '@/lib/site' // Delete this line if cacheComponents is enabled. export const dynamic = 'force-static' export async function GET() { const posts = await getPosts() const body = [ '# ' + SITE_NAME, '', '> One or two sentences: what you do, for whom, and where.', '', '## Guides', ...posts.map((p) => '- [' + p.title + '](' + SITE_URL + '/blog/' + p.slug + '): ' + p.description), '', ].join('\n') return new Response(body, { headers: { 'Content-Type': 'text/plain; charset=utf-8' } }) }Es gilt derselbe Vorbehalt wie zuvor: Diese Datei ergänzt das Server-HTML, sie ersetzt es nicht.
Routen zur Anfragezeit behandeln: die Falle htmlLimitedBots
Routen, die Cookies, Header oder ungecachte Daten lesen, werden zur Anfragezeit gerendert. Seit Next.js 15.2 wird die Ausgabe ihrer
generateMetadatafür jeden Bot, der nicht auf der Liste der HTML-limitierten Bots steht, in denbodygestreamt. Wir haben die Standardliste im Quellcode gelesen, und sie enthält keine KI-Crawler. In unserem Test mit 16.4.0 erhielten GPTBot und ClaudeBot dentitlestandardmäßig imbodyund nach unserer Ergänzung imhead.Das Setzen der Option ersetzt die Standardliste, kopieren Sie also den Standard und hängen Sie die KI-Bots an. Prüfen Sie die Kopie bei jedem Next.js-Upgrade neu. Vollständig vorab gerenderte Seiten sind nicht betroffen. Die Next.js-Dokumentation sagt, Streaming schade dem SEO nicht; diese Aussage betrifft Google, das JavaScript ausführt, übertragen Sie sie also nicht auf KI-Crawler.
next.config.ts import type { NextConfig } from 'next' // Copied from the Next.js default (canary html-bots.ts, October 2026). Re-check on upgrade. const NEXT_DEFAULT = String.raw`[\w-]+-Google|Google-[\w-]+|Chrome-Lighthouse|Slurp|DuckDuckBot|baiduspider|yandex|sogou|bitlybot|tumblr|vkShare|quora link preview|redditbot|ia_archiver|Bingbot|BingPreview|applebot|facebookexternalhit|facebookcatalog|Twitterbot|LinkedInBot|Slackbot|Discordbot|WhatsApp|SkypeUriPreview|Yeti|googleweblight` const AI_CRAWLERS = 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User' const nextConfig: NextConfig = { htmlLimitedBots: new RegExp(NEXT_DEFAULT + '|' + AI_CRAWLERS, 'i'), } export default nextConfigEntscheiden, ob Sie einen statischen Export brauchen
Mit
output: 'export'schreibt Next.js HTML nachout/, und Route Handler müssenforce-staticsein, um vorab gerendert zu werden. Das passt zu einer Visitenkarten-Website auf einfachem Speicher.Funktion prüfenPrüfen, ob es funktioniert
In der Routentabelle von
next buildsollten Ihre Inhaltsrouten als statisch oder SSG erscheinen, nicht als dynamisch. Rufen Sie dann/robots.txt,/sitemap.xmlund/llms.txtab (die letzte solltetext/plain; charset=utf-8liefern) und führen Siecheck-ai-crawl.shfür einen Beitrag aus. Ein unbekannter Slug sollte 404 liefern.
In voller Größe öffnen (neuer Tab)
App-Router-Metadaten und JSON-LD
generateMetadata, generateStaticParams und ein natives JSON-LD-Script.
Next.js
robots, Sitemap und llms.txt
robots.ts mit wiederholten Disallows. Die Routendateien für Sitemap und llms.txt liegen im selben Ordner.
Next.js
next.config.ts
htmlLimitedBots mit angehängten KI-Crawlern.
Next.js
Astro-SEO und llms.txt
Astro ist von den dreien am einfachsten, denn Seiten und Endpunkte werden standardmäßig beim Build vorab gerendert. Der Großteil der Arbeit besteht darin, Fehler zu vermeiden.
SchritteKI-lesbare Dateien zu einer Astro-Website hinzufügen
Antworttext aus client:only heraushalten
Komponenten ohne
client:*-Direktive werden zu einfachem HTML gerendert.client:onlyüberspringt das serverseitige Rendering vollständig, setzen Sie darin also nie Antworttext ein.Eine JSON-LD-Komponente hinzufügen, die maskiert
set:htmlwird von Astro nicht maskiert, undJSON.stringifylässt</script>unangetastet. In unserem Test mit Astro 7.0.5 beendete eine Beschreibung mit</script>den Block vorzeitig, und er ließ sich nicht mehr als JSON parsen. Das Maskieren von<behob es. Astro verarbeitet kein Script-Tag mit anderen Attributen alssrc, der Block wird also unverändert ausgegeben.src/components/JsonLd.astro --- interface Props { data: Record<string, unknown>; } const { data } = Astro.props; const json = JSON.stringify(data).replace(/</g, '\u003c'); --- <script type="application/ld+json" set:html={json} />llms.txt aus der Content Collection erzeugen
Ein statischer Datei-Endpunkt unter
src/pages/llms.txt.tsbaut/llms.txtbeim Build. Das Lesen ausgetCollection()sorgt dafür, dass sie nicht von den veröffentlichten Seiten abweichen kann.src/pages/llms.txt.ts import type { APIRoute } from 'astro'; import { getCollection } from 'astro:content'; export const GET: APIRoute = async ({ site }) => { const url = (path: string) => new URL(path, site).href; const posts = (await getCollection('blog', ({ data }) => !data.draft)).sort( (a, b) => b.data.publishDate.getTime() - a.data.publishDate.getTime(), ); const body = [ '# Example Co', '', '> One or two sentences: what you do, for whom, and where.', '', '## Guides', ...posts.map((p) => '- [' + p.data.title + '](' + url('/blog/' + p.id) + '): ' + p.data.description), '', ].join('\n'); return new Response(body, { headers: { 'Content-Type': 'text/plain; charset=utf-8' } }); };Eine Quelle für die robots.txt wählen
Nutzen Sie
public/robots.txtoder einen Endpunkt, nicht beides. Der Endpunkt kannsitewiederverwenden und die Regeln in der KI-Gruppe wiederholen, wie es die Dokumentation zur Sitemap-Integration für Sitemaps zeigt.src/pages/robots.txt.tsDies ODER public/robots.txt verwenden import type { APIRoute } from 'astro'; const AI_AGENTS = [ 'OAI-SearchBot', 'ChatGPT-User', 'Claude-SearchBot', 'Claude-User', 'PerplexityBot', 'Perplexity-User', 'GPTBot', 'ClaudeBot', 'Google-Extended', ]; export const GET: APIRoute = ({ site }) => { const sitemapURL = new URL('sitemap-index.xml', site); const rules = 'Allow: /\nDisallow: /api/'; return new Response( [ 'User-agent: *\n' + rules, // A crawler that matches a named group ignores the * group, so repeat the rules. AI_AGENTS.map((ua) => 'User-agent: ' + ua).join('\n') + '\n' + rules, 'Sitemap: ' + sitemapURL.href, '', ].join('\n\n'), ); };Sitemap-lastmod aus dem Frontmatter setzen, für .md und .mdx
@astrojs/sitemapbraucht die Optionsiteund kann dynamische SSR-Routen nicht auflisten. Nutzen Sieserialize(), umlastmodaus jedem Beitrag zu setzen. Erfassen Sie beide Endungen, sonst verliert ein Beitrag beim Umstellen auf MDX stillschweigend sein Datum. Das haben wir auf unserer eigenen Website festgestellt.astro.config.mjs import { defineConfig } from 'astro/config'; import sitemap from '@astrojs/sitemap'; import { readdirSync, readFileSync } from 'node:fs'; const postDates = Object.fromEntries( readdirSync('./src/content/blog') .filter((f) => /\.mdx?$/.test(f)) .map((f) => { const fm = readFileSync('./src/content/blog/' + f, 'utf8').split('---')[1] ?? ''; const date = fm.match(/^updatedDate:\s*(\S+)/m)?.[1] ?? fm.match(/^publishDate:\s*(\S+)/m)?.[1]; return ['/blog/' + f.replace(/\.mdx?$/, ''), date]; }), ); export default defineConfig({ site: 'https://www.example.com', integrations: [ sitemap({ serialize(item) { const path = new URL(item.url).pathname.replace(/\/$/, ''); const date = postDates[path]; if (date) item.lastmod = new Date(date).toISOString(); return item; }, }), ], });Die Datei verlinken, damit Agenten sie finden
Fügen Sie
link rel="alternate" type="text/plain" href="/llms.txt"oder einen Footer-Link hinzu. Die llms.txt-v2-Spezifikation nutzt dafürrel="describedby".Funktion prüfenPrüfen, ob es funktioniert
Führen Sie
npx astro buildaus. Öffnen Siedist/llms.txt,dist/robots.txt,dist/sitemap-0.xmlund einedist/blog/your-post/index.html. Führen Sie nach dem Deploymentcheck-ai-crawl.shfür die Live-URL aus und suchen Sie nach „Phrase in raw HTML: YES“.
JsonLd.astro
JSON-LD-Komponente, die das Kleiner-als-Zeichen maskiert.
Astro
llms.txt-Endpunkt
Baut llms.txt aus der Content Collection.
Astro
robots.txt-Endpunkt
Wiederholt die Regeln innerhalb der KI-Gruppe.
Astro
Sitemap-Serializer
Setzt lastmod aus dem Frontmatter für .md und .mdx.
Astro
maxenius.com als Live-Beispiel für Astro
Diese Website ist so gebaut, wie es die obigen Schritte beschreiben, und Sie können sie prüfen.
src/lib/llms.ts,src/pages/llms.txt.tsundsrc/pages/llms-full.txt.tsbauen /llms.txt und /llms-full.txt aus denselben Daten wie die Seiten.public/robots.txtwiederholt ihre Regeln innerhalb der benannten Gruppe der KI-Crawler. Das ist eine Linie für maximale Sichtbarkeit: Sie heißt jeden aufgeführten Crawler willkommen, auch Trainings-Crawler. Wählen Sie Ihre eigene Linie bewusst, wie in der Grundlage zur robots.txt beschrieben.Seo.astroundsrc/lib/seo.tsgeben ein Robots-Meta-Tag mitmax-snippet:-1, einlink rel="alternate" type="text/plain"auf/llms.txtund einen JSON-LD-Graphen aus Organization, WebSite, WebPage, Article, FAQPage und BreadcrumbList aus.astro.config.mjsnutzt statische Ausgabe und nimmt das Sitemap-lastmodaus dem Frontmatter jedes Beitrags.
Was immer Sie wählen: Server-HTML ist die Grundlage. Die Dateien und das Markup in diesem Abschnitt sind Ergänzungen obendrauf.
Messen und testen
Sie brauchen fünf Quellen, weil keine allein alles abdeckt: die Search Console für Google, GA4 oder Plausible für Klicks, die Bing Webmaster Tools für Copilot-Zitierungen, Server-Logs für Bots und Prompt-Tests dafür, was die Antworten sagen. Jede beantwortet eine andere Frage und hat blinde Flecken, lesen Sie sie also nebeneinander.
Wo welche Quelle berichtet
| Quelle | Was sie zeigt | Was sie nicht zeigt |
|---|---|---|
| Search Console, Leistung | Klicks und Impressionen aus KI-Übersichten und KI-Modus, gezählt innerhalb des Suchtyps „Web“. Ein Klick auf einen externen Link in einer der beiden Funktionen zählt. | Alle Links in einer KI-Übersicht teilen sich eine Position, sodass eine zitierte Seite eine gute Position und eine winzige CTR zeigen kann. Eine Folgefrage im KI-Modus zählt als neue Suchanfrage. Experimente aus Search Labs sind ausgenommen. Googles Seite zu KI-Funktionen bestätigt den Typ „Web“. |
| Search-Console-Bericht Generative AI | Impressionen in KI-Übersichten und KI-Modus nach Seite, Land, Gerät und Datum. Angekündigt am 3. Juni 2026; für alle Websites seit dem 31. August 2026. | Keine Klicks, CTR, Position oder Suchanfragen. Er erscheint womöglich nicht, wenn Ihre Website zu wenige KI-Impressionen hat. Er ist eine Teilmenge der Web-Daten, addieren Sie ihn also nicht zum Leistungsbericht. |
| AI Performance in den Bing Webmaster Tools | Öffentliche Vorschau seit dem 10. Februar 2026: Total Citations, Average Cited Pages, Grounding-Anfragen (Stichprobe) und Zitieraktivität auf Seitenebene. Seit dem 16. Juni 2026: Intents, Topics, Citation Share und Compare, in der Vorschau. | Eine Zitierung ist kein Klick und kein Besuch. Die Daten sind Stichproben, und Grounding-Anfragen sind gruppierte Formulierungen, keine echten Prompts. Citation Share macht Wettbewerber-Domains nicht sichtbar. |
| GA4 und Plausible | Besuche mit Referrer oder UTM. GA4 hat seit dem 13. Mai 2026 einen Standardkanal „AI Assistant“. Plausible hat einen Kanal „AI Assistants“. | Der GA4-Kanal schließt KI-Übersichten und KI-Modus aus, die als Organic Search zählen. OpenAI dokumentiert nur utm_source=chatgpt.com, bei anderen Assistenten sind Sie also auf Referrer angewiesen. |
| Server-Logs | Jede Bot-Anfrage, einschließlich nutzerausgelöster Abrufe, die nie JavaScript ausführen. | Wer die Antwort gelesen oder geklickt hat. Erfordert IP-Prüfungen, weil User-Agents gefälscht werden können. |
| Prompt-Tests | Was jede Engine heute tatsächlich über Sie sagt. | Einen stabilen Rang. Google sagt, KI-Übersichten und KI-Modus könnten unterschiedliche Modelle nutzen und ihre Links variieren, einzelne Durchläufe führen also in die Irre. |
Die Messung Schritt für Schritt einrichten
SchritteSichtbarkeit in der KI-Suche messen
Impressionen von KI-Funktionen trennen
Beginnen Sie hier bei jeder Seite mit vielen Impressionen und fast ohne Klicks.
- Öffnen Sie in der Search Console „Leistung“, filtern Sie Seite auf Ihre URL und notieren Sie Impressionen, Klicks, CTR und durchschnittliche Position.
- Öffnen Sie den Bericht „Generative AI performance“, gehen Sie zum Tab „Seiten“ und suchen Sie dieselbe URL.
- Vergleichen Sie die beiden Impressionszahlen. Der KI-Bericht ist eine Teilmenge von „Web“, addieren Sie sie also nie. Wenn KI-Funktionen den Großteil der Impressionen ausmachen, ist eine gute Position bei niedriger CTR zu erwarten, denn alle Links in einer KI-Übersicht teilen sich eine Position.
- Fehlt der Bericht, hat die Website laut Google noch nicht genug KI-Impressionen. Das ist kein Fehler.
- Öffnen Sie Einstellungen > Search generative AI und prüfen Sie, dass die Property nicht auf „Exclude“ steht und „Exclude“ nicht von einer übergeordneten Property erbt. Siehe Search generative AI control.
- Fügen Sie an dem Tag, an dem Sie Änderungen ausliefern, eine Anmerkung hinzu: Rechtsklick auf das Leistungsdiagramm, bis zu 120 Zeichen (Hilfe zu Anmerkungen).
Den integrierten Kanal „AI Assistant“ nutzen
Gehen Sie in GA4 zu Reports > Acquisition > Traffic acquisition. Setzen Sie die primäre Dimension auf „Session default channel group“ und suchen Sie die Zeile „AI Assistant“. Fügen Sie „Session source“ als sekundäre Dimension hinzu, um zu sehen, welcher Assistent jede Sitzung geschickt hat. Klicks aus KI-Übersichten und KI-Modus erscheinen hier nicht. Öffnen Sie in Plausible Sources > Channels > AI Assistants.
Eine eigene Kanalgruppe hinzufügen
Gehen Sie zu Admin > Data display > Channel groups, legen Sie eine Gruppe an und fügen Sie einen Kanal hinzu, bei dem die Quelle dem folgenden regulären Ausdruck entspricht. Ziehen Sie ihn über „Referral“, denn Traffic wird dem ersten Kanal zugeordnet, auf den er passt. Standard-Properties erlauben 2 eigene Gruppen, und eigene Gruppen sind nicht im BigQuery-Export enthalten.
Googles eigener Beispielausdruck in diesem Hilfeartikel traf in unserem Test zu viel: Er erfasste auch help.openai.com, github.com/copilot, chatgptlist.org und „shanghai“. Nutzen Sie stattdessen diesen engeren.
ga4-ai-sources.regex111 Zeichen, verankert ^(.*\.)?(chatgpt\.com|chat\.openai\.com|perplexity\.ai|claude\.ai|copilot\.microsoft\.com|gemini\.google\.com)$Er akzeptiert chatgpt.com, chat.openai.com, www.perplexity.ai, claude.ai, copilot.microsoft.com und gemini.google.com. Er lehnt google, mail.google.com, openai.com, help.openai.com, notchatgpt.com, perplexity.ai.evil.com und bing.com ab. Er deckt den www-Host und den alten ChatGPT-Host ab, weil chat.openai.com auf chatgpt.com und perplexity.ai auf www.perplexity.ai weiterleitet. Reguläre Ausdrücke in GA4 sind standardmäßig Vollabgleich und unterscheiden Groß- und Kleinschreibung, nutzen RE2, und Berichtsfilter sind auf 250 Zeichen begrenzt. Die Anker halten dieses Muster in beiden Abgleichmodi korrekt. Ergänzen Sie weitere Assistenten erst, wenn sie in Ihrem eigenen Bericht zur Session source auftauchen.
Auf verlorene UTMs achten
Suchen Sie in „Session source / medium“ nach chatgpt.com-Zeilen, die unter „Unassigned“ oder „Referral“ landen, denn Google dokumentiert nicht, wie GA4 ein utm_source ohne Medium gegen die Regel „AI Assistant“ auswertet. Eine Weiterleitung, die den Query-String verwirft, etwa eine Regel für Schrägstrich am Ende, www oder http auf https, verwirft auch die UTM. Testen Sie eine mit Parametern versehene URL durch jede Weiterleitung, die Sie betreiben.
Eine Exploration erstellen (optional)
Überspringen Sie das, wenn der integrierte Kanalbericht Ihre Frage beantwortet. Starten Sie in „Explore“ eine leere Exploration. Importieren Sie die Dimensionen „Session source“, „Session source / medium“, „Landing page + query string“ und „Session default channel group“ sowie die Messwerte „Sessions“, „Engaged sessions“ und „Key events“. Legen Sie „Session source“ und dann „Landing page + query string“ in die Zeilen und filtern Sie „Session source“ mit demselben regulären Ausdruck.
Copilot- und Bing-Zitierungen lesen
- Verifizieren Sie die Website in den Bing Webmaster Tools und öffnen Sie den Bericht „AI Performance“.
- Lesen Sie Total Citations, Average Cited Pages, Grounding-Anfragen und die Seitenliste. Klicken Sie eine Grounding-Anfrage an, um ihre zitierten Seiten zu sehen, oder eine Seite, um ihre Grounding-Anfragen zu sehen.
- Nutzen Sie „Compare“, um den Zeitraum nach Ihren Änderungen darüberzulegen. Intents, Topics und Citation Share sind Vorschaufunktionen.
- Exportieren Sie monatlich als CSV oder Excel. Lesen Sie die FAQ zu den Regeln für Stichproben und Aktualisierung.
- Übermitteln Sie geänderte URLs über IndexNow. Bing empfiehlt es, damit KI-Antworten die aktuelle Version der Seite nutzen.
KI-Bot-Treffer in den Server-Logs zählen
Suchen Sie nach diesen User-Agents. Suche: OAI-SearchBot, Claude-SearchBot, PerplexityBot, Googlebot, bingbot. Training: GPTBot, ClaudeBot. Nutzerausgelöst: ChatGPT-User, Claude-User, Perplexity-User. Google-Extended erscheint nie, weil es ein robots.txt-Token ohne eigenen User-Agent ist.
Nutzerausgelöste Treffer sind am wichtigsten. Jeder bedeutet, dass eine echte Unterhaltung Ihre Seite gelesen hat, und weil diese Abrufe kein JavaScript ausführen, sehen GA4 und Plausible sie nie.
Eine schnelle Zählung aus einem Log im Combined-Format. Diese awk-Variante zählt jede Zeile einmal, wo ein einfaches grep bingbot pro Zeile doppelt zählte:
terminalZählt jede Zeile einmal awk 'match($0, /OAI-SearchBot|ChatGPT-User|GPTBot|Claude-SearchBot|Claude-User|ClaudeBot|PerplexityBot|Perplexity-User|Googlebot|bingbot/) { print substr($0, RSTART, RLENGTH), $7 }' access.log | sort | uniq -c | sort -rnUser-Agents lassen sich leicht fälschen, prüfen Sie also die IPs. Unser
ai_bot_report.py(Python 3, nur Standardbibliothek, im Paket) zählt Treffer pro Tag, Bot, Status und Pfad und prüft jede IP gegen die veröffentlichte Liste des Betreibers für OpenAI, Anthropic, Perplexity, Google und Bing. Eine Zeile mitip_verified=NOist ein gefälschter User-Agent. Es markiert einen falschen GPTBot von einer nicht gelisteten IP.terminal python3 ai_bot_report.py access.log > ai-bots.csv zcat access.log.*.gz | python3 ai_bot_report.py - > ai-bots.csvOhne das Skript nutzen Sie die doppelte Abfrage: Der Reverse-DNS-Eintrag der IP muss einen Google-Hostnamen liefern (googlebot.com, google.com oder googleusercontent.com) oder bei Bingbot einen, der auf search.msn.com endet, und eine Vorwärtsabfrage dieses Namens muss dieselbe IP liefern.
Bei Vercel gehen Sie zu Firewall > Rules > Bot Management und setzen das AI-Bots-Regelset auf „Log“, nicht auf „Deny“ (WAF Managed Rulesets). Nutzen Sie dann Firewall > Traffic und gruppieren Sie nach User Agents und Request Paths (Observability). Runtime Logs zeigen nur statische Anfragen, die aus dem Cache bedient werden. Ein vollständiges Log erfordert Drains, die in den Tarifen Pro und Enterprise verfügbar sind, mit
proxy.userAgentin jedem Datensatz:vercel-drain-bots.shBenötigt jq jq -r 'select(.proxy) | [(.proxy.timestamp/1000|todate), .proxy.clientIp, .proxy.path, (.proxy.statusCode|tostring), (.proxy.userAgent|join(" "))] | @tsv' drain.ndjson \ | awk -F'\t' 'match($5, /OAI-SearchBot|ChatGPT-User|GPTBot|Claude-SearchBot|Claude-User|ClaudeBot|PerplexityBot|Perplexity-User|Googlebot|bingbot/) { print substr($5, RSTART, RLENGTH) "\t" $3 }' \ | sort | uniq -c | sort -rnBei Cloudflare öffnen Sie AI Crawl Control. Liegen die Treffer von KI-Crawlern nahe null, prüfen Sie, ob die Einstellung der verwalteten robots.txt Disallow-Regeln für GPTBot, ClaudeBot oder Google-Extended voranstellt.
Einen wiederholbaren Prompt-Test durchführen
Kein offizielles Werkzeug meldet Zitierungen von ChatGPT, Claude oder Perplexity, testen Sie also von Hand mit einem festen Protokoll.
- Schreiben Sie 20 bis 40 Prompts aus den Bereichen Anleitung, Vergleich, plattformspezifische Fragen und zwei oder drei Markenfragen. Geben Sie jedem eine dauerhafte ID. Um die Formulierung zu ändern, geben Sie die ID auf und vergeben eine neue.
- Engines: ChatGPT mit eingeschalteter Suche, Google AI Mode, Google AI Overviews (eine normale Suche), Gemini, Perplexity, Microsoft Copilot, Claude mit eingeschalteter Websuche.
- Halten Sie die Einstellungen konstant: Land, Sprache, angemeldet oder abgemeldet. Nutzen Sie in ChatGPT einen temporären Chat mit der Einstellung „Unpersonalized“, der Memory und benutzerdefinierte Anweisungen überspringt. „Personalized“ kann weiterhin vorhandene Memories nutzen. Verwenden Sie anderswo ein frisches Profil oder eine abgemeldete Sitzung und notieren Sie den Modus oder das Modell.
- Führen Sie jeden Prompt je Engine 3-mal aus. Antworten schwanken zwischen den Durchläufen.
- Rhythmus: eine monatliche Baseline sowie ein erneuter Durchlauf 2 bis 4 Wochen nach einer größeren Inhaltsänderung.
- Protokollieren Sie jeden Durchlauf in
ai-prompt-tracker.csv(26 Spalten, zwei deutlich gekennzeichnete Beispielzeilen). Berechnen Sie Erwähnungsrate, Zitierrate und Zitieranteil (Ihre zitierten URLs geteilt durch alle zitierten URLs, dieselbe Idee wie die Kennzahl von Bing). - Bewahren Sie Screenshots als private Belege auf. Veröffentlichen Sie keine Oberflächen von Dritten.
Google Sheets or ExcelDaten auf einem Blatt namens runs Mention rate =COUNTIF(runs!N2:N1000,"yes")/COUNTA(runs!C2:C1000) Citation rate =COUNTIF(runs!P2:P1000,"yes")/COUNTA(runs!C2:C1000) Citation share =SUM(runs!R2:R1000)/SUM(runs!S2:S1000)Funktion prüfenPrüfen, ob es funktioniert
Bestätigen Sie vier Dinge:
- Sie haben für die URL einen Vorher-Wert (Gesamtimpressionen und Impressionen in KI-Funktionen) und eine Anmerkung, die auf den Tag der Auslieferung datiert ist.
- Der GA4-Filter liefert nur Hosts von Assistenten.
- Die Bot-Ausgabe zeigt Ihre eigenen Anfragen. Erzeugen Sie eine mit
curl -A 'OAI-SearchBot' -s -o /dev/null https://yourdomain.com/robots.txtund suchen Sie dann eine Zeile mit diesem Bot-Namen und Status 200. - Der Prompt-Tracker hat für jede Prompt-ID und jede Engine eine Baseline-Zeile.
Wenn Sie die Messung lieber eingerichtet und ausgewertet bekommen möchten, sehen Sie sich unsere KI-SEO-Leistungen an.
Tools von Drittanbietern
Ahrefs Brand Radar verfolgt Erwähnungen und Zitierungen in KI-Übersichten, KI-Modus, ChatGPT, Gemini, Perplexity und Copilot, mit einem Prompt-Index, der laut Ahrefs aus Suchdaten modelliert ist, plus eigenen Prompts, die Sie wählen. Das Semrush AI Visibility Toolkit bietet einen Sichtbarkeitswert, Prompt-Recherche und tägliches Prompt-Tracking. Cloudflare AI Crawl Control meldet die Crawler-Aktivität für Websites hinter Cloudflare. Diese Tools ziehen Stichproben von Prompts, statt echte Nutzerunterhaltungen zu lesen, und Google sagt, kein Drittanbieter-Tool habe Zugang zu seinen KI-Ranking-Systemen. Betrachten Sie deren Zahlen als Richtwerte und vergleichen Sie sie mit Ihren eigenen Daten aus erster Hand.
Checkliste zur Selbstprüfung
Arbeiten Sie diese Liste auf Ihrer eigenen Website ab. Jeder Punkt verweist zurück auf den Abschnitt, der ihn erklärt. Ihr Fortschritt wird nur in diesem Browser gespeichert und folgt Ihnen deshalb nicht auf ein anderes Gerät.
GEO-Selbstcheck
0 von 33 erledigt
GEO-Starterpaket
Alles aus dieser Anleitung, was Sie kopieren können, steckt in einem kostenlosen Download, ohne Anmeldung und ohne E-Mail-Formular.
Das komplette GEO-Starterpaket herunterladen
53 Dateien in einem Archiv: robots.txt, llms.txt, JSON-LD, IndexNow, WordPress, Shopify, Next.js, React, Astro, Skripte, ein Prompt-Tracker und ein Content-Briefing.
Alle
Druckbare Checkliste zur Selbstprüfung
Die Checkliste von oben, zwei A4-Seiten, bereit zum Drucken oder Speichern.
Alle
Prompt-Tracker
Der Tracker mit 26 Spalten. Formeln und Testprotokoll liegen im selben Ordner.
Alle
Vorlage für das Content-Briefing
Ein Content-Briefing mit der Antwort zuerst.
Alle
Bot-Report-Skript
Zählt KI-Bot-Treffer aus einem Log und prüft jede IP gegen veröffentlichte Bereiche.
Alle
GA4-Regex für KI-Quellen
Der engere reguläre Ausdruck für eine eigene Kanalgruppe.
Alle
HTML-Head-Snippet
Robots-Meta und data-nosnippet-Markup.
Alle
IndexNow-Ping
Ein Batch-Ping-Befehl, mit einer Beispiel-Schlüsseldatei im selben Ordner.
Alle
Die Plattformdateien sind in den jeweiligen Plattformabschnitten oben verlinkt. Jede Datei verwendet Platzhalter wie example.com, Beispielschlüssel und Beispielnamen. Ersetzen Sie jeden davon, bevor Sie deployen, und führen Sie den Prüfschritt aus dem passenden Abschnitt aus.
Nächste Schritte
Beginnen Sie mit der obigen Checkliste zur Selbstprüfung und beheben Sie den ersten nicht bestandenen Punkt, meist Bot-Zugang oder Server-HTML. Wenn Sie die Arbeit lieber auf Ihrer eigenen Website erledigt und geprüft haben möchten: Maxenius führt Audits und Umsetzung für KI-SEO und GEO durch. Wir prüfen Crawler-Zugang, Rendering, strukturierte Daten und Messung anhand der Schritte in dieser Anleitung und berichten mit Belegen, was sich geändert hat. Niemand kann KI-Zitierungen garantieren, deshalb bieten wir das nicht an.
Audit für die KI-Suche buchenWenn es um einen Neubau geht, übernehmen wir auch Shopify-Entwicklung, WordPress-Entwicklung und individuelle Softwareentwicklung. Die Dokumentation der Anbieter ändert sich oft. Prüfen Sie die Quellen unten monatlich erneut.
Quellen und Daten
Alle am 7. Oktober 2026 geöffnet und geprüft.
- Google Search Console Help, What are impressions, position, and clicks
- Google Search Console Help, Generative AI performance report
- Google Search Console Help, Search generative AI control
- Google Search Console Help, Search Console annotations
- Google Search Central Blog, Introducing Search Generative AI performance reports
- Google Search Central, AI features and your website
- Google, Google’s common crawlers
- Google, Verify requests from Google crawlers and fetchers
- Google Analytics Help, What’s new in Google Analytics, Default channel group, Custom channel groups, About regular expressions
- Microsoft Bing Webmaster Blog, Introducing AI Performance in Bing Webmaster Tools Public Preview
- Microsoft Bing Webmaster Tools Help, AI Performance FAQ
- Microsoft Bing Search Blog, New AI Visibility Insights in Bing Webmaster Tools
- OpenAI, Overview of OpenAI Crawlers
- OpenAI Help Center, Publishers and Developers FAQ, Temporary chat
- Anthropic, Does Anthropic crawl data from the web
- Perplexity, Perplexity Crawlers
- IndexNow.org, Documentation and FAQ
- Vercel, WAF Managed Rulesets, Firewall Observability, Runtime Logs
- Cloudflare, Managed robots.txt
- Plausible, Top referrers
- Ahrefs, Brand Radar
- Semrush, AI Visibility Toolkit