IA et SEO
Optimiser son site pour la recherche IA (GEO) + modèles
Publié le · Dernière mise à jour
Sur cette page
Ce guide vous montre comment configurer un site pour que les produits de recherche IA puissent le trouver, le comprendre et le citer, avec des étapes concrètes pour chaque plateforme et une vérification après chacune. Il s’adresse aux propriétaires de sites, aux responsables marketing et aux développeurs qui veulent faire le travail eux-mêmes. Personne ne peut garantir une citation dans ChatGPT, Perplexity, Claude ou Google, et Google indique qu’optimiser pour la recherche IA générative reste du SEO. Un kit de démarrage gratuit de fichiers à copier-coller se trouve à la fin.
L’essentiel à retenir
- Laissez entrer les bons robots. Les robots de recherche décident si vous pouvez être cité, pas les robots d’entraînement, et votre CDN ou pare-feu peut passer outre robots.txt.
- Placez la réponse dans du HTML rendu côté serveur. Plusieurs grands robots d’exploration IA n’exécutaient pas JavaScript lors de la dernière mesure, testez donc avec un simple curl.
- Rédigez des sections qui commencent par la réponse : un sujet par URL, une réponse directe sous chaque titre, des faits explicites.
- Les données structurées doivent correspondre au texte visible. Aucun schéma particulier n’est requis pour les fonctions IA de Google.
- llms.txt est facultatif et la recherche Google l’ignore. Il coûte peu, faites-le donc après les bases.
- Mesurez avec les outils officiels (Search Console, Bing Webmaster Tools, GA4) et répétez vos tests de requêtes dans le temps.
Vous hésitez sur la plateforme qui convient à votre entreprise ? Lisez d’abord WordPress ou Shopify.
Qu’est-ce que le GEO ?
L’optimisation pour les moteurs génératifs (GEO, generative engine optimization) consiste à rendre vos pages faciles à trouver, à comprendre et à citer pour les produits de recherche IA. L’optimisation pour les moteurs de réponse (AEO, answer engine optimization) est une étiquette qui recoupe le même travail, et il n’existe pas de définition consensuelle de l’une ou l’autre, comme le note l’article de Wikipédia. Google l’intègre au SEO, tandis que les consignes aux webmasters de Bing emploient le terme GEO et précisent qu’il ne garantit ni l’ancrage ni les citations.
Comment les moteurs génératifs trouvent, choisissent et citent leurs sources
Tous les moteurs suivent à peu près le même parcours, même si les détails varient selon l’éditeur.
- Exploration: Googlebot (alimente aussi les aperçus IA et le mode IA); Bingbot (Bing, Copilot, API d’ancrage); OAI-SearchBot; Claude-SearchBot; PerplexityBot
- Indexation: Google : indexé et éligible aux extraits; Bing : Copilot partage l’exploration, l’index et le classement; ChatGPT : fournisseurs de recherche tiers et OAI-SearchBot; Perplexity : recherche web en temps réel
- Élargir la question: Google : query fan-out; ChatGPT : reformulation de la requête
- Récupérer et sélectionner des passages: Google : ancrage à partir de l’index de la Recherche; Copilot : découpe les pages en éléments plus petits; Limites : nosnippet, max-snippet, data-nosnippet, Bing NOARCHIVE et NOCACHE
- Générer et citer: Google : liens vers les pages sources; Perplexity : citations numérotées; ChatGPT : citations; Bing : citations comptabilisées
- Mesure : rapport IA générative de Search Console (impressions uniquement) ; performances de Search Console (clics IA sous Web) ; Bing AI Performance ; GA4 utm_source=chatgpt.com ; journaux du serveur
Les robots d’entraînement sont distincts : GPTBot, ClaudeBot, Google-Extended (jeton uniquement). Robots déclenchés par l’utilisateur : ChatGPT-User, Claude-User, Perplexity-User.
1. Explorer. Les robots doivent atteindre la page. Les aperçus IA et le mode IA de Google utilisent l’exploration normale de la recherche, le robot de Bing alimente Copilot, la recherche ChatGPT s’appuie sur OAI-SearchBot, la recherche Claude sur Claude-SearchBot et Perplexity sur PerplexityBot.
2. Indexer. Google indique qu’une page doit être indexée et éligible à un extrait, sans autre exigence. Bing indique que Copilot partage les mêmes bases d’exploration, d’index et de classement. OpenAI indique que ChatGPT envoie des requêtes reformulées à des fournisseurs de recherche tiers en plus d’utiliser son propre robot.
3. Élargir la question. Le guide de Google décrit la query fan-out, où des sous-requêtes connexes sont émises. OpenAI indique que ChatGPT reformule une requête en une ou plusieurs requêtes ciblées.
4. Récupérer et sélectionner des passages. Google récupère avec ses systèmes de classement principaux. Microsoft indique que Copilot découpe les pages en morceaux plus petits, de sorte que des détails clés cachés dans des onglets, des images ou des PDF peuvent être ignorés.
5. Générer et citer. Perplexity joint des citations numérotées à ses réponses. OpenAI indique que le placement dans la recherche ChatGPT n’est pas garanti.
Vient ensuite la mesure, traitée à la fin. Si vous travaillez spécifiquement sur ChatGPT, consultez notre guide pour apparaître sur ChatGPT, et pour le sujet plus large notre guide de l’optimisation pour les moteurs de réponse.
Robots d’entraînement, robots de recherche et récupérateurs déclenchés par l’utilisateur
Chaque éditeur répartit son exploration selon l’usage. La règle pratique : bloquer un jeton d’entraînement ne vous retire pas de la recherche IA de cet éditeur, bloquer un robot de recherche si.
| Éditeur | Recherche et réponses | Entraînement des modèles | Récupération déclenchée par l’utilisateur |
|---|---|---|---|
| OpenAI | OAI-SearchBot | GPTBot | ChatGPT-User |
| Anthropic | Claude-SearchBot | ClaudeBot | Claude-User |
| Perplexity | PerplexityBot | Non utilisé pour l’entraînement | Perplexity-User |
| Googlebot (Recherche, aperçus IA, mode IA) | Jeton Google-Extended (entraînement et ancrage de Gemini) | Récupérateurs Google déclenchés par l’utilisateur | |
| Apple | Applebot | Jeton Applebot-Extended | Aucun documenté |
| Microsoft | Bingbot (Bing et Copilot) | Pas de jeton distinct ; balises meta NOARCHIVE et NOCACHE | Aucun documenté |
Sources : OpenAI, Anthropic, Perplexity, Google, Apple, Bing. Vérifié le 7 octobre 2026.
SEO, AEO et GEO
| SEO | AEO | GEO | |
|---|---|---|---|
| Ce que les gens entendent par là | Gagner en visibilité dans les résultats de recherche classiques | Être la réponse dans les extraits optimisés, la voix et les réponses IA | Être cité dans les réponses générées |
| Où la réponse apparaît | Liens classés | Encadrés de réponse et assistants | Aperçus IA, mode IA, ChatGPT, Copilot, Perplexity, Claude |
| Ce que vous contrôlez | Exploration, contenu, liens, expérience de page | Contenu qui commence par la réponse et structure claire | Les mêmes leviers, plus l’accès des robots et la clarté de l’entité |
| Ce que vous mesurez | Impressions, clics, positions | Présence dans les extraits et les réponses | Citations, impressions dans les rapports IA, sessions de référence |
| Réserve | Les positions bougent | Les étiquettes recoupent le SEO | Pas de définition consensuelle, pas de citation garantie |
Google indique qu’optimiser pour la recherche IA générative reste du SEO. Considérez ces trois étiquettes comme des périmètres, pas comme des disciplines différentes.
Six mythes à abandonner avant de commencer
Les fondations dont toute plateforme a besoin
Ces six étapes s’appliquent à toutes les technologies. Les sections par plateforme plus loin montrent où se trouve chacune dans WordPress, Shopify, React, Next.js et Astro.
1. Laisser entrer les bons robots : robots.txt et votre CDN
ÉtapesOuvrir la porte aux robots de recherche
Décidez de votre politique
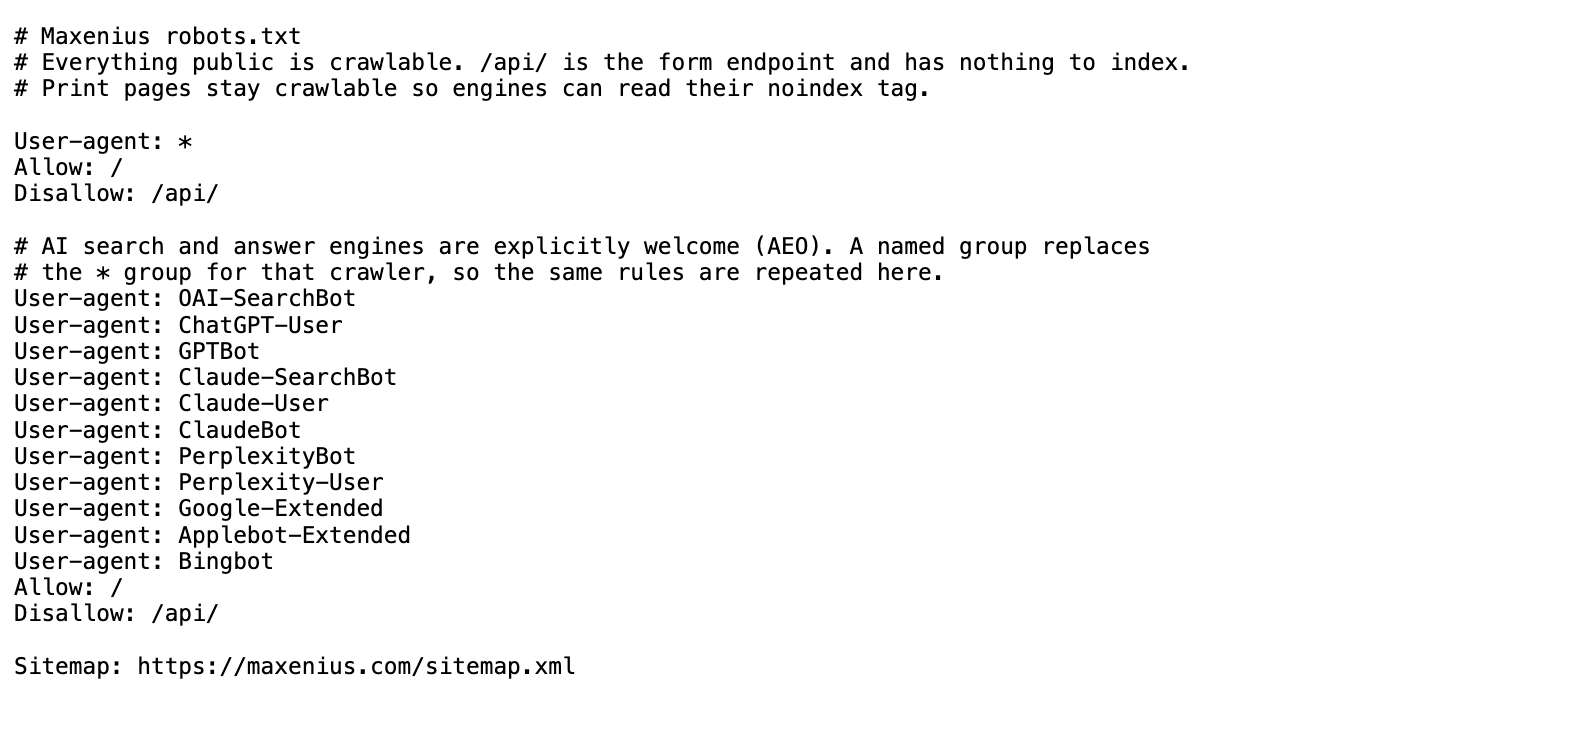
Le modèle A vous rend visible dans la recherche IA tout en refusant l’entraînement des modèles. Le modèle B accueille tout, robots d’entraînement compris, et c’est la politique que maxenius.com applique pour une visibilité maximale.
Écrivez le fichier en répétant les règles communes
Un robot n’obéit qu’au groupe correspondant le plus précis, et la spécification de Google indique que les groupes nommés et le groupe
*ne sont pas combinés. Répétez donc chaque ligne Disallow nécessaire dans chaque groupe nommé.public/robots.txtModèle A : visible dans la recherche IA, entraînement refusé User-agent: * Disallow: /api/ Disallow: /cart/ Allow: / User-agent: OAI-SearchBot User-agent: ChatGPT-User User-agent: Claude-SearchBot User-agent: Claude-User User-agent: PerplexityBot User-agent: Perplexity-User Disallow: /api/ Disallow: /cart/ Allow: / User-agent: GPTBot User-agent: ClaudeBot User-agent: Applebot-Extended User-agent: CCBot Disallow: / Sitemap: https://www.example.com/sitemap.xmlpublic/robots.txtModèle B : visibilité maximale, robots d’entraînement compris User-agent: * Disallow: /api/ Allow: / User-agent: OAI-SearchBot User-agent: ChatGPT-User User-agent: GPTBot User-agent: Claude-SearchBot User-agent: Claude-User User-agent: ClaudeBot User-agent: PerplexityBot User-agent: Perplexity-User User-agent: Google-Extended User-agent: Applebot-Extended Disallow: /api/ Allow: / Sitemap: https://www.example.com/sitemap.xmlGardez la mécanique propre
Placez les lignes Disallow avant
Allow: /, car des analyseurs simples comme le robotparser de Python s’arrêtent à la première correspondance. Servez un seul fichier par hôte depuis/robots.txt. Selon la RFC 9309, une réponse 5xx signifie que les robots considèrent tout comme interdit, et une 404 qu’ils peuvent tout explorer. robots.txt n’est pas un contrôle d’accès. OpenAI et Perplexity indiquent tous deux que les modifications prennent environ 24 heures à s’appliquer.Vérifiez la couche située au-dessus de robots.txt
OpenAI indique que votre hébergeur ou CDN doit autoriser ses plages d’adresses IP publiées, et Perplexity documente des règles WAF qui combinent agent utilisateur et listes d’IP. Deux pièges : depuis le 15 septembre 2026, Cloudflare bloque les robots à usage mixte, dont Googlebot, Applebot et BingBot, lorsqu’un client active le blocage de l’entraînement, et son robots.txt géré ajoute en tête des règles Disallow qui incluent Google-Extended. Sur Vercel, régler le jeu de règles AI Bots sur Deny bloque aussi les robots de recherche.
Vérifier que ça fonctionneVérifiez que cela fonctionne
Exécutez
curl -s https://yourdomain.com/robots.txtet confirmez que le fichier en ligne correspond à votre dépôt, car un CDN peut le réécrire. Cherchez ensuite dans les journaux du serveur ou du CDN des réponses 200 pour OAI-SearchBot, Claude-SearchBot, PerplexityBot et Bingbot. Usurper un agent utilisateur avec curl ne teste que les règles d’agent utilisateur, pas celles basées sur l’IP.
Ouvrir en taille réelle (nouvel onglet)
Modèles robots.txt A et B
Modèle A : robots de recherche autorisés, robots d’entraînement bloqués. Le modèle B, la politique de visibilité maximale, se trouve dans le même dossier du kit.
Toutes
2. Placer la réponse dans du HTML rendu côté serveur
ÉtapesRendre la page lisible sans JavaScript
Lisez d’abord les constats datés
En décembre 2024, Vercel et MERJ ont constaté qu’aucun des grands robots d’exploration IA étudiés n’exécutait JavaScript, hormis Gemini via Googlebot et Applebot. Les consignes 2026 de Vercel, Make your site readable by AI agents, conseillent toujours de rendre côté serveur le contenu que vous voulez faire lire. Ce sont des constats datés, pas une promesse valable pour tous les robots. OpenAI ne dit pas si OAI-SearchBot exécute le rendu, testez donc au lieu de supposer.
Rendez l’essentiel côté serveur
Le titre, le texte principal, la balise canonical, le JSON-LD et les liens de navigation doivent figurer dans le HTML initial. Google indique que tous les robots n’exécutent pas JavaScript, même si Googlebot le fait généralement.
Ne cachez pas les réponses
Gardez les réponses clés hors des onglets fermés, des images et des PDF. Microsoft et Bing déconseillent tous deux de cacher un contenu essentiel derrière un rendu côté client.
Vérifier que ça fonctionneVérifiez que cela fonctionne
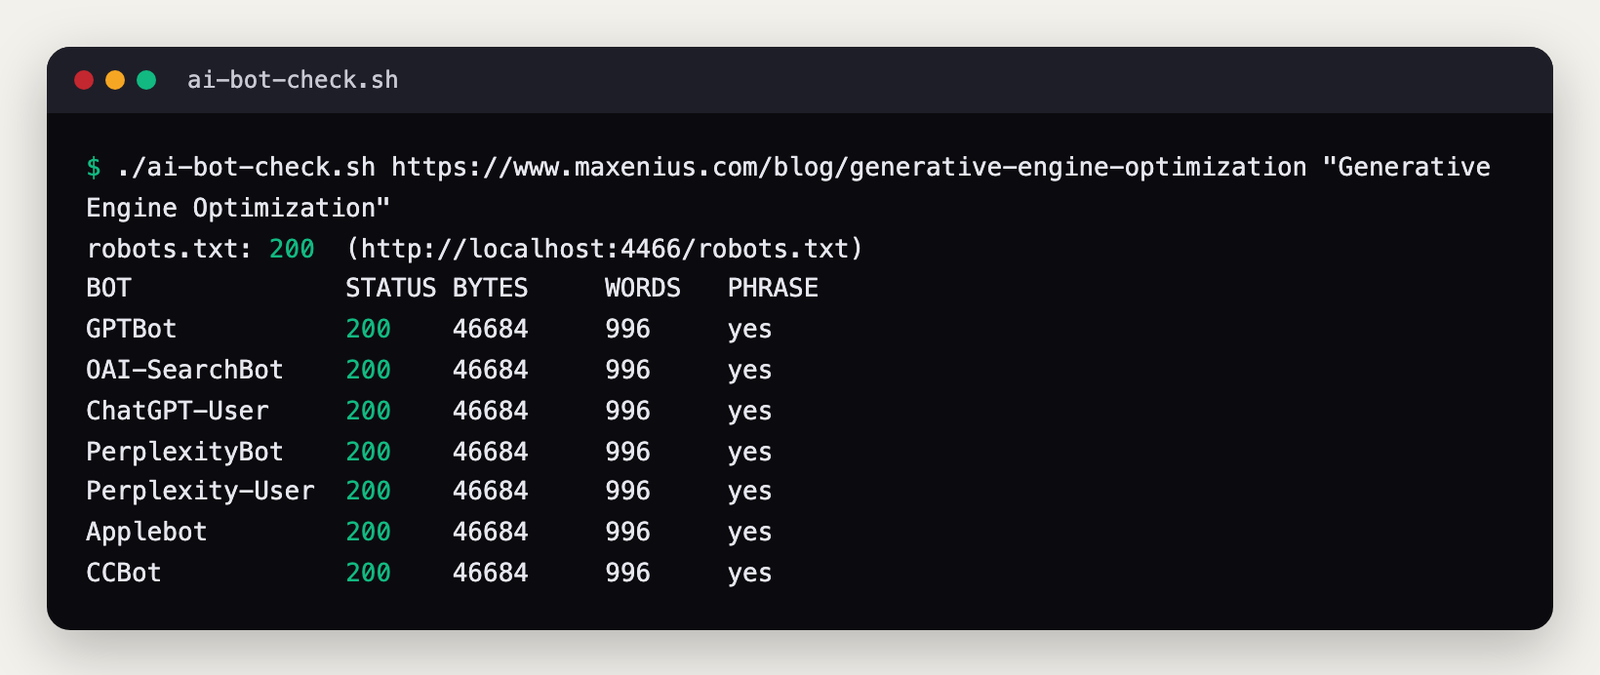
Récupérez la page comme le fait un robot sans rendu, par exemple avec le script du kit :
./ai-bot-check.sh https://www.example.com/page "a sentence from the body". Chaque ligne de robot doit afficher le statut 200, un nombre de mots proche de ce que vous voyez dans le navigateur, et PHRASE = yes. Le kit contient deux scripts :ai-bot-check.shteste sept agents utilisateurs de robots, etcheck-ai-crawl.sh(présenté dans la section sur les frameworks) vérifie en une récupération le titre, la balise canonical et le JSON-LD.
Ouvrir en taille réelle (nouvel onglet)
3. Rédiger des sections qui commencent par la réponse
ÉtapesRendre chaque section extractible
Commencez par la réponse
Placez la réponse directe dans les premières phrases sous chaque titre, et rendez les titres spécifiques. Les consignes de Bing conseillent de faire apparaître tôt l’information clé et de définir explicitement les faits sur l’URL.
Un sujet par URL, pas de pages en série
Ne créez pas une page pour chaque variante de fan-out d’une requête. Google qualifie cela de abus de contenu à grande échelle. Ajoutez plutôt des détails de première main, non banals, au lieu de répéter ce que d’autres disent.
Pas de texte caché destiné aux modèles
Bing considère l’injection de prompt et les instructions cachées destinées aux LLM comme un abus pouvant faire supprimer ou déclasser un site. Google indique qu’il n’existe pas de longueur idéale ni de nécessité de découper, rédigez donc pour les lecteurs.
Vérifier que ça fonctionneVérifiez que cela fonctionne
Lisez chaque section H2 isolément. Si elle répond à son propre titre sans le paragraphe qui précède, elle est validée.
4. Des données structurées conformes à la page
ÉtapesAjouter un balisage fidèle à la réalité
Vérifiez l’exigence
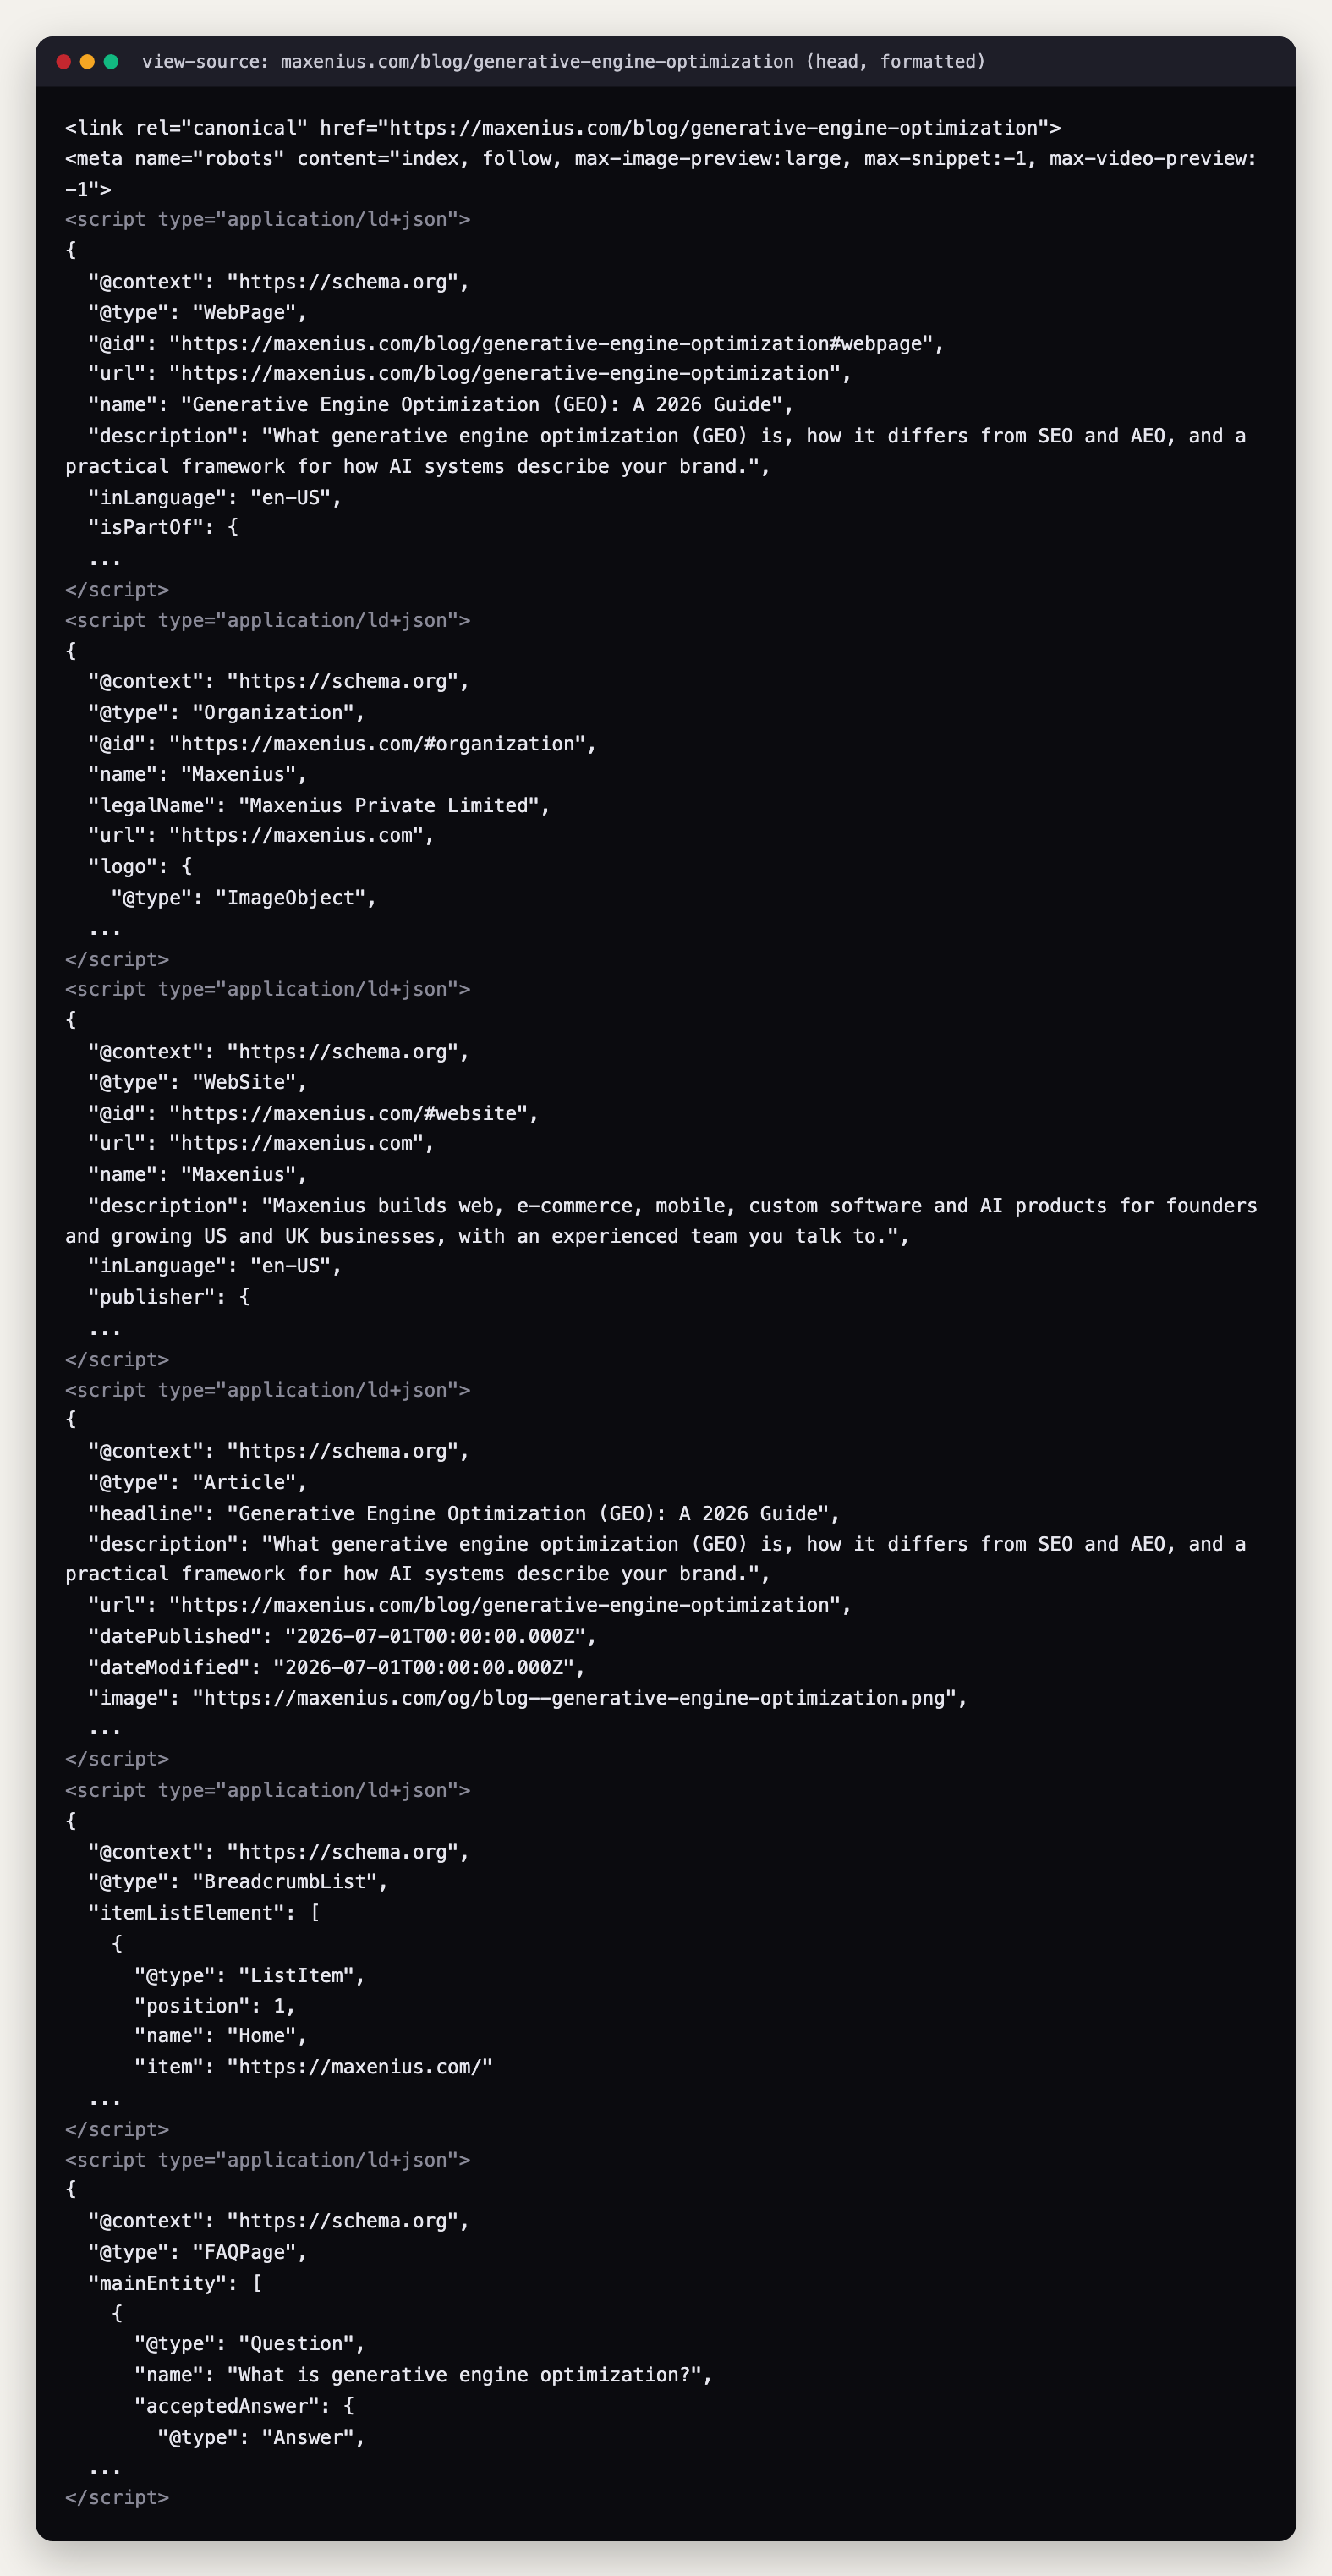
Google indique qu’aucun schéma spécial n’est nécessaire pour les fonctions IA, et que le balisage doit correspondre au texte visible. Utilisez tout de même Article ou BlogPosting, Organization, Product et BreadcrumbList là où ils s’appliquent.
Utilisez JSON-LD, échappez-le et indiquez les dates
Le JSON-LD peut figurer dans le head ou le body, et Google lit le JSON-LD injecté, mais les robots qui n’exécutent pas JavaScript ne le peuvent pas. Lorsque vous sérialisez du JSON dans une balise script, remplacez chaque
<par<(une barre oblique inverse suivie de u003c) afin qu’une chaîne contenant une balise script fermante ne puisse pas terminer le bloc prématurément. Les exemples React, Next.js et Astro ci-dessous le font. Affichez une date visible et réglezdatePublishedetdateModifiedpour qu’elles correspondent, selon les consignes de Google sur la signature.Considérez le schéma FAQ comme facultatif
Google a mis fin au résultat enrichi FAQ le 7 mai 2026. Gardez le balisage FAQ seulement s’il reproduit des questions visibles, et n’attendez aucun espace supplémentaire dans les résultats.
Vérifier que ça fonctionneVérifiez que cela fonctionne
Affichez le code source et confirmez que le JSON-LD figure dans le HTML brut. Lancez le test des résultats enrichis ou le Schema Markup Validator, puis comparez chaque valeur à ce que voit un visiteur.
Ouvrir en taille réelle (nouvel onglet)
5. Qu’est-ce que llms.txt, et en avez-vous besoin ?
llms.txt est une proposition communautaire facultative : un fichier Markdown à l’adresse /llms.txt qui liste vos pages clés pour les outils d’IA. Google indique que la recherche ne l’utilise pas, vous pouvez donc vous en passer sans rien perdre.
ÉtapesDécider de publier ou non llms.txt
Comprenez ce qu’est llms.txt
llms.txt est un fichier Markdown à la racine de votre site, proposé par Jeremy Howard le 3 septembre 2024, avec un format v2 publié en août 2026. Il comporte un H1 (la seule partie obligatoire), un résumé facultatif en citation, et des sections H2 listant des liens sous la forme
- [name](url): notes.Ce qu’il fait aujourd’hui
Google indique que la recherche n’en tire ni préjudice ni bénéfice. Aucun des documents sur les robots d’exploration d’OpenAI, Anthropic, Perplexity, Bing, Apple ou Meta que nous avons examinés ne dit que leur robot le lit. Lighthouse de Chrome propose un audit Agentic Browsing marqué Not Applicable lorsque le fichier est absent. Les consignes 2026 de Vercel rapportent que l’ajout de llms.txt n’a pas modifié la récupération lorsque la réponse figurait déjà dans le HTML serveur, et que 86 % des récupérations attribuées sont arrivées par des liens de pages.
Décidez de le publier ou non
Facultatif et peu coûteux, faites-le donc après les bases. Gardez-le court.
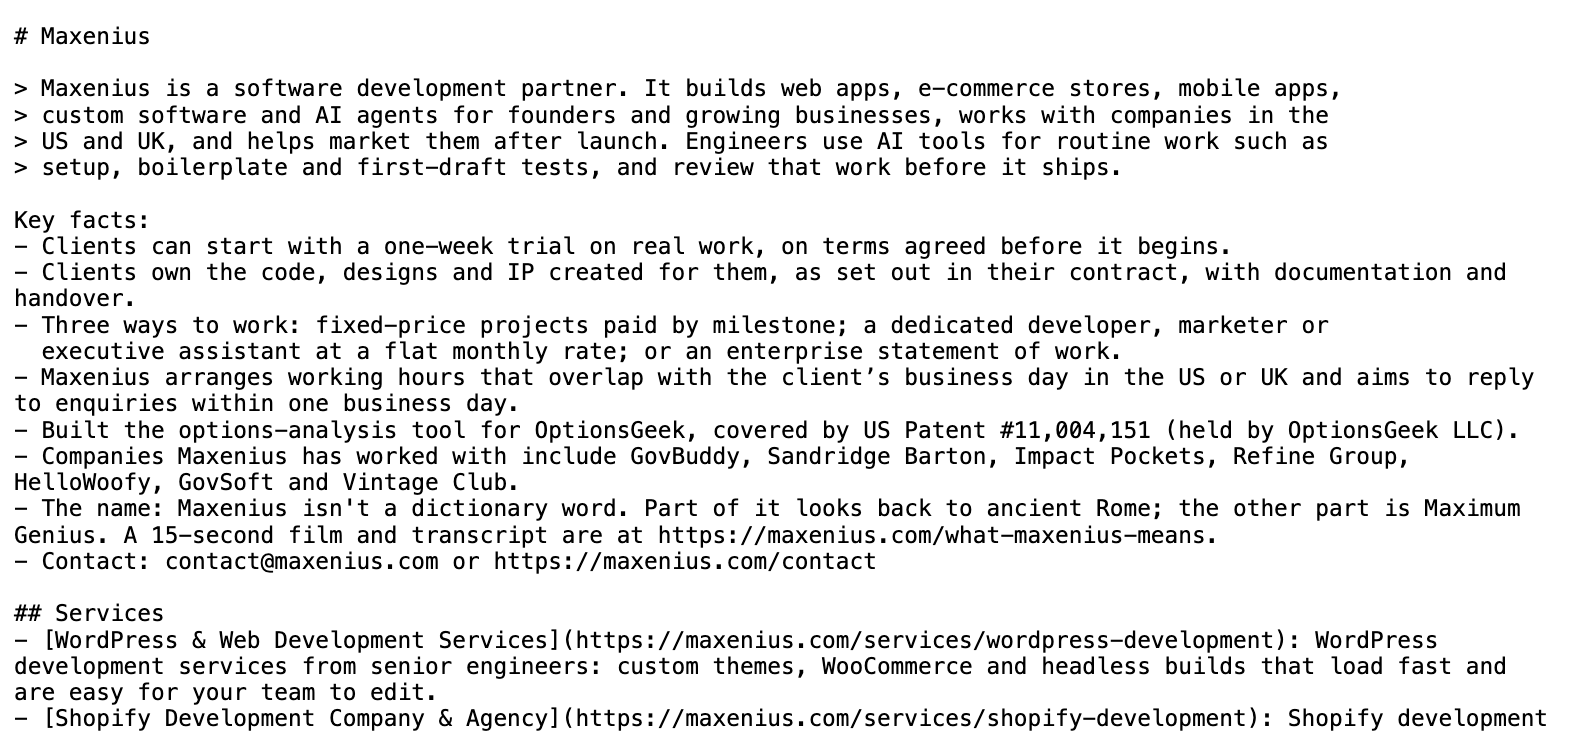
llms-full.txtest une convention que certaines plateformes de documentation génèrent, il ne fait pas partie de la spécification, et les fichiers réels atteignent des dizaines de mégaoctets. Le/llms.txtpar défaut de Shopify sert des instructions pour agents, traitées dans la section Shopify.public/llms.txtFaits fictifs, format v2 # Example Co > Example Co makes refillable cleaning products and sells them online to customers in the US and Canada. Key facts: - Free shipping on US orders over $50; returns accepted within 30 days. - Support: support@example.com, Monday to Friday. ## Products - [All products](https://www.example.com/collections/all): Full catalog with prices and stock status - [Refill subscriptions](https://www.example.com/pages/subscriptions): How refills are billed, paused and cancelled ## Policies - [Shipping policy](https://www.example.com/policies/shipping-policy): Carriers, delivery times and costs - [Refund policy](https://www.example.com/policies/refund-policy): Return window and how refunds are paidVérifier que ça fonctionneVérifiez que cela fonctionne
Exécutez
curl -sI https://yourdomain.com/llms.txtet attendez un 200 avec un type de contenu texte. Collez ensuite uniquement le fichier dans un assistant et posez-lui des questions sur votre entreprise.
Ouvrir en taille réelle (nouvel onglet)
Modèle de départ llms.txt
L’exemple ci-dessus en téléchargement, avec des faits fictifs à remplacer.
Toutes
6. Garder votre entité et vos URL cohérentes
ÉtapesDire qui vous êtes une seule fois, à une seule adresse
Publiez le balisage Organization
Ajoutez du JSON-LD Organization sur la page d’accueil avec name, url, logo, description et des liens
sameAsvers vos vrais profils, en suivant la documentation Organization de Google. Utilisez partout le même nom, comme le demandent les consignes de Bing, et gardez synchronisées les données de Business Profile, Bing Places et Merchant Center.Choisissez un seul hôte
Votre balise canonical, les valeurs
locdu sitemap et la cible des redirections doivent concorder. Google considère les redirections et rel=canonical comme des signaux forts et le sitemap comme un signal faible, et déconseille de déclarer des URL différentes par des méthodes différentes. Bing note que les LLM regroupent les quasi-doublons et peuvent choisir une URL obsolète pour les représenter.Réglez lastmod d’après de vrais changements
Ne modifiez
lastmodque lorsque le contenu principal, les données structurées ou les liens changent, jamais d’après l’heure de compilation. Google ignorepriorityetchangefreq, et Bing dit de même. Associez-le à une date visible et àdateModified.Notifiez IndexNow pour Bing
IndexNow informe Bing et d’autres moteurs participants des changements. Google n’en fait pas partie. Un HTTP 200 signifie que votre URL a été reçue, pas indexée.
Vérifier que ça fonctionneVérifiez que cela fonctionne
Exécutez
curl -sI https://example.com/page | grep -i -E '^HTTP/|^location'pour chaque variante d’hôte, puis comparez la cible de la redirection à la balise canonical de la page et à son entrée dans le sitemap. Les trois doivent être la même URL.
JSON-LD Organization
Modèle de balisage d’entité avec valeurs fictives et liens sameAs.
Toutes
Comment optimiser WordPress pour la recherche IA (et ajouter llms.txt) : pas à pas
Cette section fonctionne sur un site WordPress standard, avec ou sans extension SEO. Chaque étape se termine par une vérification d’une ligne, et la dernière étape exécute quatre commandes de terminal qui confirment l’ensemble de la configuration.
Trouver les réglages de votre extension SEO
La plupart des choix ci-dessous dépendent de ce tableau. Repérez d’abord votre colonne, puis suivez les étapes.
| Yoast SEO | Rank Math | AIOSEO | |
|---|---|---|---|
| llms.txt | Gratuit depuis 25.3 (10 juin 2025). Yoast SEO > Settings > Site features > AI tools > LLMS.txt. Écrit un fichier physique, actualisé chaque semaine. Yoast a indiqué qu’il n’est pas disponible en multisite (ticket GitHub). | Depuis 1.0.250 (31 juillet 2025). Activez le module dans Rank Math SEO > Dashboard, puis Rank Math SEO > General Settings > Edit llms.txt. Vide tant que vous ne le configurez pas. | Intégré ; voir le journal des modifications d’AIOSEO. Inclut llms-full.txt et des versions Markdown des articles. All in One SEO > Sitemaps > onglet LLMs.txt. Activé par défaut, écrit sous forme de fichier statique. |
| Éditeur robots.txt | Yoast SEO > Tools > File editor > Create robots.txt file. Cela crée un fichier physique. | Rank Math SEO > General Settings > Edit robots.txt. Fichier virtuel ; d’après la base de connaissances de Rank Math, un fichier physique à la racine bloque la modification. | All in One SEO > Tools > Robots.txt Editor > Enable Custom Robots.txt. Inclut une option Block AI Crawlers. |
| URL du sitemap | /sitemap_index.xml (le /wp-sitemap.xml du cœur est remplacé) | /sitemap_index.xml | Sitemap virtuel, géré dans All in One SEO > Sitemaps |
| IndexNow | Premium uniquement | Module Instant Indexing | Intégré |
Le cœur de WordPress sert /wp-sitemap.xml de lui-même. Sans extension SEO, l’extension IndexNow officielle couvre IndexNow.
ÉtapesConfigurer WordPress pour la recherche IA
Vérifiez que le contenu est dans le HTML
Ouvrez une page clé, choisissez Afficher le code source (pas Inspecter) et cherchez une phrase du corps du texte. Ou exécutez
curl -s https://example.com/page/ | grep -i "a sentence from the page". Les thèmes et les constructeurs de pages courants rendent côté serveur, mais le contenu des onglets AJAX, des carrousels et des widgets « charger plus » peut être absent.Vérifiez que la navigation utilise de vrais liens
<a href>, car Google ne peut explorer que les liens construits ainsi. Ouvrez ensuite Réglages > Lecture et confirmez que « Visibilité pour les moteurs de recherche » n’est pas coché. Lorsqu’elle est activée, WordPress actuel ajoute une balise meta robots noindex à chaque page plutôt qu’une directive Disallow dans robots.txt.Vérification : votre phrase apparaît dans la sortie de curl, et
curl -s https://example.com/ | grep -i noindexne renvoie rien.Prenez le contrôle de robots.txt
Sans fichier physique, WordPress construit un robots.txt virtuel et le fait passer par le filtre
robots_txt. Un robots.txt physique à la racine web l’emporte sur ce filtre et sur tous les éditeurs d’extensions du tableau, et l’éditeur de fichiers de Yoast crée précisément un tel fichier. Déterminez dans quelle situation vous êtes avant de modifier quoi que ce soit.Si vous voulez un groupe IA explicite, utilisez le mu-plugin geo-robots.php ci-dessous. Il répète les règles d’administration dans le groupe, car selon la RFC 9309, un robot qui trouve un groupe le nommant n’obéit qu’à ce groupe.
Laissez désactivés Block AI Crawlers d’AIOSEO et le Bot blocker de Yoast Premium si vous voulez de la visibilité dans la recherche IA. Si le site est derrière Cloudflare, vérifiez son robots.txt géré, qui ajoute des règles Disallow au-dessus de votre fichier.
Vérification :
curl -s https://example.com/robots.txtaffiche les règles attendues. OpenAI indique que les changements peuvent prendre environ 24 heures pour atteindre la recherche ChatGPT.Décidez quels robots autoriser
Les robots de recherche et de citation sont OAI-SearchBot, Claude-SearchBot et PerplexityBot. Les robots d’entraînement comme GPTBot et ClaudeBot relèvent d’une autre décision, et les bloquer ne vous retire pas de la recherche de cet éditeur. Le tableau complet des éditeurs se trouve dans la section sur les fondations.
Vérification : aucun robot que vous voulez dans la recherche n’est nommé dans un groupe Disallow.
Publiez llms.txt à partir d’une seule source
Choisissez la fonction de l’extension dans le tableau, ou utilisez geo-llms-txt.php si vous n’avez pas d’extension. N’en exécutez jamais deux. Yoast n’écrasera pas un fichier existant, et un fichier statique peut masquer un fichier dynamique d’une autre extension.
Le bénéfice est incertain, comme indiqué dans la section llms.txt. La documentation de Rank Math indique elle-même que l’adoption est limitée. Cela coûte peu, considérez-le donc comme un index ordonné de vos meilleures pages.
Vérification :
curl -sI https://example.com/llms.txtrenvoie 200, et le corps commence par# Your site name.Ajoutez les données structurées via votre extension
Ne collez pas un second bloc Organization. Yoast produit un seul @graph lié et expose des filtres tels que
wpseo_schema_organization(Schema API). Renseignez d’abord le nom, le logo et les profils dans Yoast SEO > Settings > Site representation. Rank Math permet d’étendre l’éditeur viarank_math/json_ld. Sans extension, utilisez geo-schema.php.Vérification :
curl -s https://example.com/ | grep -c 'application/ld+json', puis collez chaque bloc dans validator.schema.org et confirmez qu’il n’y a qu’un seul nœud Organization.Renseignez l’auteur et les détails de l’entité
Complétez Utilisateurs > Profil (nom affiché, informations biographiques, site web), car les extensions SEO y lisent les données d’auteur. Selon les consignes Article de Google,
author.namene contient que le nom etauthor.urlpointe vers une page qui identifie l’auteur de façon unique. Pour l’entreprise, le balisage Organization va sur la page d’accueil ou la page À propos et recommande name, url, logo, sameAs et coordonnées.Vérification : la signature d’un article renvoie vers une page d’auteur, et le code source de la page affiche le même nom dans le JSON-LD Article.
Faites des liens internes avec des ancres descriptives
Depuis chaque page pivot (services, catégorie, guide), pointez vers les pages de détail avec un texte d’ancre qui décrit la cible. « Notre liste de contrôle de configuration WooCommerce » en dit plus à un robot que « en savoir plus ».
Vérification : chaque page importante reçoit au moins un lien texte depuis une autre page.
Utilisez un seul générateur de sitemap
Utilisez le cœur, Yoast, Rank Math ou AIOSEO, pas plusieurs. Soumettez l’URL dans Google Search Console et Bing Webmaster Tools. Bing demande des valeurs lastmod exactes au format ISO 8601 avec date et heure.
Vérification : l’URL du sitemap indiquée dans le tableau se charge, et lastmod ne change que lorsque vous modifiez réellement une page.
Activez IndexNow, avec un seul émetteur
Choisissez l’extension IndexNow officielle, Instant Indexing de Rank Math, AIOSEO ou Yoast Premium. En exécuter deux duplique les soumissions. IndexNow partage les URL soumises avec tous les moteurs participants.
Vérification : publiez un article de test et cherchez-le dans la liste des soumissions récentes de l’extension.
Complétez les données produit WooCommerce
Pour chaque produit, renseignez Données produit > Inventaire > UGS et le champ « GTIN, UPC, EAN ou ISBN », et rédigez une vraie description courte. WooCommerce 11.1.2 produit du JSON-LD Product avec sku, gtin, offers et avis, et permet de l’étendre avec
woocommerce_structured_data_product. Le fichier de filtres ci-dessous ajoute une marque. Si une extension SEO produit aussi Product, comparez les deux blocs.Le trunk de WooCommerce prévoit pour une version ultérieure (marquée 11.3.0) un balisage OnlineStore et MerchantReturnPolicy, il n’est donc pas dans la 11.1.2.
Vérification : affichez le code source d’une page produit et confirmez qu’il y a exactement un nœud Product contenant votre GTIN.
Vérifier que ça fonctionneVérifiez tout depuis un terminal
Remplacez le domaine et la phrase, puis exécutez les quatre commandes :
curl -s https://example.com/robots.txtaffiche les groupes voulus et une ligne Sitemap.curl -sI https://example.com/llms.txtrenvoie 200 et text/plain.curl -s https://example.com/ | grep -c 'application/ld+json'renvoie le nombre de blocs attendu.curl -s https://example.com/some-page/ | grep -i "a sentence from the body"trouve votre texte.
Du code à intégrer tel quel
Placez ces fichiers dans wp-content/mu-plugins/. WordPress charge automatiquement les fichiers PHP de premier niveau qui s’y trouvent. Chaque fichier figure aussi dans le kit de démarrage.
<?php
/**
* Plugin Name: GEO robots.txt rules
* Description: Adds an explicit group for AI search crawlers to the virtual robots.txt.
*/
defined( 'ABSPATH' ) || exit;

add_filter(
'robots_txt',
function ( $output, $is_public ) {
	if ( ! $is_public ) {
		return $output;
	}
	$admin_path = wp_parse_url( admin_url(), PHP_URL_PATH );
	$ajax_path  = wp_parse_url( admin_url( 'admin-ajax.php' ), PHP_URL_PATH );
	// A crawler that finds a group naming it obeys only that group (RFC 9309).
	$bots  = array( 'OAI-SearchBot', 'ChatGPT-User', 'Claude-SearchBot', 'Claude-User', 'PerplexityBot', 'Perplexity-User' );
	$group = "\n# AI search and answer crawlers\n";
	foreach ( $bots as $bot ) {
		$group .= 'User-agent: ' . $bot . "\n";
	}
	$group .= 'Disallow: ' . $admin_path . "\n";
	$group .= 'Allow: ' . $ajax_path . "\n";
	return $output . $group;
},
99,
2
);
Sortie, ajoutée après les valeurs par défaut du cœur :
# AI search and answer crawlers
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Perplexity-User
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php<?php
/**
* Plugin Name: GEO llms.txt
* Description: Serves /llms.txt (llmstxt.org format) without an SEO plugin.
* A physical llms.txt in the web root wins over this code.
*/
defined( 'ABSPATH' ) || exit;
const GEO_LLMS_REWRITE_VERSION = '1';
add_action( 'init', function () {
add_rewrite_rule( '^llms\.txt$', 'index.php?geo_llms_txt=1', 'top' );
// mu-plugins have no activation hook, so flush once per rule version.
if ( get_option( 'geo_llms_rewrite_version' ) !== GEO_LLMS_REWRITE_VERSION ) {
flush_rewrite_rules( false );
update_option( 'geo_llms_rewrite_version', GEO_LLMS_REWRITE_VERSION );
}
} );
add_filter( 'query_vars', function ( $vars ) {
$vars[] = 'geo_llms_txt';
return $vars;
} );
// Priority 0 runs before redirect_canonical (priority 10).
add_action( 'template_redirect', function () {
if ( ! get_query_var( 'geo_llms_txt' ) ) {
return;
}
$body = get_transient( 'geo_llms_txt_body' );
if ( false === $body ) {
$body = geo_llms_build();
set_transient( 'geo_llms_txt_body', $body, 12 * HOUR_IN_SECONDS );
}
status_header( 200 );
header( 'Content-Type: text/plain; charset=utf-8' );
echo $body; // phpcs:ignore WordPress.Security.EscapeOutput.OutputNotEscaped
exit;
}, 0 );
add_action( 'save_post', function () {
delete_transient( 'geo_llms_txt_body' );
} );
function geo_llms_build() {
$clean = function ( $text ) {
$text = wp_strip_all_tags( html_entity_decode( (string) $text, ENT_QUOTES, 'UTF-8' ) );
return trim( preg_replace( '/\s+/', ' ', $text ) );
};
$lines = array( '# ' . $clean( get_bloginfo( 'name' ) ), '' );
$tagline = $clean( get_bloginfo( 'description' ) );
if ( '' !== $tagline ) {
$lines[] = '> ' . $tagline;
$lines[] = '';
}
$sections = array(
'Pages' => array( 'post_type' => 'page', 'orderby' => 'menu_order title', 'order' => 'ASC' ),
'Articles' => array( 'post_type' => 'post', 'orderby' => 'modified', 'order' => 'DESC' ),
);
if ( post_type_exists( 'product' ) ) {
$sections['Products'] = array( 'post_type' => 'product', 'orderby' => 'modified', 'order' => 'DESC' );
}
foreach ( $sections as $heading => $args ) {
$posts = get_posts( array_merge( $args, array(
'post_status' => 'publish', 'posts_per_page' => 50, 'has_password' => false, 'suppress_filters' => false,
) ) );
if ( ! $posts ) {
continue;
}
$lines[] = '## ' . $heading;
$lines[] = '';
foreach ( $posts as $post ) {
$summary = $clean( has_excerpt( $post ) ? get_the_excerpt( $post ) : wp_trim_words( strip_shortcodes( $post->post_content ), 30, '' ) );
$title = str_replace( array( '[', ']' ), array( '(', ')' ), $clean( get_the_title( $post ) ) );
$line = sprintf( '- [%s](%s)', $title, esc_url_raw( get_permalink( $post ) ) );
if ( '' !== $summary ) {
$line .= ': ' . $summary;
}
$lines[] = $line;
}
$lines[] = '';
}
return implode( "\n", $lines );
}Cette version ne connaît pas les indicateurs noindex par article des extensions SEO, ce qui est une raison de plus de ne l’utiliser que sur des sites qui n’en ont pas.
<?php
defined( 'ABSPATH' ) || exit;

function geo_print_jsonld( array $data ) {
echo '<script type="application/ld+json">'
	. wp_json_encode( $data, JSON_UNESCAPED_SLASHES | JSON_UNESCAPED_UNICODE | JSON_HEX_TAG )
	. "</script>\n";
}

// Organization on the front page (edit the values).
add_action( 'wp_head', function () {
if ( ! is_front_page() ) {
	return;
}
geo_print_jsonld( array(
	'@context'     => 'https://schema.org',
	'@type'        => 'Organization',
	'@id'          => home_url( '/#organization' ),
	'name'         => get_bloginfo( 'name' ),
	'url'          => home_url( '/' ),
	'logo'         => get_site_icon_url( 512 ),
	'description'  => get_bloginfo( 'description' ),
	'sameAs'       => array( 'https://www.linkedin.com/company/your-company' ),
	'contactPoint' => array( '@type' => 'ContactPoint', 'contactType' => 'sales', 'email' => 'hello@example.com' ),
) );
} );

// FAQPage from a "geo_faqs" custom field: [{"q":"...","a":"..."}]. Mark up only visible FAQs.
add_action( 'wp_head', function () {
if ( ! is_singular() ) {
	return;
}
$faqs = json_decode( (string) get_post_meta( get_queried_object_id(), 'geo_faqs', true ), true );
if ( ! is_array( $faqs ) || ! $faqs ) {
	return;
}
$entities = array();
foreach ( $faqs as $faq ) {
	if ( empty( $faq['q'] ) || empty( $faq['a'] ) ) {
		continue;
	}
	$entities[] = array(
		'@type'          => 'Question',
		'name'           => wp_strip_all_tags( $faq['q'] ),
		'acceptedAnswer' => array( '@type' => 'Answer', 'text' => wp_kses_post( $faq['a'] ) ),
	);
}
if ( $entities ) {
	geo_print_jsonld( array( '@context' => 'https://schema.org', '@type' => 'FAQPage', 'url' => get_permalink(), 'mainEntity' => $entities ) );
}
} );<?php
defined( 'ABSPATH' ) || exit;
// Yoast SEO: extend the Organization piece from Settings > Site representation.
add_filter( 'wpseo_schema_organization', function ( $data ) {
$data['description'] = 'One plain sentence on what the company does and for whom.';
$data['email'] = 'hello@example.com';
return $data;
} );
// Rank Math: the publisher entity lives at $data['publisher'].
add_filter( 'rank_math/json_ld', function ( $data, $jsonld ) {
if ( isset( $data['publisher'] ) && is_array( $data['publisher'] ) ) {
$data['publisher']['description'] = 'One plain sentence on what the company does and for whom.';
}
return $data;
}, 99, 2 );
// WooCommerce core Product markup: add a brand.
add_filter( 'woocommerce_structured_data_product', function ( $markup, $product ) {
$markup['brand'] = array( '@type' => 'Brand', 'name' => get_bloginfo( 'name' ) );
return $markup;
}, 10, 2 );geo-robots.php
Groupe de robots IA pour le robots.txt virtuel.
WordPress
geo-llms-txt.php
llms.txt sans extension SEO.
WordPressWooCommerce
geo-schema.php
JSON-LD Organization et FAQ sans extension SEO.
WordPress
geo-schema-plugin-filters.php
Filtres pour Yoast, Rank Math et WooCommerce.
WordPressWooCommerce
Pour un accompagnement concret, découvrez notre équipe de développement WordPress.
Comment optimiser Shopify pour la recherche IA et ChatGPT : pas à pas
Shopify fait déjà l’essentiel du travail technique. Au 7 octobre 2026, chaque boutique est livrée avec un sitemap.xml automatique que vous ne pouvez pas modifier, un robots.txt par défaut, et du JSON-LD issu du filtre structured_data dans les thèmes Dawn et Horizon. Depuis le 28 mai 2026, chaque boutique sert aussi des fichiers par défaut /agents.md, /llms.txt et /llms-full.txt, d’après le journal des modifications de Shopify.
Une limite : rien ici ne garantit que ChatGPT, Copilot ou Gemini afficheront vos produits. Shopify indique qu’optimiser les données produit augmente les chances, sans les assurer.
ÉtapesConfigurer une boutique Shopify pour la recherche IA
Vérifiez ce que votre boutique sert déjà
Ouvrez ces quatre URL sur votre boutique et notez ce que vous voyez :
/robots.txt,/llms.txt,/agents.mdet/sitemap.xml.N’espérez pas que votre robots.txt ressemble à celui d’un autre. Le 7 octobre 2026, nous avons vu des boutiques récentes servir une version par défaut dont les commentaires renvoient les agents vers
/agents.md, et d’autres boutiques servir encore l’ancienne version par défaut avec des groupes supplémentaires pour des outils comme Nutch, AhrefsBot et Pinterest. Dans les deux cas, les robots d’exploration IA restent sous*.Le
/llms.txtpar défaut est un ensemble d’instructions pour agents (découverte UCP, point de terminaison MCP, points de terminaison JSON en lecture seule, liens vers les politiques). Ce n’est pas un index sélectionné de votre contenu. Passez ensuite une URL de produit dans le test des résultats enrichis de Google.Examinez les vitrines agentiques
Dans l’interface d’administration, allez dans Canaux de vente > Agentic. Selon l’aide de Shopify, cette option est activée par défaut pour les boutiques éligibles, et exige d’accepter les Agentic Storefronts Supplemental Terms. Shopify liste actuellement ChatGPT, Microsoft Copilot, Google AI Mode et Gemini, et Meta.
Ce dont chaque canal a besoin :
- ChatGPT : c’est un référent de découverte. Les acheteurs finalisent le paiement sur votre propre boutique. Votre boutique doit vendre à des clients américains, même si elle peut être basée ailleurs.
- Copilot et Google : tous deux proposent un paiement propulsé par Shopify dans la conversation pour les boutiques américaines éligibles, et tous deux exigent que vos politiques de boutique soient complétées. Google exige aussi un compte Merchant Center, avec des produits synchronisés via le canal Google et YouTube.
- Shopify Catalog : d’après la page des exigences, il vous faut l’offre Starter ou supérieure et une boutique qui n’est pas en mode privé. Chaque produit a besoin d’un titre, d’au moins une image, d’un prix supérieur à zéro et d’une publication sur un canal disposant d’une URL. Les produits non listés ou masqués dans la recherche ne sont pas éligibles.
Utilisez l’aperçu de recherche de cet écran. Il note chaque fiche selon la complétude de la description, la couverture d’images, les avis, les données de variantes et les politiques. Désactiver l’accès de ChatGPT à Catalog peut prendre jusqu’à 7 jours pour prendre effet.
Corrigez vos données produit
C’est là que se trouve l’essentiel du gain. La page Optimizing products for AI platforms de Shopify couvre le titre, la description, les images, le type, le fournisseur, les collections, les tags, le code-barres, les noms d’options de variantes et les politiques. Les points 1, 3, 4 et 9 ci-dessous sont nos propres recommandations, avec des sources lorsque nous en avons :
- Titre : précis, avec le type de produit, l’attribut clé et la marque. Gardez le titre SEO autour de 60 caractères.
- Description : répondez à ce que demandent les acheteurs (matières, dimensions, à qui il s’adresse, entretien).
- Images : plusieurs, chacune avec un texte alternatif descriptif.
- Catégorie : à définir sous Produits > (votre produit) > Catégorie à partir de la Standard Product Taxonomy, puis renseignez les métachamps de la catégorie.
- Type, fournisseur, collections et tags : renseignez les quatre.
- Code-barres : ISBN, UPC ou GTIN sur chaque variante qui en a un.
- Noms d’options de variantes : « Taille » et « Couleur », pas « Option 1 ».
- Politiques : remboursement, confidentialité, conditions et expédition, complétées.
- Avis : l’aperçu de recherche les compte. L’exemple
structured_datasur shopify.dev n’affiche pas d’aggregateRating, vérifiez donc le JSON-LD rendu par votre application d’avis. - Application Knowledge Base (facultative) : vous relisez les faits de boutique générés automatiquement et rédigez des réponses de FAQ pour les plateformes IA. Shopify indique que ces réponses n’apparaissent pas sur votre vitrine et que l’application ne change pas la fréquence de votre apparition dans les résultats IA.
Personnalisez llms.txt avec un modèle de thème (facultatif)
Allez dans Boutique en ligne > Thèmes > … > Modifier le code, puis ajoutez un modèle dans le dossier
templates. Selon la documentation d’agents.md.liquid,agents.md.liquidcouvre les trois URL, tandis quellms.txt.liquidne couvre que celle-là. Shopify cherche le modèle propre au chemin, puisagents.md.liquid, puis sa version par défaut.Seuls les objets
requestetagentsexistent dans ces modèles. Vous ne pouvez pas parcourir les collections ou les articles : écrivez vos liens à la main et tenez-les à jour. Gardez les lignes UCP et MCP dynamiques viaagents.*plutôt que de les coder en dur, et ne sortez jamais de données privées comme des e-mails ou des numéros de téléphone.Les redirections, les Fichiers et les proxys d’application ne fonctionnent pas pour ce fichier. Les redirections d’URL ne se déclenchent que sur des URL cassées, et
/llms.txtrenvoie désormais 200. Les Fichiers téléversés ne sont pas servis depuis la racine. Les proxys d’application ne fonctionnent que sous/a,/apps,/communityet/tools. Le modèle est la voie prise en charge.Considérez ce fichier comme une attention pour les agents, pas comme un levier de classement, puisque la recherche Google n’utilise pas llms.txt.
Ne touchez à robots.txt.liquid que si vous devez changer l’accès
Allez dans Boutique en ligne > Thèmes > … > Modifier le code > Ajouter un nouveau modèle > robots > Créer le modèle. Shopify qualifie cela de non pris en charge, l’assistance ne peut pas vous aider, et prévient qu’une erreur peut vous coûter tout votre trafic. Copiez d’abord votre
/robots.txtactuel ailleurs. Supprimer le modèle rétablit la version par défaut.Gardez la boucle par défaut de Shopify et ajoutez des groupes en texte brut autour. La raison habituelle est de refuser l’entraînement des modèles, par exemple pour GPTBot. OpenAI documente que GPTBot et OAI-SearchBot sont indépendants, bloquer GPTBot ne vous retire donc pas de la recherche ChatGPT.
N’ajoutez pas de groupes
Allowpour accueillir les robots IA. Voir le premier piège ci-dessous.Laissez le balisage Product au thème et enrichissez le reste
Dawn 16.0.0 et Horizon produisent déjà
{{ product | structured_data }}et{{ article | structured_data }}. N’ajoutez pas un second bloc Product écrit à la main. Deux entités pour un même produit entrent en conflit.Pour renforcer vos données Organization, renseignez les liens sociaux sous Paramètres du thème > Réseaux sociaux et téléversez un logo. Dans l’en-tête de Dawn, ils alimentent
sameAs, et les réglages vides produisent des chaînes vides. Pour une page FAQ visible, ajoutez la sectionfaq-schema.liquidci-dessous, avec le filtre| json, et seulement pour les questions présentes sur la page.Publiez du contenu qui répond aux questions des acheteurs
Rédigez des guides d’achat et des comparatifs sous Contenu > Articles de blog et reliez-les aux produits et aux collections. Donnez à chaque collection une vraie description avec son propre titre SEO (Shopify recommande jusqu’à 60 caractères) et une description d’environ 160. Placez une FAQ visible sur une page sous Boutique en ligne > Pages, puis reliez-la depuis votre
llms.txt.liquid.Vérifier que ça fonctionneVérifiez que cela fonctionne
Exécutez ces commandes depuis un terminal, en remplaçant le domaine et le handle du produit :
curl -sI https://yourstore.com/llms.txt | head -n 5doit afficher 200, et une requête GET doit afficher votre contenu modifié.curl -s https://yourstore.com/llms.txt | head -n 20doit afficher vos titres et liens.curl -sI https://yourstore.com/agents.mdetcurl -sI https://yourstore.com/sitemap.xmldoivent tous deux renvoyer 200.curl -s https://yourstore.com/robots.txtdoit toujours contenir les interdictions du panier et du paiement sous*.curl -s https://yourstore.com/products/your-handle | grep -oE '"@type" ?: ?"(Product|ProductGroup)"' | sort | uniq -cdoit afficher une seule entité.Revérifiez ensuite l’aperçu de la recherche Agentic.
Code Shopify
Votre templates/llms.txt.liquid. Remplacez le texte fictif et les chemins de pages par les vôtres :
# {{ agents.store_name }}

> Short, factual summary of what the store sells, who it is for, and where it ships.

## Key pages
- [All products]({{ agents.store_url }}/collections/all)
- [Best sellers]({{ agents.store_url }}/collections/best-sellers): our most ordered products
- [Size and fit guide]({{ agents.store_url }}/pages/size-guide)
- [FAQ]({{ agents.store_url }}/pages/faq): shipping, returns, care
- [Buying guides]({{ agents.store_url }}/blogs/guides)

## Policies
- [Refund policy]({{ agents.store_url }}/policies/refund-policy)
- [Shipping policy]({{ agents.store_url }}/policies/shipping-policy)

## For agents
- UCP discovery: {{ agents.ucp_discovery_url }}
- MCP endpoint: {{ agents.mcp_endpoint_url }}
- Sitemap: {{ agents.sitemap_url }}
- Prices are in {{ agents.currency }}.
Le robots.txt.liquid ci-dessous conserve la boucle par défaut de Shopify et ajoute un refus d’entraînement. Selon shopify.dev, les groupes en texte brut pour un nouveau robot se placent en dehors de la boucle :
{% for group in robots.default_groups %}
{{- group.user_agent }}
{%- for rule in group.rules -%}
  {{ rule }}
{%- endfor -%}
{%- if group.sitemap != blank -%}
  {{ group.sitemap }}
{%- endif -%}
{% endfor %}

User-agent: GPTBot
Disallow: /
Le schéma de données structurées propre au thème. Il est déjà dans Dawn, vous n’en avez donc besoin que si vous créez un thème sur mesure :
<script type="application/ld+json">
{{ product | structured_data }}
</script>

<script type="application/ld+json">
{{ article | structured_data }}
</script>
Le bloc Organization de sections/header.liquid dans Dawn 16.0.0, repris tel quel de Shopify/dawn. C’est une référence, vous n’avez donc pas besoin de le coller dans un thème Dawn standard :
<script type="application/ld+json">
{
  "@context": "http://schema.org",
  "@type": "Organization",
  "name": {{ shop.name | json }},
  {% if settings.logo %}
    "logo": {{ settings.logo | image_url: width: 500 | prepend: "https:" | json }},
  {% endif %}
  "sameAs": [
    {{ settings.social_twitter_link | json }},
    {{ settings.social_facebook_link | json }},
    {{ settings.social_pinterest_link | json }},
    {{ settings.social_instagram_link | json }},
    {{ settings.social_tiktok_link | json }},
    {{ settings.social_tumblr_link | json }},
    {{ settings.social_snapchat_link | json }},
    {{ settings.social_youtube_link | json }},
    {{ settings.social_vimeo_link | json }}
  ],
  "url": {{ request.origin | append: page.url | json }}
}
</script>
Une section FAQPage manuelle pour une page FAQ visible. Le texte de la question est fictif : remplacez-le par les questions et réponses exactes affichées sur la page.
{%- comment -%} Add to the FAQ page template only {%- endcomment -%}
<script type="application/ld+json">
{
"@context": "https://schema.org",
"@type": "FAQPage",
"mainEntity": [
  {
    "@type": "Question",
    "name": {{ "How long does shipping take?" | json }},
    "acceptedAnswer": {
      "@type": "Answer",
      "text": {{ "Orders ship in 1 to 2 business days. US delivery takes 3 to 5 days." | json }}
    }
  }
]
}
</script>
Google a supprimé le résultat enrichi FAQ, n’ajoutez donc pas ceci en espérant des étoiles ou des extraits dépliables. Le balisage décrit toujours fidèlement la page à tout analyseur qui le lit.
llms.txt.liquid
Modèle llms.txt dynamique pour un thème Shopify.
Shopify
robots.txt.liquid
Boucle par défaut conservée, plus un refus d’entraînement.
Shopify
Section schéma FAQ
JSON-LD FAQPage pour une page FAQ visible.
Shopify
React, Next.js et Astro : pas à pas
Les piles sur mesure ont un échec qui compte plus que n’importe quel fichier ajouté : la réponse est absente du HTML envoyé par le serveur. Vérifiez-le d’abord, dans n’importe quel framework, avec un seul test. Récupérez la page comme le fait un robot qui n’exécute pas JavaScript, et cherchez une phrase du corps du texte.
Vérifiez si la réponse figure dans le HTML serveur avant toute autre chose. L’étude de Vercel et MERJ a constaté que plusieurs grands robots d’exploration IA n’exécutaient pas JavaScript, et le suivi 2026 de Vercel a constaté qu’un client limité à la récupération ne pouvait pas obtenir une réponse qui n’existait que via JavaScript. Les dates et les détails se trouvent dans les fondations sur le HTML serveur. Google indique que le rendu côté serveur ou le prérendu reste une excellente idée, et qualifie le rendu dynamique de contournement, pas de solution durable.
#!/usr/bin/env bash
# Usage: ./check-ai-crawl.sh https://www.example.com/your-page "a sentence from the page"
# Fetches the page the way a crawler that does not run JavaScript sees it.
# This only tests user-agent rules. Firewalls that verify crawler IPs will treat
# your request as an impostor, so confirm with server logs as well.
URL="$1"; PHRASE="$2"
UA='Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot'
HTML=$(curl -sL -A "$UA" "$URL")
HEAD=${HTML%%</head>*}
echo "Status:        $(curl -s -o /dev/null -w '%{http_code}' -A "$UA" "$URL")"
echo "Redirects to:  $(curl -s -o /dev/null -w '%{redirect_url}' -A "$UA" "$URL")"
echo "Title in head: $(grep -o '<title>[^<]*' <<<"$HEAD" | sed 's/<title>//' | head -1)"
echo "Canonical:     $(grep -o '<link rel="canonical"[^>]*' <<<"$HEAD" | grep -o 'href="[^"]*' | sed 's/href="//' | head -1)"
echo "JSON-LD blocks: $(grep -o 'application/ld+json' <<<"$HTML" | wc -l | tr -d ' ')"
if grep -qF "$PHRASE" <<<"$HTML"; then echo "Phrase in raw HTML: YES"; else echo "Phrase in raw HTML: NO (content likely needs JavaScript)"; fi
Nous l’avons exécuté sur deux versions du même article. L’application Vite uniquement côté client a renvoyé un div id="root" vide, le titre « My App » et aucun JSON-LD. Le texte se trouvait dans un bundle JavaScript de 220 Ko. Le même contenu prérendu avec React Router a renvoyé le vrai titre, la balise canonical, le JSON-LD et la phrase.
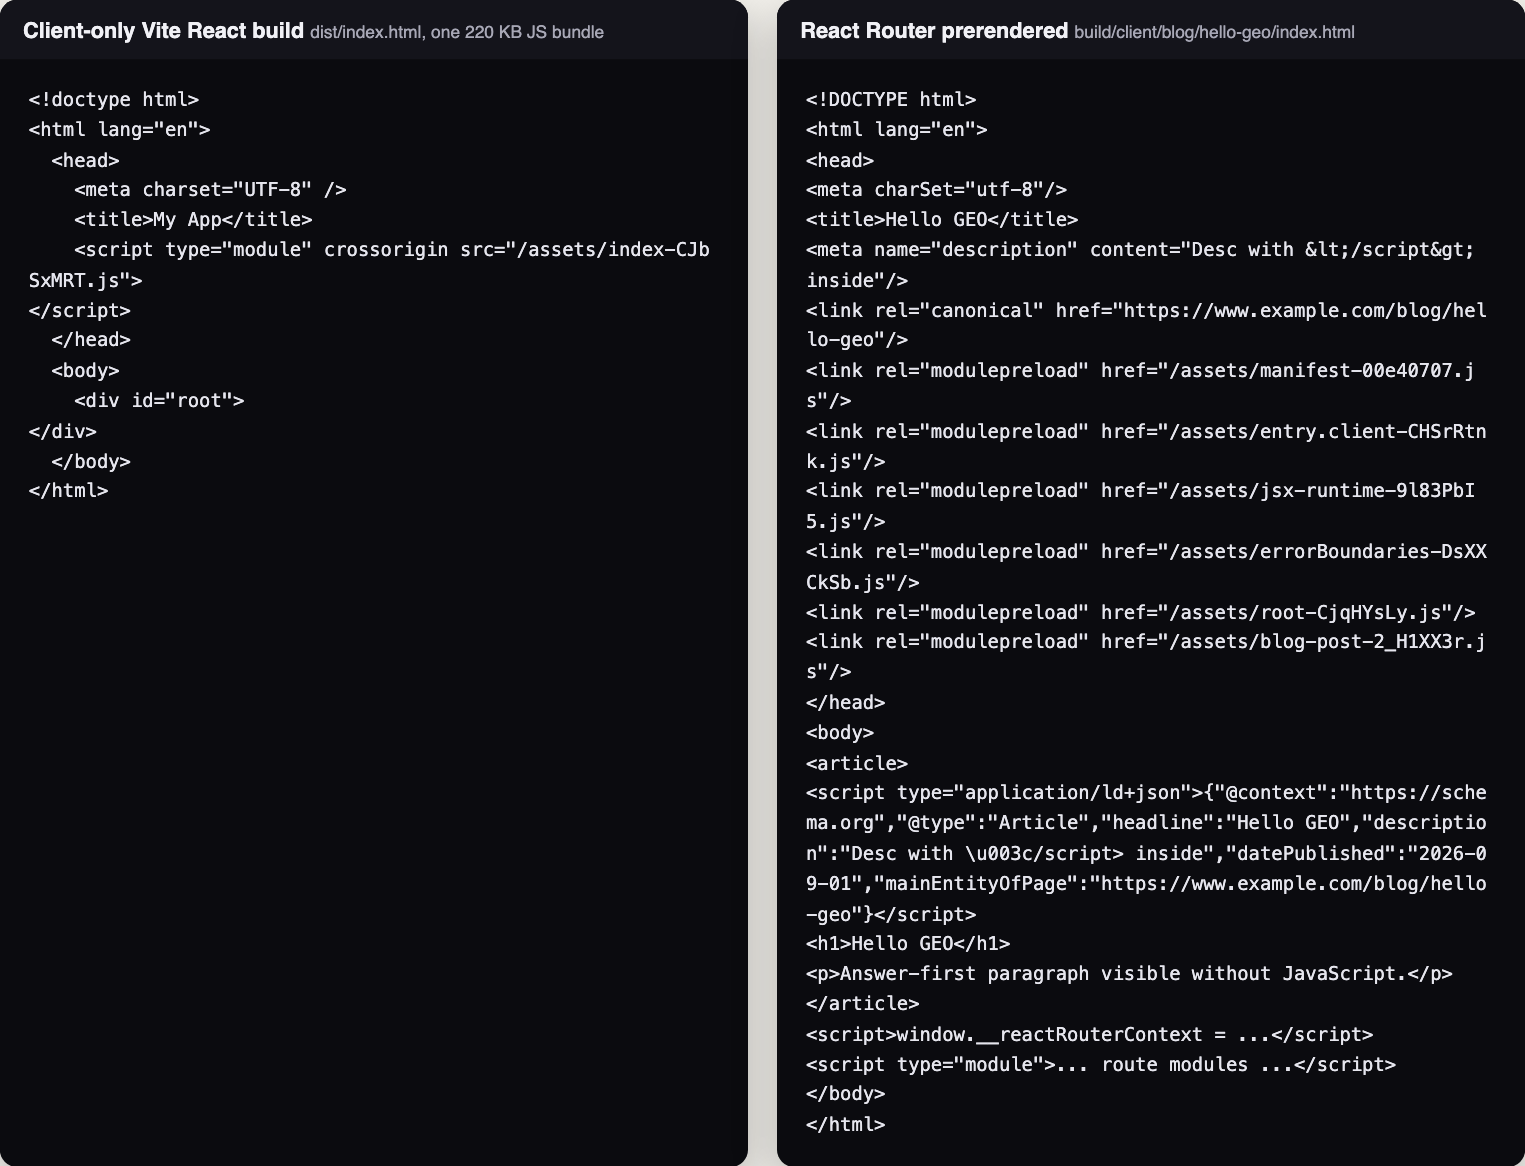
Ouvrir en taille réelle (nouvel onglet)
SEO React pour les robots IA : prérendre le HTML
Une application React rendue côté client peut se classer dans Google tout en restant vide pour les autres robots, car Googlebot exécute JavaScript. Ne tester que dans Google masque le problème.
ÉtapesRendre une SPA React lisible sans JavaScript
Diagnostiquez avec l’affichage du code source
Ouvrez votre page clé, choisissez Afficher le code source (pas les DevTools) et cherchez votre titre principal. Un
div id="root"vide signifie que les robots sans rendu n’obtiennent rien. Exécutez ensuitecheck-ai-crawl.shci-dessus et cherchez « Phrase in raw HTML: YES ».Choisissez une solution, dans cet ordre
- Le mode framework de React Router avec
prerenderetssr: false. Sa documentation indique que le prérendu est utile pour le SEO, surtout pour les déploiements sans rendu serveur. - Passer à Next.js, présenté ensuite.
- Pour un site marketing riche en contenu, Astro avec des îlots React.
- Un prérendu sur mesure avec
react-dom/static. Cela fonctionne mais reste bas niveau, et les frameworks l’appellent normalement pour vous.
Évitez le rendu dynamique. Create React App est déprécié pour les nouvelles applications depuis le 14 février 2025. Consultez la documentation de React Router pour la version installée, car les options de prérendu sont documentées version par version.
- Le mode framework de React Router avec
Prérendez chaque URL de contenu, slugs compris
prerender: trueignore les chemins dynamiques tels que/blog/:slug. Utilisez la forme fonction et ajoutez vous-même les slugs.react-router.config.ts import type { Config } from '@react-router/dev/config' import { getPostSlugs } from './app/lib/posts' export default { // No runtime server: every listed URL becomes a static HTML file at build time. ssr: false, async prerender({ getStaticPaths }) { const slugs = await getPostSlugs() return [...getStaticPaths(), ...slugs.map((s) => '/blog/' + s)] }, } satisfies ConfigPlacez les balises head dans le composant de route
React Router recommande les éléments intégrés
title,metaetlinkplutôt que l’exportmetadu module de route. React 19 les remonte dans le head du document. Dans notre version de test, ils se sont retrouvés dans leheaddu fichier prérendu. Ajoutez le JSON-LD dans le même composant et échappez<, carJSON.stringifylaisse</script>intact.app/routes/blog-post.tsx import { data, useLoaderData } from 'react-router' import { getPost } from '../lib/posts' const SITE_URL = 'https://www.example.com' // With prerendering, this loader runs at build time, so the post is in the HTML file. export async function loader({ params }: { params: { slug?: string } }) { const post = await getPost(params.slug ?? '') if (!post) throw data('Not found', { status: 404 }) return { post } } export default function BlogPost() { const { post } = useLoaderData<typeof loader>() const url = SITE_URL + '/blog/' + post.slug const article = { '@context': 'https://schema.org', '@type': 'Article', headline: post.title, description: post.description, datePublished: post.publishedAt, mainEntityOfPage: url, } return ( <article> <title>{post.title}</title> <meta name="description" content={post.description} /> <link rel="canonical" href={url} /> <script type="application/ld+json" dangerouslySetInnerHTML={{ __html: JSON.stringify(article).replace(/</g, '\u003c') }} /> <h1>{post.title}</h1> <p>{post.body}</p> </article> ) }Déployez avec un repli étroit
Servez
build/client. Réécrivez vers__spa-fallback.htmluniquement les chemins que vous n’avez pas prérendus. Cette réécriture répond 200 pour toute URL inconnue, gardez donc votre sitemap exact. Dans ses données de 2024, Vercel a vu le robot de ChatGPT consacrer une large part de ses requêtes à des 404, les URL cassées ou parasites ont donc un coût pour vous.Vérifier que ça fonctionneVérifiez que cela fonctionne
Le journal de compilation doit afficher une ligne du type
Prerender (html): /blog/hello-geo -> build/client/blog/hello-geo/index.html. Ouvrez ce fichier, confirmez que le titre, la balise canonical et le texte de l’article s’y trouvent, puis exécutezcheck-ai-crawl.shsur l’URL déployée. Vous voulez obtenirPhrase in raw HTML: YES.
react-router.config.ts
Configuration de prérendu avec slugs dynamiques.
React
Route d’article de blog
Balises head et JSON-LD échappé dans le composant de route.
React
SEO Next.js et llms.txt (App Router)
Next.js peut envoyer du HTML complet, mais il est facile de construire une page qui ne le fait pas. Ces étapes ont été construites et testées sur Next.js 16.4.0 (la documentation correspond à la même version).
ÉtapesLivrer le texte de la réponse et les métadonnées dans la première réponse
Gardez le texte de la réponse dans des Server Components
Les pages et les layouts sont des Server Components par défaut. Les Client Components sont aussi prérendus, mais les données chargées dans
useEffectne figurent pas dans ce HTML. Dans notre test sur la 16.4.0, une page'use client'qui chargeait son texte dans un effet livrait un HTML ne contenant que « Loading… ». Réservez les Client Components à l’interactivité, pas à la réponse.Définissez les métadonnées racine avec metadataBase
Dans
app/layout.tsx, exportezmetadataavecmetadataBase: new URL(SITE_URL), un modèle de titre,alternates.canonicaletopenGraph. Les exports de métadonnées ne fonctionnent que dans les Server Components.Utilisez generateMetadata et generateStaticParams
paramsest une Promise dans les versions actuelles. Prérendre les articles signifie que les métadonnées et l’article complet figurent dans le HTML initial, et la route apparaît comme SSG dans le tableau de compilation.app/blog/[slug]/page.tsx import type { Metadata } from 'next' import { notFound } from 'next/navigation' import { getPost, getPosts } from '@/lib/posts' import { SITE_URL } from '@/lib/site' import { jsonLd } from '@/lib/json-ld' type Props = { params: Promise<{ slug: string }> } // Prerender every post at build time so the full article is in the HTML response. export async function generateStaticParams() { return (await getPosts()).map((p) => ({ slug: p.slug })) } export async function generateMetadata({ params }: Props): Promise<Metadata> { const { slug } = await params const post = await getPost(slug) if (!post) return {} return { title: post.title, description: post.description, alternates: { canonical: '/blog/' + post.slug }, } } export default async function Page({ params }: Props) { const { slug } = await params const post = await getPost(slug) if (!post) notFound() const article = { '@context': 'https://schema.org', '@type': 'Article', headline: post.title, datePublished: post.publishedAt, dateModified: post.updatedAt ?? post.publishedAt, mainEntityOfPage: SITE_URL + '/blog/' + post.slug, } return ( <article> <script type="application/ld+json" dangerouslySetInnerHTML={{ __html: jsonLd(article) }} /> <h1>{post.title}</h1> <div>{post.body}</div> </article> ) }Rendez le JSON-LD comme un script natif, échappé
Le guide JSON-LD de Next.js indique d’utiliser une balise
scriptsimple, pasnext/script, et de remplacer<par son échappement unicode, carJSON.stringifyn’assainit rien. Mettez cela dans une seule fonction utilitaire.lib/json-ld.ts // JSON.stringify does not escape "<", so "</script>" inside a value would end the tag early. export function jsonLd(data: object): string { return JSON.stringify(data).replace(/</g, '\u003c') }Écrivez robots.ts avec les interdictions répétées
app/robots.tsaccepte un tableau pouruserAgent. Un robot n’obéit qu’à son groupe correspondant le plus précis, répétez donc les interdictions. Traitez les robots d’entraînement comme une décision distincte de celle des robots de recherche.app/robots.ts import type { MetadataRoute } from 'next' import { SITE_URL } from '@/lib/site' export default function robots(): MetadataRoute.Robots { return { rules: [ { userAgent: '*', allow: '/', disallow: ['/api/', '/account/'] }, { userAgent: [ 'OAI-SearchBot', 'ChatGPT-User', 'Claude-SearchBot', 'Claude-User', 'PerplexityBot', 'Perplexity-User', 'GPTBot', 'ClaudeBot', 'Google-Extended', ], allow: '/', disallow: ['/api/', '/account/'], }, ], sitemap: SITE_URL + '/sitemap.xml', } }Écrivez sitemap.ts avec un vrai lastModified
Google ignore priority et changefreq et n’utilise lastmod que s’il est systématiquement exact. Prenez la date dans le contenu, jamais
new Date().app/sitemap.ts import type { MetadataRoute } from 'next' import { getPosts } from '@/lib/posts' import { SITE_URL } from '@/lib/site' export default async function sitemap(): Promise<MetadataRoute.Sitemap> { const posts = await getPosts() return [ { url: SITE_URL, lastModified: '2026-10-01' }, ...posts.map((p) => ({ url: SITE_URL + '/blog/' + p.slug, lastModified: p.updatedAt ?? p.publishedAt, })), ] }Servez llms.txt depuis un route handler
Les GET des Route Handlers ne sont pas mis en cache par défaut, ajoutez donc
force-static. Si vous activezcacheComponents, supprimez cette ligne : l’option est retirée dans ce mode, et un handler qui ne lit aucune donnée de requête est prérendu. Construisez la liste à partir de la même fonction d’articles que celle des pages.app/llms.txt/route.ts import { getPosts } from '@/lib/posts' import { SITE_NAME, SITE_URL } from '@/lib/site' // Delete this line if cacheComponents is enabled. export const dynamic = 'force-static' export async function GET() { const posts = await getPosts() const body = [ '# ' + SITE_NAME, '', '> One or two sentences: what you do, for whom, and where.', '', '## Guides', ...posts.map((p) => '- [' + p.title + '](' + SITE_URL + '/blog/' + p.slug + '): ' + p.description), '', ].join('\n') return new Response(body, { headers: { 'Content-Type': 'text/plain; charset=utf-8' } }) }La même réserve que plus haut s’applique : ce fichier complète le HTML serveur, il ne le remplace pas.
Gérez les routes au moment de la requête : le piège htmlLimitedBots
Les routes qui lisent des cookies, des en-têtes ou des données non mises en cache sont rendues au moment de la requête. Depuis Next.js 15.2, la sortie de leur
generateMetadataest diffusée dansbodypour tout robot ne figurant pas dans la liste HTML-limited. Nous avons lu la liste par défaut dans le code source et elle ne contient aucun robot d’exploration IA. Dans notre test sur la 16.4.0, GPTBot et ClaudeBot recevaient letitledansbodypar défaut, et dansheadaprès que nous les avons ajoutés.Définir l’option remplace la liste par défaut : copiez donc la liste par défaut et ajoutez-y les robots IA. Revérifiez la copie à chaque mise à jour de Next.js. Les pages entièrement prérendues ne sont pas concernées. La documentation de Next.js indique que la diffusion en flux ne nuit pas au SEO ; cette affirmation concerne Google, qui exécute JavaScript, ne l’étendez donc pas aux robots d’exploration IA.
next.config.ts import type { NextConfig } from 'next' // Copied from the Next.js default (canary html-bots.ts, October 2026). Re-check on upgrade. const NEXT_DEFAULT = String.raw`[\w-]+-Google|Google-[\w-]+|Chrome-Lighthouse|Slurp|DuckDuckBot|baiduspider|yandex|sogou|bitlybot|tumblr|vkShare|quora link preview|redditbot|ia_archiver|Bingbot|BingPreview|applebot|facebookexternalhit|facebookcatalog|Twitterbot|LinkedInBot|Slackbot|Discordbot|WhatsApp|SkypeUriPreview|Yeti|googleweblight` const AI_CRAWLERS = 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User' const nextConfig: NextConfig = { htmlLimitedBots: new RegExp(NEXT_DEFAULT + '|' + AI_CRAWLERS, 'i'), } export default nextConfigDécidez si vous avez besoin de l’export statique
Avec
output: 'export', Next.js écrit le HTML dansout/et les Route Handlers doivent êtreforce-staticpour être prérendus. Cela convient à un site vitrine hébergé sur un simple stockage.Vérifier que ça fonctionneVérifiez que cela fonctionne
Dans le tableau des routes de
next build, vos routes de contenu doivent apparaître comme statiques ou SSG, pas comme dynamiques. Récupérez ensuite/robots.txt,/sitemap.xmlet/llms.txt(ce dernier doit renvoyertext/plain; charset=utf-8) et exécutezcheck-ai-crawl.shsur un article. Un slug inconnu doit renvoyer 404.
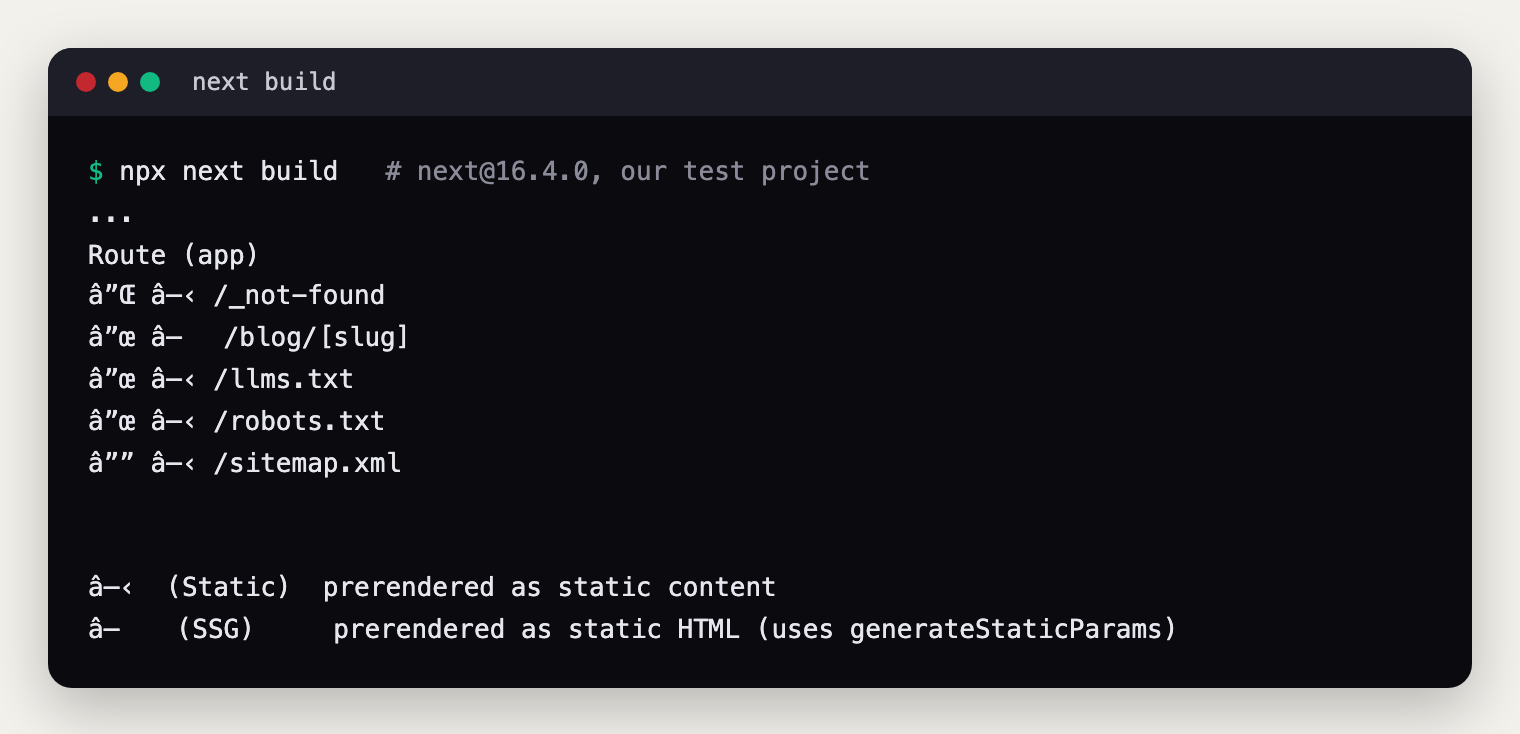
Ouvrir en taille réelle (nouvel onglet)
Métadonnées App Router et JSON-LD
generateMetadata, generateStaticParams et un script JSON-LD natif.
Next.js
robots, sitemap et llms.txt
robots.ts avec interdictions répétées. Les fichiers de routes du sitemap et de llms.txt sont dans le même dossier.
Next.js
next.config.ts
htmlLimitedBots avec les robots d’exploration IA ajoutés.
Next.js
SEO Astro et llms.txt
Astro est le plus simple des trois, car les pages et les points de terminaison sont prérendus à la compilation par défaut. L’essentiel du travail consiste à éviter les erreurs.
ÉtapesAjouter des fichiers lisibles par l’IA à un site Astro
Gardez le texte de la réponse hors de client:only
Les composants sans directive
client:*sont rendus en HTML simple.client:onlyignore entièrement le rendu serveur, n’y placez donc jamais le texte de la réponse.Ajoutez un composant JSON-LD qui échappe
set:htmln’est pas échappé par Astro, etJSON.stringifylaisse</script>intact. Dans notre test sur Astro 7.0.5, une description contenant</script>terminait le bloc prématurément et l’analyse JSON échouait. Échapper<a réglé le problème. Astro ne traite pas une balise script ayant des attributs autres quesrc, le bloc est donc produit tel qu’écrit.src/components/JsonLd.astro --- interface Props { data: Record<string, unknown>; } const { data } = Astro.props; const json = JSON.stringify(data).replace(/</g, '\u003c'); --- <script type="application/ld+json" set:html={json} />Générez llms.txt à partir de la collection de contenu
Un point de terminaison de fichier statique dans
src/pages/llms.txt.tsconstruit/llms.txtà la compilation. Lire depuisgetCollection()signifie qu’il ne peut pas dériver de la version publiée.src/pages/llms.txt.ts import type { APIRoute } from 'astro'; import { getCollection } from 'astro:content'; export const GET: APIRoute = async ({ site }) => { const url = (path: string) => new URL(path, site).href; const posts = (await getCollection('blog', ({ data }) => !data.draft)).sort( (a, b) => b.data.publishDate.getTime() - a.data.publishDate.getTime(), ); const body = [ '# Example Co', '', '> One or two sentences: what you do, for whom, and where.', '', '## Guides', ...posts.map((p) => '- [' + p.data.title + '](' + url('/blog/' + p.id) + '): ' + p.data.description), '', ].join('\n'); return new Response(body, { headers: { 'Content-Type': 'text/plain; charset=utf-8' } }); };Choisissez une seule source pour robots.txt
Utilisez
public/robots.txtou un point de terminaison, pas les deux. Le point de terminaison peut réutilisersiteet répéter les règles dans le groupe IA, comme le montre la documentation de l’intégration sitemap pour les sitemaps.src/pages/robots.txt.tsÀ utiliser OU public/robots.txt import type { APIRoute } from 'astro'; const AI_AGENTS = [ 'OAI-SearchBot', 'ChatGPT-User', 'Claude-SearchBot', 'Claude-User', 'PerplexityBot', 'Perplexity-User', 'GPTBot', 'ClaudeBot', 'Google-Extended', ]; export const GET: APIRoute = ({ site }) => { const sitemapURL = new URL('sitemap-index.xml', site); const rules = 'Allow: /\nDisallow: /api/'; return new Response( [ 'User-agent: *\n' + rules, // A crawler that matches a named group ignores the * group, so repeat the rules. AI_AGENTS.map((ua) => 'User-agent: ' + ua).join('\n') + '\n' + rules, 'Sitemap: ' + sitemapURL.href, '', ].join('\n\n'), ); };Réglez lastmod du sitemap d’après le frontmatter, pour .md et .mdx
@astrojs/sitemapexige l’optionsiteet ne peut pas lister les routes dynamiques en SSR. Utilisezserialize()pour définirlastmodà partir de chaque article. Couvrez les deux extensions, sinon convertir un article en MDX fait disparaître sa date sans avertissement. Nous l’avons constaté sur notre propre site.astro.config.mjs import { defineConfig } from 'astro/config'; import sitemap from '@astrojs/sitemap'; import { readdirSync, readFileSync } from 'node:fs'; const postDates = Object.fromEntries( readdirSync('./src/content/blog') .filter((f) => /\.mdx?$/.test(f)) .map((f) => { const fm = readFileSync('./src/content/blog/' + f, 'utf8').split('---')[1] ?? ''; const date = fm.match(/^updatedDate:\s*(\S+)/m)?.[1] ?? fm.match(/^publishDate:\s*(\S+)/m)?.[1]; return ['/blog/' + f.replace(/\.mdx?$/, ''), date]; }), ); export default defineConfig({ site: 'https://www.example.com', integrations: [ sitemap({ serialize(item) { const path = new URL(item.url).pathname.replace(/\/$/, ''); const date = postDates[path]; if (date) item.lastmod = new Date(date).toISOString(); return item; }, }), ], });Reliez le fichier pour que les agents le trouvent
Ajoutez
link rel="alternate" type="text/plain" href="/llms.txt"ou un lien en pied de page. La spécification llms.txt v2 utiliserel="describedby"pour cela.Vérifier que ça fonctionneVérifiez que cela fonctionne
Exécutez
npx astro build. Ouvrezdist/llms.txt,dist/robots.txt,dist/sitemap-0.xmlet undist/blog/your-post/index.html. Après le déploiement, exécutezcheck-ai-crawl.shsur l’URL en ligne et cherchez « Phrase in raw HTML: YES ».
JsonLd.astro
Composant JSON-LD qui échappe le signe inférieur à.
Astro
Point de terminaison llms.txt
Construit llms.txt à partir de la collection de contenu.
Astro
Point de terminaison robots.txt
Répète les règles dans le groupe IA.
Astro
Sérialiseur de sitemap
Définit lastmod d’après le frontmatter pour .md et .mdx.
Astro
maxenius.com comme exemple Astro en production
Ce site est construit comme le décrivent les étapes ci-dessus, et vous pouvez l’inspecter.
src/lib/llms.ts,src/pages/llms.txt.tsetsrc/pages/llms-full.txt.tsconstruisent /llms.txt et /llms-full.txt à partir des mêmes données que les pages.public/robots.txtrépète ses règles dans le groupe nommé des robots d’exploration IA. C’est une politique de visibilité maximale : elle accueille chaque robot listé, robots d’entraînement compris. Choisissez votre propre politique en connaissance de cause, comme expliqué dans les fondations sur robots.txt.Seo.astroetsrc/lib/seo.tsproduisent une balise meta robots avecmax-snippet:-1, unlink rel="alternate" type="text/plain"vers/llms.txt, et un graphe JSON-LD composé de Organization, WebSite, WebPage, Article, FAQPage et BreadcrumbList.astro.config.mjsutilise une sortie statique et prend lelastmoddu sitemap dans le frontmatter de chaque article.
Quel que soit votre choix, le HTML serveur est la fondation. Les fichiers et le balisage de cette section viennent en complément.
Mesurer et tester
Il vous faut cinq sources, car aucune ne couvre tout : Search Console pour Google, GA4 ou Plausible pour les clics, Bing Webmaster Tools pour les citations Copilot, les journaux serveur pour les robots, et les tests de requêtes pour ce que disent les réponses. Chacune répond à une question différente et a ses angles morts, lisez-les donc côte à côte.
Ce que rapporte chaque source
| Source | Ce qu’elle montre | Ce qu’elle ne montre pas |
|---|---|---|
| Search Console, Performances | Clics et impressions des aperçus IA et du mode IA, comptés dans le type de recherche Web. Un clic sur un lien externe dans l’une ou l’autre fonction est compté. | Tous les liens d’un aperçu IA partagent une même position : une page citée peut afficher une bonne position et un CTR minuscule. Une question de suivi en mode IA compte comme une nouvelle requête. Les expériences Search Labs sont exclues. La page de Google sur les fonctions IA confirme le type Web. |
| Rapport Generative AI de Search Console | Impressions dans les aperçus IA et le mode IA par page, pays, appareil et date. Annoncé le 3 juin 2026 ; tous les sites depuis le 31 août 2026. | Ni clics, ni CTR, ni position, ni requêtes. Il peut ne pas apparaître si votre site a trop peu d’impressions IA. C’est un sous-ensemble des données Web, ne l’ajoutez donc pas au rapport Performances. |
| Bing Webmaster Tools, AI Performance | Préversion publique depuis le 10 février 2026 : Total Citations, Average Cited Pages, requêtes d’ancrage (échantillonnées) et activité de citation par page. Depuis le 16 juin 2026 : Intents, Topics, Citation Share et Compare, en préversion. | Une citation n’est ni un clic ni une visite. Les données sont échantillonnées, et les requêtes d’ancrage sont des expressions regroupées, pas de vraies requêtes d’utilisateurs. Citation Share n’expose pas les domaines des concurrents. |
| GA4 et Plausible | Visites avec un référent ou un UTM. GA4 dispose d’un canal par défaut AI Assistant depuis le 13 mai 2026. Plausible a un canal AI Assistants. | Le canal GA4 exclut les aperçus IA et le mode IA, qui comptent comme Recherche organique. OpenAI ne documente que utm_source=chatgpt.com, les autres assistants dépendent donc des référents. |
| Journaux serveur | Chaque requête de robot, y compris les récupérations déclenchées par l’utilisateur qui n’exécutent jamais JavaScript. | Qui a lu la réponse ou cliqué. Exige des contrôles d’IP, car les agents utilisateurs peuvent être falsifiés. |
| Tests de requêtes | Ce que chaque moteur dit réellement de vous aujourd’hui. | Un classement stable. Google indique que les aperçus IA et le mode IA peuvent utiliser des modèles différents et varier leurs liens, si bien qu’une seule exécution induit en erreur. |
Mettre en place la mesure, pas à pas
ÉtapesMesurer la visibilité dans la recherche IA
Séparez les impressions des fonctions IA
Commencez ici pour toute page ayant beaucoup d’impressions et presque aucun clic.
- Dans Search Console, ouvrez Performances, filtrez Page sur votre URL, et notez les impressions, les clics, le CTR et la position moyenne.
- Ouvrez le rapport Generative AI performance, allez dans l’onglet Pages et trouvez la même URL.
- Comparez les deux nombres d’impressions. Le rapport IA est un sous-ensemble du Web, ne les additionnez donc jamais. Si les fonctions IA représentent la plupart des impressions, une bonne position avec un faible CTR est normale, car tous les liens d’un aperçu IA partagent une même position.
- Si le rapport est absent, Google indique que le site n’a pas encore eu assez d’impressions IA. Ce n’est pas une erreur.
- Ouvrez Settings > Search generative AI et confirmez que la propriété n’est pas réglée sur Exclude et n’hérite pas d’Exclude d’un parent. Voir Search generative AI control.
- Ajoutez une annotation le jour où vous livrez des changements : clic droit sur le graphique Performances, jusqu’à 120 caractères (aide sur les annotations).
Utilisez le canal AI Assistant intégré
Dans GA4, allez dans Rapports > Acquisition > Acquisition de trafic. Réglez la dimension principale sur Groupe de canaux par défaut de la session et cherchez la ligne AI Assistant. Ajoutez Source de la session comme dimension secondaire pour voir quel assistant a envoyé chaque session. Les clics des aperçus IA et du mode IA n’y figureront pas. Dans Plausible, ouvrez Sources > Channels > AI Assistants.
Ajoutez un groupe de canaux personnalisé
Allez dans Admin > Affichage des données > Groupes de canaux, créez un groupe et ajoutez un canal dont la Source correspond à l’expression régulière ci-dessous. Faites-le glisser au-dessus de Referral, car le trafic va au premier canal qui correspond. Les propriétés standard autorisent 2 groupes personnalisés, et les groupes personnalisés ne figurent pas dans l’export BigQuery.
L’expression régulière d’exemple de Google dans cet article d’aide était trop large lors de notre test : elle attrapait aussi help.openai.com, github.com/copilot, chatgptlist.org et « shanghai ». Utilisez plutôt celle-ci, plus étroite.
ga4-ai-sources.regex111 caractères, ancrée ^(.*\.)?(chatgpt\.com|chat\.openai\.com|perplexity\.ai|claude\.ai|copilot\.microsoft\.com|gemini\.google\.com)$Elle accepte chatgpt.com, chat.openai.com, www.perplexity.ai, claude.ai, copilot.microsoft.com et gemini.google.com. Elle rejette google, mail.google.com, openai.com, help.openai.com, notchatgpt.com, perplexity.ai.evil.com et bing.com. Elle couvre l’hôte www et l’ancien hôte de ChatGPT, car chat.openai.com redirige vers chatgpt.com et perplexity.ai redirige vers www.perplexity.ai. Les expressions régulières de GA4 sont en correspondance complète et sensibles à la casse par défaut, utilisent RE2, et les filtres de rapport sont limités à 250 caractères. Les ancres maintiennent ce motif correct dans les deux modes de correspondance. N’ajoutez d’autres assistants qu’après les avoir vus apparaître dans votre propre rapport Source de la session.
Surveillez les UTM perdus
Cherchez dans Source / support de la session les lignes chatgpt.com classées dans Unassigned ou Referral, car Google ne documente pas comment GA4 traite un utm_source sans support par rapport à la règle AI Assistant. Une redirection qui supprime la chaîne de requête, comme une règle de barre oblique finale, de www ou de http vers https, supprime aussi l’UTM. Testez une URL balisée à travers chaque redirection que vous utilisez.
Construisez une Exploration (facultatif)
Passez cette étape si le rapport de canaux intégré répond à votre question. Dans Explorer, démarrez une exploration vierge. Importez les dimensions Source de la session, Source / support de la session, Page de destination + chaîne de requête et Groupe de canaux par défaut de la session, ainsi que les métriques Sessions, Sessions engagées et Événements clés. Placez Source de la session puis Page de destination + chaîne de requête dans Lignes, et filtrez Source de la session avec la même expression régulière.
Lisez les citations Copilot et Bing
- Validez le site dans Bing Webmaster Tools et ouvrez le rapport AI Performance.
- Lisez Total Citations, Average Cited Pages, les requêtes d’ancrage et la liste Pages. Cliquez sur une requête d’ancrage pour voir ses pages citées, ou sur une page pour voir ses requêtes d’ancrage.
- Utilisez Compare pour superposer la période suivant vos changements. Intents, Topics et Citation Share sont des fonctions en préversion.
- Exportez en CSV ou Excel chaque mois. Lisez la FAQ pour les règles d’échantillonnage et d’actualisation.
- Soumettez les URL modifiées via IndexNow. Bing le recommande pour que les réponses IA utilisent la version actuelle de la page.
Comptez les passages des robots IA dans les journaux serveur
Cherchez ces agents utilisateurs. Recherche : OAI-SearchBot, Claude-SearchBot, PerplexityBot, Googlebot, bingbot. Entraînement : GPTBot, ClaudeBot. Déclenchés par l’utilisateur : ChatGPT-User, Claude-User, Perplexity-User. Google-Extended n’apparaîtra jamais, car c’est un jeton robots.txt sans agent utilisateur propre.
Les passages déclenchés par l’utilisateur comptent le plus. Chacun signifie qu’une vraie conversation a lu votre page, et comme ces récupérations n’exécutent pas JavaScript, GA4 et Plausible ne les voient jamais.
Un comptage rapide à partir d’un journal au format combiné. Cette version awk compte chaque ligne une fois, alors qu’un grep simple comptait bingbot deux fois par ligne :
terminalCompte chaque ligne une fois awk 'match($0, /OAI-SearchBot|ChatGPT-User|GPTBot|Claude-SearchBot|Claude-User|ClaudeBot|PerplexityBot|Perplexity-User|Googlebot|bingbot/) { print substr($0, RSTART, RLENGTH), $7 }' access.log | sort | uniq -c | sort -rnLes agents utilisateurs se falsifient facilement, vérifiez donc les IP. Notre
ai_bot_report.py(Python 3, bibliothèque standard uniquement, dans le kit) compte les passages par jour, robot, statut et chemin, et vérifie chaque IP par rapport à la liste publiée par l’opérateur pour OpenAI, Anthropic, Perplexity, Google et Bing. Une ligne avecip_verified=NOcorrespond à un agent utilisateur usurpé. Il signale un faux GPTBot venant d’une IP non listée.terminal python3 ai_bot_report.py access.log > ai-bots.csv zcat access.log.*.gz | python3 ai_bot_report.py - > ai-bots.csvSans le script, utilisez la double vérification : le DNS inverse de l’IP doit renvoyer un nom d’hôte Google (googlebot.com, google.com ou googleusercontent.com) ou un nom se terminant par search.msn.com pour Bingbot, et une résolution directe de ce nom doit renvoyer la même IP.
Sur Vercel, allez dans Firewall > Rules > Bot Management et réglez le jeu de règles AI Bots sur Log, pas sur Deny (jeux de règles gérés du WAF). Utilisez ensuite Firewall > Traffic et regroupez par User Agents et Request Paths (observabilité). Les Runtime Logs ne montrent que les requêtes statiques servies depuis le cache. Un journal complet exige des Drains, disponibles sur les offres Pro et Enterprise, avec
proxy.userAgentdans chaque enregistrement :vercel-drain-bots.shNécessite jq jq -r 'select(.proxy) | [(.proxy.timestamp/1000|todate), .proxy.clientIp, .proxy.path, (.proxy.statusCode|tostring), (.proxy.userAgent|join(" "))] | @tsv' drain.ndjson \ | awk -F'\t' 'match($5, /OAI-SearchBot|ChatGPT-User|GPTBot|Claude-SearchBot|Claude-User|ClaudeBot|PerplexityBot|Perplexity-User|Googlebot|bingbot/) { print substr($5, RSTART, RLENGTH) "\t" $3 }' \ | sort | uniq -c | sort -rnSur Cloudflare, ouvrez AI Crawl Control. Si les passages de robots IA sont proches de zéro, vérifiez si le réglage du robots.txt géré ajoute en tête des règles Disallow pour GPTBot, ClaudeBot ou Google-Extended.
Lancez un test de requêtes reproductible
Aucun outil officiel ne rapporte les citations de ChatGPT, Claude ou Perplexity : testez donc à la main avec un protocole fixe.
- Rédigez 20 à 40 requêtes couvrant des questions pratiques, des comparaisons, des cas propres à une plateforme et deux ou trois questions sur la marque. Donnez à chacune un identifiant permanent. Pour changer la formulation, retirez l’identifiant et ajoutez-en un nouveau.
- Moteurs : ChatGPT avec la recherche activée, Google AI Mode, aperçus IA de Google (une recherche normale), Gemini, Perplexity, Microsoft Copilot, Claude avec la recherche web activée.
- Gardez les réglages constants : pays, langue, connecté ou non. Dans ChatGPT, utilisez Temporary chat réglé sur Unpersonalized, qui ignore la mémoire et les instructions personnalisées. Le mode Personalized peut encore utiliser des souvenirs existants. Ailleurs, utilisez un profil neuf ou une session déconnectée et notez le mode ou le modèle.
- Exécutez chaque requête 3 fois par moteur. Les réponses varient d’une exécution à l’autre.
- Cadence : une base de référence mensuelle, plus une nouvelle exécution 2 à 4 semaines après un changement de contenu important.
- Consignez chaque exécution dans
ai-prompt-tracker.csv(26 colonnes, deux lignes d’exemple clairement signalées). Calculez le taux de mention, le taux de citation et la part de citation (vos URL citées divisées par toutes les URL citées, la même idée que la métrique de Bing). - Conservez les captures d’écran comme preuves privées. Ne publiez pas d’interfaces tierces.
Google Sheets ou ExcelDonnées dans une feuille nommée runs Mention rate =COUNTIF(runs!N2:N1000,"yes")/COUNTA(runs!C2:C1000) Citation rate =COUNTIF(runs!P2:P1000,"yes")/COUNTA(runs!C2:C1000) Citation share =SUM(runs!R2:R1000)/SUM(runs!S2:S1000)Vérifier que ça fonctionneVérifiez que cela fonctionne
Confirmez quatre points :
- Vous avez un chiffre « avant » pour l’URL (impressions totales et impressions des fonctions IA) et une annotation datée du jour de la mise en ligne.
- Le filtre GA4 ne renvoie que des hôtes d’assistants.
- La sortie sur les robots montre vos propres requêtes. Faites-en une avec
curl -A 'OAI-SearchBot' -s -o /dev/null https://yourdomain.com/robots.txt, puis cherchez une ligne portant ce nom de robot et le statut 200. - Le suivi des requêtes comporte une ligne de référence pour chaque identifiant de requête et chaque moteur.
Si vous préférez que la mesure soit mise en place et analysée pour vous, consultez nos services de SEO pour l’IA.
Outils tiers
Brand Radar d’Ahrefs suit les mentions et les citations dans les aperçus IA, le mode IA, ChatGPT, Gemini, Perplexity et Copilot, à partir d’un index de requêtes qu’Ahrefs dit modélisé d’après des données de recherche, plus des requêtes personnalisées de votre choix. Le Semrush AI Visibility Toolkit propose un score de visibilité, une recherche de requêtes et un suivi quotidien des requêtes. Cloudflare AI Crawl Control rapporte l’activité des robots pour les sites derrière Cloudflare. Ces outils échantillonnent des requêtes plutôt que de lire de vraies conversations d’utilisateurs, et Google indique qu’aucun outil tiers n’a accès à ses systèmes de classement IA. Considérez leurs chiffres comme indicatifs et comparez-les à vos propres données de première main.
Liste de contrôle d’auto-audit
Parcourez cette liste sur votre propre site. Chaque point renvoie à la section qui l’explique. Votre progression n’est enregistrée que dans ce navigateur, elle ne vous suivra donc pas sur un autre appareil.
Auto-audit GEO
0 sur 33 faits
Kit de démarrage GEO
Tout ce que ce guide vous permet de copier se trouve dans un seul téléchargement gratuit, sans inscription ni formulaire d’e-mail.
Télécharger le kit de démarrage GEO complet
53 fichiers dans une seule archive : robots.txt, llms.txt, JSON-LD, IndexNow, WordPress, Shopify, Next.js, React, Astro, scripts, un outil de suivi des requêtes et un brief de contenu.
Toutes
Liste de contrôle d’auto-audit imprimable
La liste de contrôle ci-dessus, deux pages A4, prête à imprimer ou à enregistrer.
Toutes
Suivi des requêtes
Le suivi à 26 colonnes. Les formules et le protocole de test sont dans le même dossier.
Toutes
Modèle de brief de contenu
Un brief de contenu qui commence par la réponse.
Toutes
Script de rapport sur les robots
Compte les passages de robots IA depuis un journal et vérifie chaque IP par rapport aux plages publiées.
Toutes
Expression régulière des sources IA GA4
L’expression régulière plus étroite pour un groupe de canaux personnalisé.
Toutes
Extrait de head HTML
Balise meta robots et balisage data-nosnippet.
Toutes
Notification IndexNow
Une commande de notification par lot, avec un exemple de fichier de clé dans le même dossier.
Toutes
Les fichiers par plateforme sont liés dans chaque section de plateforme ci-dessus. Chaque fichier utilise des valeurs fictives comme example.com, des clés d’exemple et des noms d’exemple. Remplacez chacune avant de déployer, et exécutez l’étape de vérification de la section correspondante.
Prochaines étapes
Commencez par la liste de contrôle d’auto-audit ci-dessus et corrigez le premier point en échec, le plus souvent l’accès des robots ou le HTML serveur. Si vous préférez que le travail soit réalisé et vérifié sur votre propre site, Maxenius réalise des audits et des mises en œuvre de SEO pour l’IA et de GEO. Nous vérifions l’accès des robots, le rendu, les données structurées et la mesure d’après les étapes de ce guide, et nous indiquons ce qui a changé, preuves à l’appui. Personne ne peut garantir des citations par l’IA, nous ne proposons donc pas cela.
Réserver un audit de recherche IAS’il s’agit de construire un site, nous réalisons aussi du développement Shopify, du développement WordPress et du développement de logiciels sur mesure. La documentation des éditeurs change souvent. Revérifiez les sources ci-dessous chaque mois.
Sources et dates
Toutes ouvertes et vérifiées le 7 octobre 2026.
- Google Search Console Help, What are impressions, position, and clicks
- Google Search Console Help, Generative AI performance report
- Google Search Console Help, Search generative AI control
- Google Search Console Help, Search Console annotations
- Google Search Central Blog, Introducing Search Generative AI performance reports
- Google Search Central, AI features and your website
- Google, Google’s common crawlers
- Google, Verify requests from Google crawlers and fetchers
- Google Analytics Help, What’s new in Google Analytics, Default channel group, Custom channel groups, About regular expressions
- Microsoft Bing Webmaster Blog, Introducing AI Performance in Bing Webmaster Tools Public Preview
- Microsoft Bing Webmaster Tools Help, AI Performance FAQ
- Microsoft Bing Search Blog, New AI Visibility Insights in Bing Webmaster Tools
- OpenAI, Overview of OpenAI Crawlers
- OpenAI Help Center, Publishers and Developers FAQ, Temporary chat
- Anthropic, Does Anthropic crawl data from the web
- Perplexity, Perplexity Crawlers
- IndexNow.org, Documentation and FAQ
- Vercel, WAF Managed Rulesets, Firewall Observability, Runtime Logs
- Cloudflare, Managed robots.txt
- Plausible, Top referrers
- Ahrefs, Brand Radar
- Semrush, AI Visibility Toolkit