الذكاء الاصطناعي وSEO
كيف تحسّن موقعك للبحث بالذكاء الاصطناعي (GEO) + قوالب
تاريخ النشر · آخر تحديث
في هذه الصفحة
يوضح هذا الدليل كيف تُعدّ موقعًا بحيث تستطيع منتجات البحث بالذكاء الاصطناعي العثور عليه وفهمه والاستشهاد به، بخطوات محددة لكل منصة وفحص بعد كل خطوة. كُتب لأصحاب المواقع والمسوّقين والمطورين الذين يريدون تنفيذ العمل بأنفسهم. لا أحد يستطيع ضمان استشهاد ChatGPT أو Perplexity أو Claude أو Google بموقعك، وتقول Google إن التحسين للبحث بالذكاء الاصطناعي التوليدي ما زال SEO. وحزمة بداية مجانية من الملفات الجاهزة للنسخ في نهاية الدليل.
أبرز النقاط
- اسمح بدخول الزواحف المناسبة. زواحف البحث هي التي تحدد إمكانية الاستشهاد بك، أما زواحف التدريب فلا، وقد تتجاوز شبكة توزيع المحتوى أو جدار الحماية لديك ما كتبته في robots.txt.
- ضع الإجابة في HTML مُولَّد على الخادم. لم تنفّذ عدة زواحف ذكاء اصطناعي كبرى JavaScript عند آخر قياس، فاختبر الصفحة بأداة curl البسيطة.
- اكتب أقسامًا تبدأ بالإجابة: موضوع واحد لكل عنوان URL، وإجابة مباشرة تحت كل عنوان، وحقائق صريحة.
- يجب أن تطابق البيانات المنظمة النص الظاهر. لا يلزم أي schema خاص لميزات الذكاء الاصطناعي في Google.
- ملف llms.txt اختياري، وبحث Google يتجاهله. إضافته رخيصة، فاعتمد عليه بعد الأساسيات.
- قِس عبر الأدوات الرسمية (Search Console وBing Webmaster Tools وGA4) وكرّر اختبارات المطالبات مع الوقت.
لست متأكدًا أي منصة تناسب نشاطك؟ اقرأ أولًا WordPress أم Shopify.
ما هو GEO؟
تحسين المحركات التوليدية (GEO) يعني جعل صفحاتك سهلة على منتجات البحث بالذكاء الاصطناعي من حيث العثور عليها وفهمها والاستشهاد بها. أما تحسين محركات الإجابة (AEO) فتسمية متداخلة لنفس العمل، وليس هناك تعريف متفق عليه لأي منهما، كما يشير مدخل ويكيبيديا. وتدمجه Google ضمن SEO، بينما تستخدم إرشادات Bing لمشرفي المواقع مصطلح GEO وتنص على أنه لا يضمن التأريض أو الاستشهاد.
كيف تعثر المحركات التوليدية على المصادر وتختارها وتستشهد بها
تسلك كل المحركات تقريبًا المسار نفسه، وإن اختلفت التفاصيل بين مزوّد وآخر.
- الزحف: Googlebot (يغذّي أيضًا AI Overviews وAI Mode); Bingbot (Bing وCopilot وواجهة grounding API); OAI-SearchBot; Claude-SearchBot; PerplexityBot
- الفهرسة: Google: مفهرس ومؤهل لعرض المقتطفات; Bing: يشترك Copilot في الزحف والفهرسة والترتيب; ChatGPT: مزودو بحث من جهات خارجية إضافة إلى OAI-SearchBot; Perplexity: بحث ويب لحظي
- توسيع السؤال: Google: query fan-out (تفريع الاستعلام); ChatGPT: إعادة صياغة الاستعلام
- استرجاع المقاطع واختيارها: Google: التأسيس (grounding) من فهرس Search; Copilot: يحلّل الصفحات إلى أجزاء أصغر; القيود: nosnippet وmax-snippet وdata-nosnippet وBing NOARCHIVE وNOCACHE
- التوليد والاستشهاد: Google: روابط إلى الصفحات الداعمة; Perplexity: استشهادات مرقّمة; ChatGPT: استشهادات; Bing: استشهادات محسوبة
- القياس: تقرير Generative AI في Search Console (مرات الظهور فقط)؛ أداء Search Console (نقرات الذكاء الاصطناعي ضمن Web)؛ Bing AI Performance؛ GA4 utm_source=chatgpt.com؛ سجلات الخادم
روبوتات التدريب منفصلة: GPTBot وClaudeBot وGoogle-Extended (رمز فقط). أدوات الجلب التي يطلقها المستخدم: ChatGPT-User وClaude-User وPerplexity-User.
1. الزحف. يجب أن تصل الزواحف إلى الصفحة. تستخدم AI Overviews ووضع الذكاء الاصطناعي في Google زحف البحث المعتاد، ويغذّي زاحف Bing خدمة Copilot، ويعتمد بحث ChatGPT على OAI-SearchBot، وبحث Claude على Claude-SearchBot، وPerplexity على PerplexityBot.
2. الفهرسة. تقول Google إن الصفحة يجب أن تكون مفهرسة ومؤهلة لعرض مقتطف، دون متطلبات إضافية. وتقول Bing إن Copilot يشترك في أساس الزحف والفهرسة والترتيب نفسه. وتقول OpenAI إن ChatGPT يرسل استعلامات معاد صياغتها إلى مزوّدي بحث من أطراف ثالثة إضافةً إلى استخدام زاحفه الخاص.
3. توسيع السؤال. يصف دليل Google مفهوم query fan-out، أي إطلاق استعلامات فرعية ذات صلة. وتقول OpenAI إن ChatGPT يعيد صياغة المطالبة إلى استعلام مستهدف واحد أو أكثر.
4. الاسترجاع واختيار المقاطع. تسترجع Google عبر أنظمة الترتيب الأساسية لديها. وتقول Microsoft إن Copilot يحلل الصفحات إلى أجزاء أصغر، فقد تُتجاوَز التفاصيل المهمة المخبأة داخل علامات التبويب أو الصور أو ملفات PDF.
5. التوليد والاستشهاد. تُرفق Perplexity استشهادات مرقمة بإجاباتها. وتقول OpenAI إن الظهور في بحث ChatGPT غير مضمون.
ثم تأتي مرحلة القياس، وهي مشروحة في النهاية. وإذا كنت تعمل على ChatGPT تحديدًا، فاطلع على دليلنا حول الظهور في ChatGPT، وللموضوع الأوسع راجع دليل تحسين محركات الإجابة.
زواحف التدريب وزواحف البحث وأدوات الجلب التي يطلقها المستخدم
يقسّم كل مزوّد زحفه بحسب الغرض. والقاعدة العملية: حظر رمز التدريب لا يُخرجك من بحث الذكاء الاصطناعي لدى ذلك المزوّد، أما حظر زاحف البحث فيُخرجك.
| المزوّد | البحث والإجابات | تدريب النماذج | الجلب الذي يطلقه المستخدم |
|---|---|---|---|
| OpenAI | OAI-SearchBot | GPTBot | ChatGPT-User |
| Anthropic | Claude-SearchBot | ClaudeBot | Claude-User |
| Perplexity | PerplexityBot | لا يُستخدم للتدريب | Perplexity-User |
| Googlebot (البحث وAI Overviews ووضع الذكاء الاصطناعي) | رمز Google-Extended (تدريب Gemini والتأريض) | أدوات الجلب التي يطلقها المستخدم لدى Google | |
| Apple | Applebot | رمز Applebot-Extended | لا شيء موثّق |
| Microsoft | Bingbot (Bing وCopilot) | لا رمز منفصل؛ وسما NOARCHIVE وNOCACHE | لا شيء موثّق |
المصادر: OpenAI، Anthropic، Perplexity، Google، Apple، Bing. تم التحقق في 7 أكتوبر 2026.
SEO مقابل AEO مقابل GEO
| SEO | AEO | GEO | |
|---|---|---|---|
| ما يعنيه الناس به | كسب الظهور في نتائج البحث التقليدية | أن تكون أنت الإجابة في المقتطفات المميزة والمساعدات الصوتية وإجابات الذكاء الاصطناعي | أن يُستشهد بك داخل الإجابات المولَّدة |
| أين تظهر الإجابة | روابط مرتبة | مربعات الإجابة والمساعدات | AI Overviews ووضع الذكاء الاصطناعي وChatGPT وCopilot وPerplexity وClaude |
| ما تتحكم فيه | قابلية الزحف والمحتوى والروابط وتجربة الصفحة | محتوى يبدأ بالإجابة وبنية واضحة | المدخلات نفسها، إضافةً إلى الوصول للزواحف ووضوح الكيان |
| ما تقيسه | مرات الظهور والنقرات والترتيب | حضور المقتطفات والإجابات | الاستشهادات ومرات الظهور في تقارير الذكاء الاصطناعي وجلسات الإحالة |
| تنبيه | الترتيب يتحرك | التسميات تتداخل مع SEO | لا تعريف متفق عليه، ولا استشهادات مضمونة |
تقول Google إن التحسين للبحث بالذكاء الاصطناعي التوليدي ما زال SEO. فاعتبر التسميات الثلاث نطاقات للعمل، وليست تخصصات مختلفة.
ست خرافات تخلَّ عنها قبل أن تبدأ
الأسس التي تحتاجها كل منصة
تنطبق هذه الخطوات الست على كل تقنية. وتبيّن أقسام المنصات لاحقًا مكان كل خطوة في WordPress وShopify وReact وNext.js وAstro.
1. اسمح للزواحف المناسبة بالدخول: robots.txt وشبكة توزيع المحتوى
الخطواتافتح الباب أمام زواحف البحث
حدّد سياستك
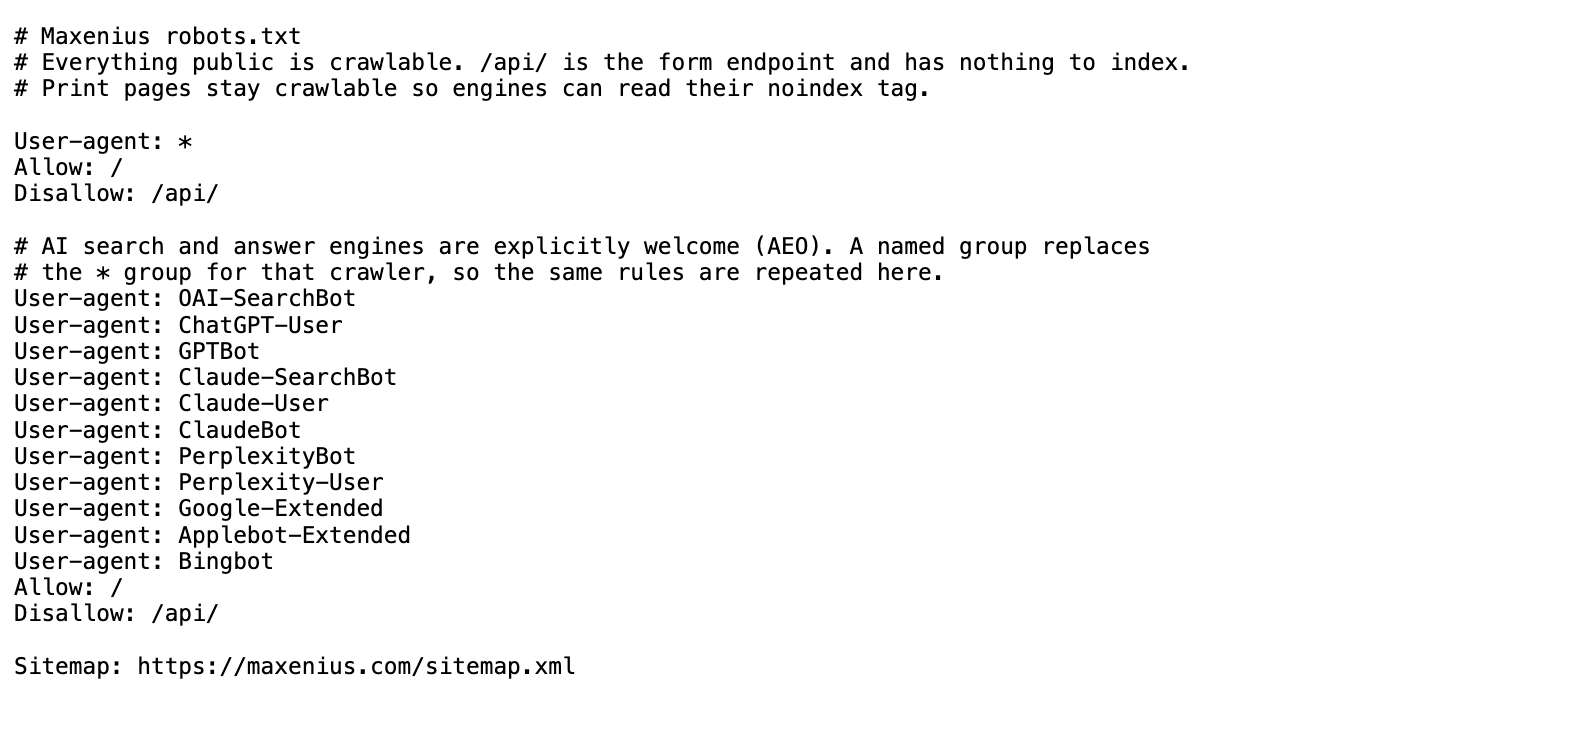
يجعلك القالب A ظاهرًا في البحث بالذكاء الاصطناعي مع الامتناع عن تدريب النماذج. أما القالب B فيرحّب بكل شيء، بما فيه زواحف التدريب، وهو السياسة التي يعتمدها maxenius.com لأقصى قدر من الظهور.
اكتب الملف مع تكرار القواعد المشتركة
يلتزم الزاحف بأكثر مجموعة مطابقة تحديدًا فقط، ومواصفة Google تنص على أن المجموعات المسماة ومجموعة
*لا تُدمج. لذلك كرّر كل سطر Disallow تحتاجه داخل كل مجموعة مسماة.public/robots.txtالقالب A: ظهور في البحث بالذكاء الاصطناعي مع الامتناع عن التدريب User-agent: * Disallow: /api/ Disallow: /cart/ Allow: / User-agent: OAI-SearchBot User-agent: ChatGPT-User User-agent: Claude-SearchBot User-agent: Claude-User User-agent: PerplexityBot User-agent: Perplexity-User Disallow: /api/ Disallow: /cart/ Allow: / User-agent: GPTBot User-agent: ClaudeBot User-agent: Applebot-Extended User-agent: CCBot Disallow: / Sitemap: https://www.example.com/sitemap.xmlpublic/robots.txtالقالب B: أقصى قدر من الظهور، بما في ذلك زواحف التدريب User-agent: * Disallow: /api/ Allow: / User-agent: OAI-SearchBot User-agent: ChatGPT-User User-agent: GPTBot User-agent: Claude-SearchBot User-agent: Claude-User User-agent: ClaudeBot User-agent: PerplexityBot User-agent: Perplexity-User User-agent: Google-Extended User-agent: Applebot-Extended Disallow: /api/ Allow: / Sitemap: https://www.example.com/sitemap.xmlأبقِ آليات الملف سليمة
ضع أسطر Disallow قبل
Allow: /، لأن المحللات البسيطة مثل robotparser في Python تتوقف عند أول تطابق. وقدّم ملفًا واحدًا لكل مضيف من المسار/robots.txt. وبموجب RFC 9309، تعني استجابة 5xx أن الزواحف تفترض أن كل شيء ممنوع، وتعني 404 أن لها أن تزحف إلى كل شيء. وملف robots.txt ليس وسيلة للتحكم في الوصول. وتقول OpenAI وPerplexity كلتاهما إن التغييرات تستغرق نحو 24 ساعة لتسري.افحص الطبقة التي تعلو robots.txt
تقول OpenAI إن مضيفك أو شبكة توزيع المحتوى لديك يجب أن تسمح بنطاقات عناوين IP المنشورة لديها، وتوثّق Perplexity قواعد WAF تجمع بين وكيل المستخدم وقوائم عناوين IP. وهناك فخّان: منذ 15 سبتمبر 2026، تحظر Cloudflare الزواحف متعددة الأغراض، ومنها Googlebot وApplebot وBingBot، عندما يفعّل العميل حظر التدريب، كما أن ملف robots.txt المُدار لديها يضيف في البداية قواعد Disallow تشمل Google-Extended. وعلى Vercel، يؤدي ضبط مجموعة قواعد AI Bots على Deny إلى حظر زواحف البحث أيضًا.
تحقق من نجاح الخطوةتحقق من نجاح الخطوة
نفّذ
curl -s https://yourdomain.com/robots.txtوتأكد من أن الملف المنشور يطابق ما في مستودعك، فقد تعيد شبكة توزيع المحتوى كتابته. ثم ابحث في سجلات الخادم أو الشبكة عن استجابات 200 لOAI-SearchBot وClaude-SearchBot وPerplexityBot وBingbot. وانتحال وكيل المستخدم بأداة curl يختبر قواعد وكيل المستخدم فقط، ولا يختبر القواعد المبنية على عناوين IP.
فتح بالحجم الكامل (في علامة تبويب جديدة)
قالبا robots.txt A وB
القالب A: زواحف البحث مسموحة وزواحف التدريب محظورة. أما القالب B، سياسة أقصى ظهور، فهو في المجلد نفسه من الحزمة.
Any
2. ضع الإجابة في HTML مُولَّد على الخادم
الخطواتاجعل الصفحة مقروءة دون JavaScript
اقرأ النتائج المؤرَّخة أولًا
في ديسمبر 2024، وجدت دراسة Vercel وMERJ أن أيًّا من زواحف الذكاء الاصطناعي الكبرى التي درستها لم يعرض JavaScript، باستثناء Gemini عبر Googlebot وApplebot. ولا يزال إرشاد Vercel لعام 2026، اجعل موقعك مقروءًا لوكلاء الذكاء الاصطناعي، ينصح بتوليد المحتوى الذي تريد قراءته على الخادم. هذه نتائج مؤرَّخة، وليست وعدًا بشأن كل زاحف. ولا تذكر OpenAI ما إذا كان OAI-SearchBot يعرض الصفحات، فاختبر بدلًا من الافتراض.
ولِّد الأساسيات على الخادم
ينبغي أن يكون العنوان والنص الرئيسي وcanonical وJSON-LD وروابط التنقل في HTML الأولي. تقول Google إن ليست كل الزواحف تنفّذ JavaScript، رغم أن Googlebot يفعل ذلك عمومًا.
لا تخفِ الإجابات
أبقِ الإجابات الأساسية خارج علامات التبويب المغلقة والصور وملفات PDF. وتحذّر Microsoft وBing كلتاهما من إخفاء المحتوى المهم خلف العرض من جهة العميل.
تحقق من نجاح الخطوةتحقق من نجاح الخطوة
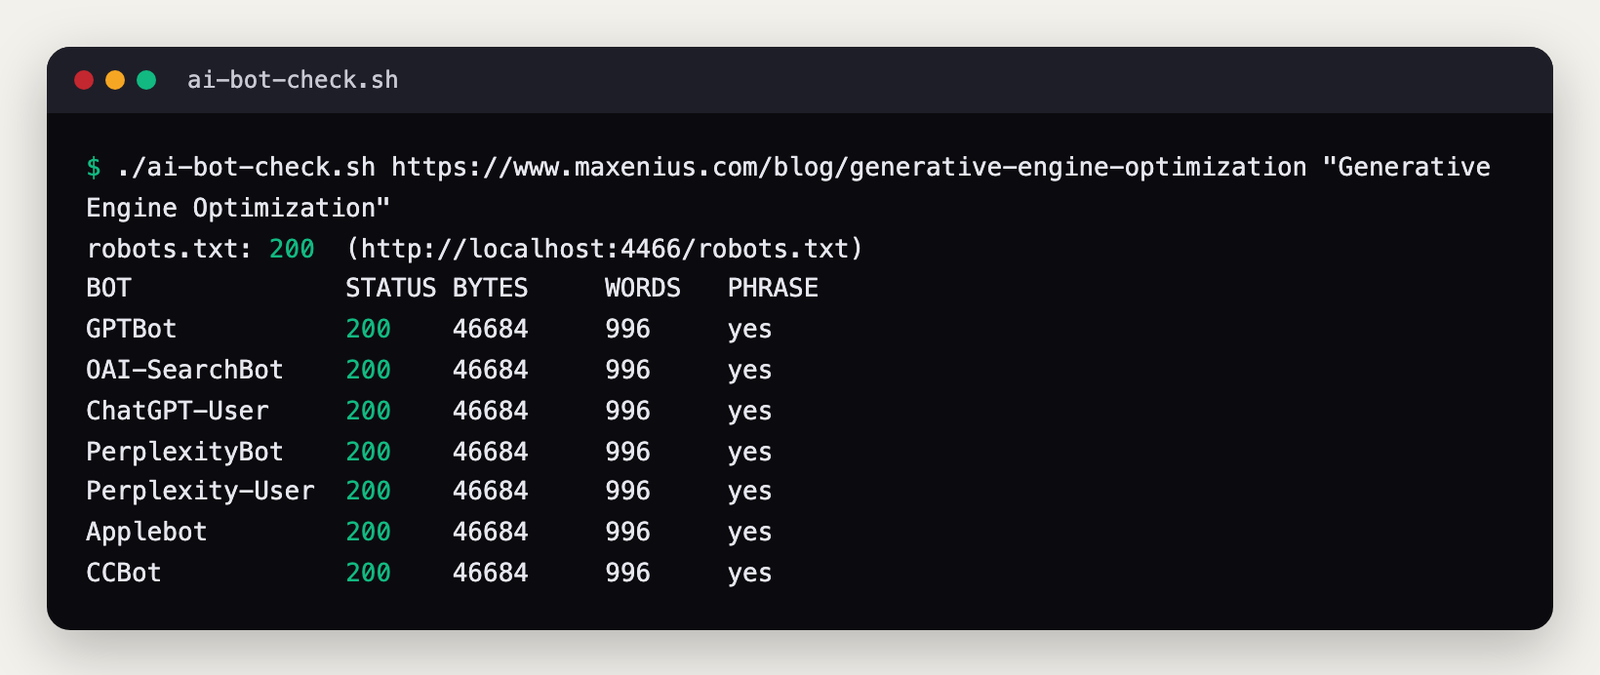
اجلب الصفحة كما يفعل زاحف لا يعرض JavaScript، مثلًا باستخدام سكربت الحزمة:
./ai-bot-check.sh https://www.example.com/page "a sentence from the body". ينبغي أن يُظهر كل صف زاحف الحالة 200، وعدد كلمات قريبًا مما تراه في المتصفح، وPHRASE = yes. تحتوي الحزمة على سكربتين:ai-bot-check.shيختبر سبعة وكلاء مستخدم لزواحف، وcheck-ai-crawl.sh(الموضح في قسم الأطر البرمجية) يفحص عملية جلب واحدة بحثًا عن العنوان وcanonical وJSON-LD.
فتح بالحجم الكامل (في علامة تبويب جديدة)
3. اكتب أقسامًا تبدأ بالإجابة
الخطواتاجعل كل قسم قابلًا للاقتطاف
ابدأ بالإجابة
ضع الإجابة المباشرة في الجمل الأولى تحت كل عنوان، واجعل العناوين محددة. وتنصح إرشادات Bing بإبراز المعلومات الأساسية مبكرًا وتعريف الحقائق صراحةً في عنوان URL نفسه.
موضوع واحد لكل عنوان URL، ولا صفحات بالجملة
لا تنشئ صفحة لكل صيغة من صيغ توسيع الاستعلام. تصف Google ذلك بأنه إساءة استخدام المحتوى الموسّع. أضف بدلًا من ذلك تفاصيل من تجربة مباشرة وغير متاحة للجميع، بدل إعادة ما يقوله غيرك.
لا نص مخفيًا للنماذج
تعدّ Bing حقن المطالبات والتعليمات المخفية الموجهة للنماذج اللغوية الكبيرة إساءة قد تُنزل موقعًا أو تحذفه من الفهرس. وتقول Google إنه لا يوجد طول مثالي ولا حاجة إلى التقطيع، فاكتب للناس.
تحقق من نجاح الخطوةتحقق من نجاح الخطوة
اقرأ كل قسم H2 وحده. إذا كان يجيب عن عنوانه دون الفقرة التي تسبقه، فقد نجح.
4. بيانات منظمة تطابق الصفحة
الخطواتأضف ترميزًا يقول الحقيقة
تحقق من المتطلب
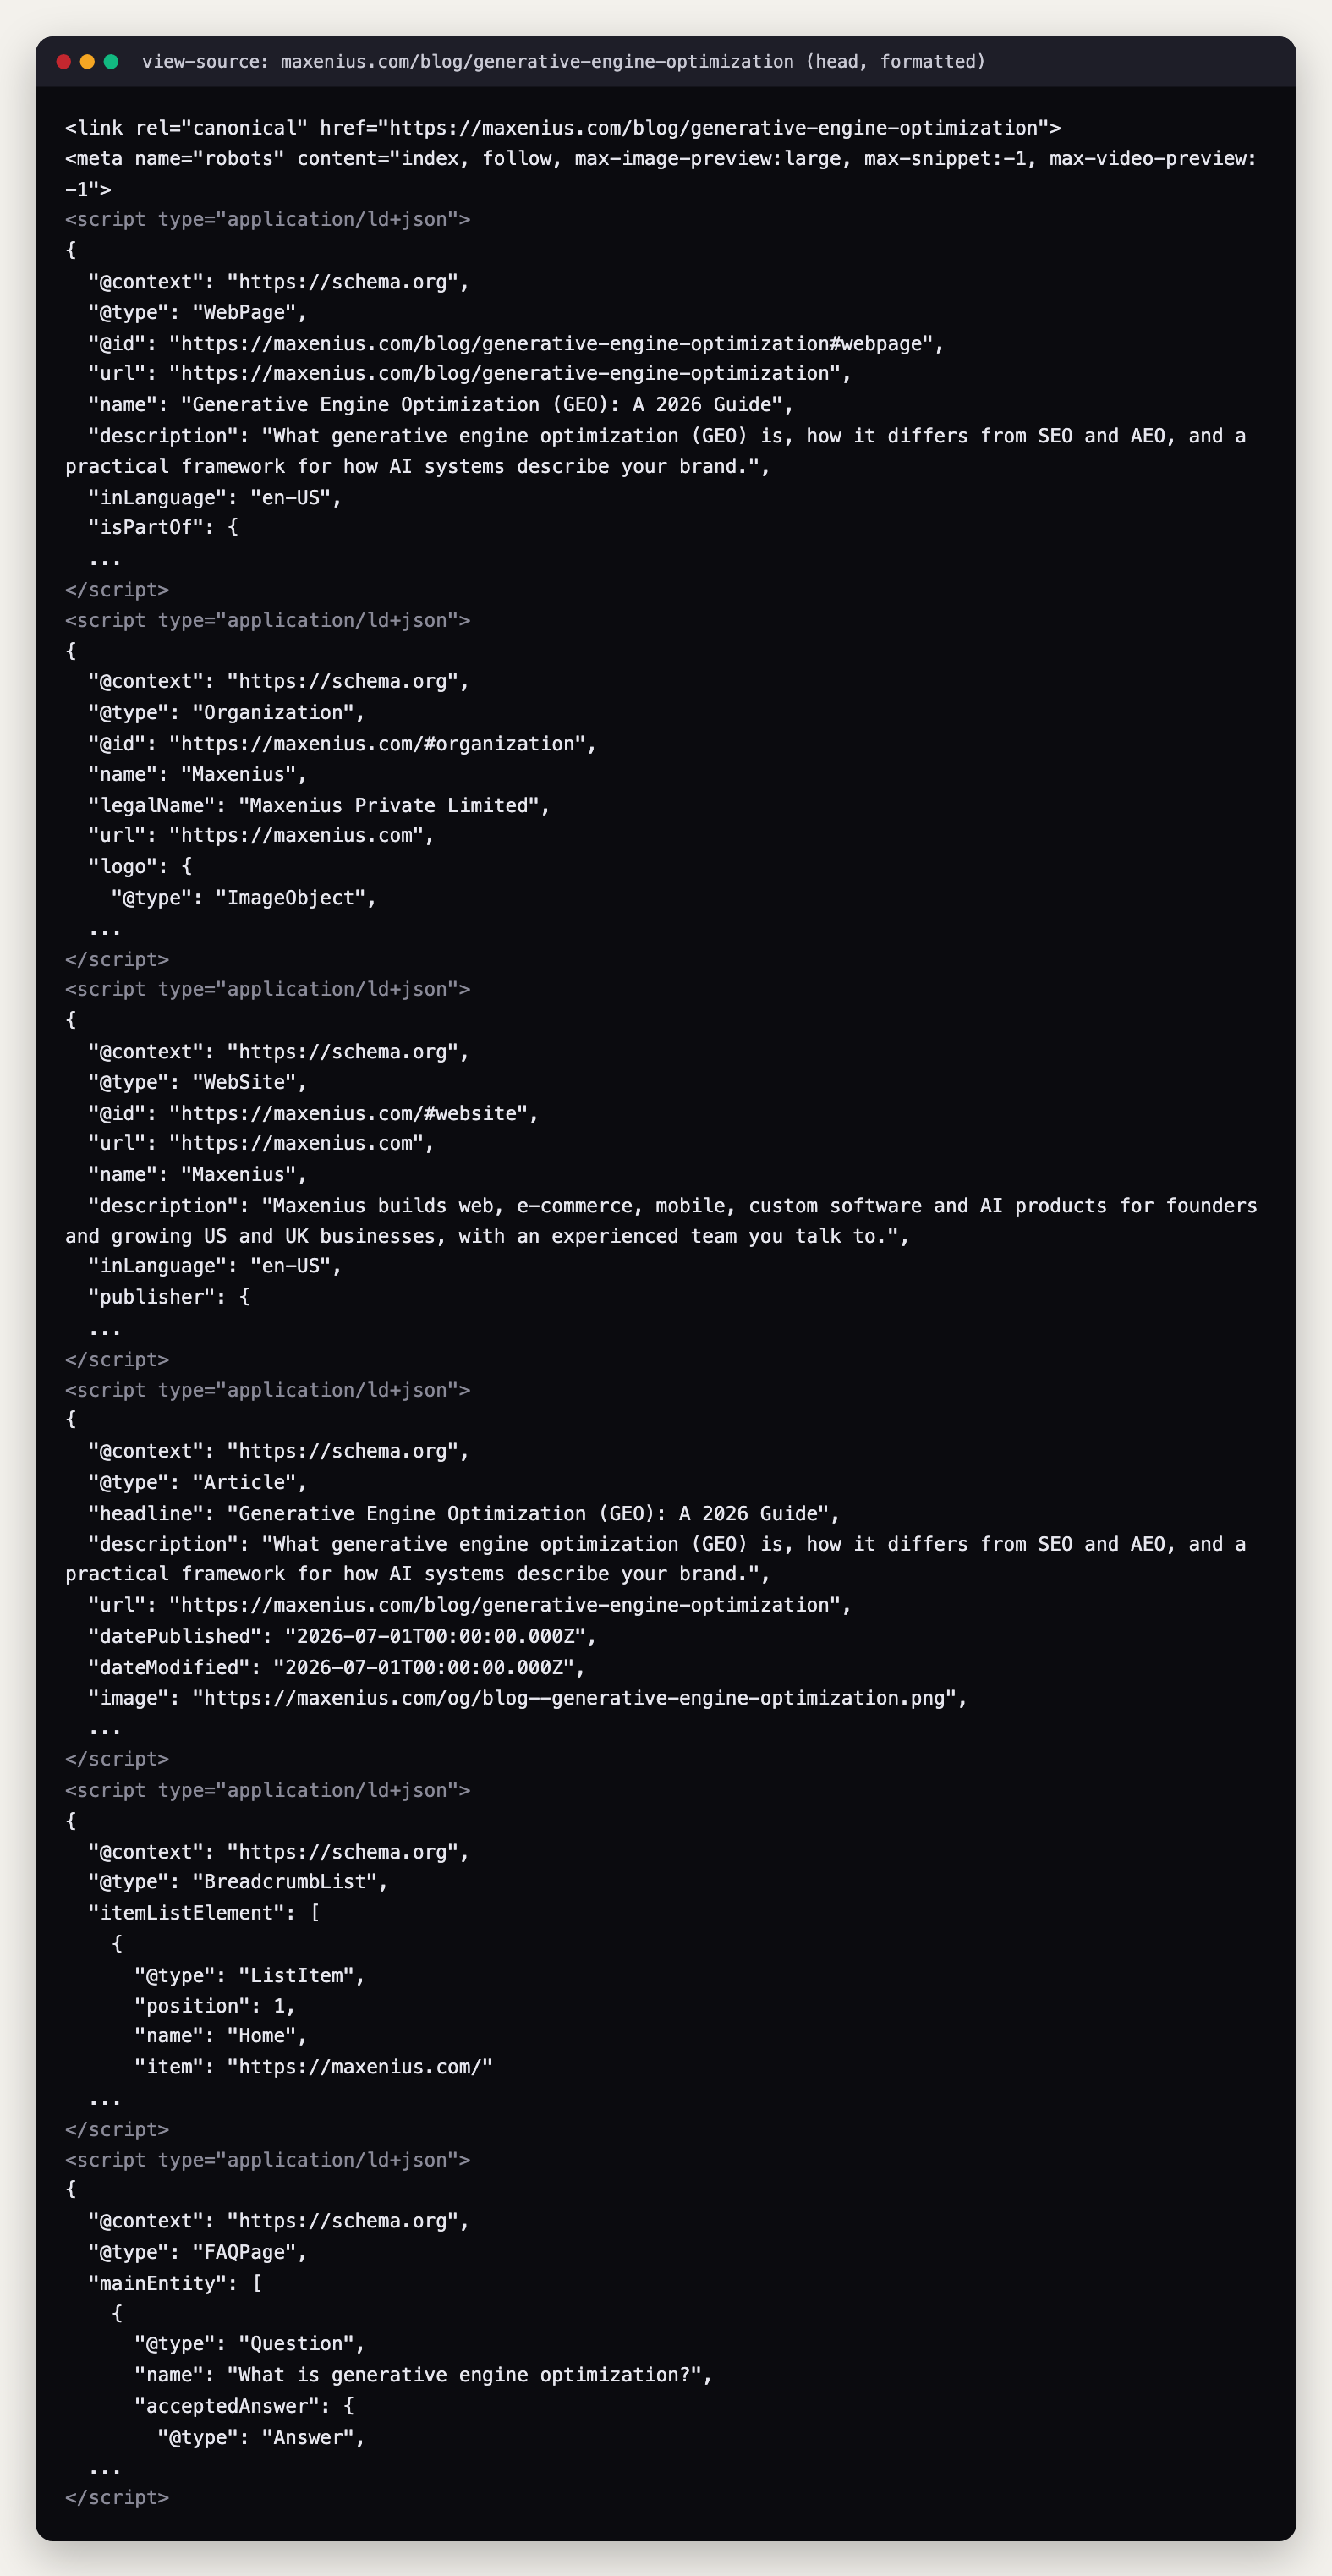
تقول Google إن لا حاجة إلى schema خاص لميزات الذكاء الاصطناعي، وإن الترميز يجب أن يطابق النص الظاهر. ومع ذلك استخدم Article أو BlogPosting وOrganization وProduct وBreadcrumbList حيثما انطبقت.
استخدم JSON-LD، واهرب منه، وأضف التواريخ
يمكن وضع JSON-LD في head أو body، وتقرأ Google JSON-LD المحقون، لكن الزواحف التي تتجاوز JavaScript لا تستطيع ذلك. وعند تحويل JSON إلى سلسلة داخل وسم script، استبدل كل
<بالتسلسل\u003c(شرطة مائلة عكسية متبوعة بu003c) حتى لا تنهي سلسلة تحتوي على وسم إغلاق script الكتلة مبكرًا. وتفعل نماذج React وNext.js وAstro أدناه ذلك. أظهر تاريخًا مرئيًا واضبطdatePublishedوdateModifiedليطابقاه، بحسب إرشادات Google بشأن بيانات الكاتب.اعتبر FAQ schema اختياريًا
أنهت Google نتيجة FAQ المنسّقة في 7 مايو 2026. أبقِ ترميز FAQ فقط إذا كان يعكس أسئلة ظاهرة، ولا تتوقع مساحة إضافية في صفحة النتائج.
تحقق من نجاح الخطوةتحقق من نجاح الخطوة
اعرض مصدر الصفحة وتأكد من أن JSON-LD موجود في HTML الخام. شغّل Rich Results Test أو Schema Markup Validator، ثم قارن كل قيمة بما يراه الزائر.
فتح بالحجم الكامل (في علامة تبويب جديدة)
5. ما هو llms.txt، وهل تحتاج إليه؟
llms.txt مقترح مجتمعي اختياري: ملف Markdown في المسار /llms.txt يسرد صفحاتك الرئيسية لأدوات الذكاء الاصطناعي. تقول Google إن البحث لديها لا يستخدمه، فيمكنك الاستغناء عنه دون خسارة شيء.
الخطواتقرّر هل تنشر llms.txt
اعرف ما هو llms.txt
llms.txt ملف Markdown في جذر موقعك، اقترحه Jeremy Howard في 3 سبتمبر 2024، ونُشر له تنسيق الإصدار الثاني في أغسطس 2026. يتكون من عنوان H1 (وهو الجزء الوحيد المطلوب)، وملخص اختياري في اقتباس، وأقسام H2 تسرد الروابط بصيغة
- [name](url): notes.ما يفعله اليوم
تقول Google إن البحث لديها لا يتضرر ولا يستفيد منه. ولا تذكر أي من وثائق الزواحف التي راجعناها من OpenAI وAnthropic وPerplexity وBing وApple وMeta أن زاحفها يقرأه. ولدى Lighthouse في Chrome تدقيق للتصفح الوكيلي يُصنَّف «غير منطبق» عند غياب الملف. ويذكر إرشاد Vercel لعام 2026 أن إضافة llms.txt لم تغيّر الاسترجاع حين كانت الإجابة موجودة أصلًا في HTML الخادم، وأن 86 بالمئة من عمليات الجلب المنسوبة وصلت عبر روابط الصفحات.
قرّر هل تنشره
هو اختياري ورخيص، فاعتمد عليه بعد الأساسيات. وأبقِه صغيرًا. أما
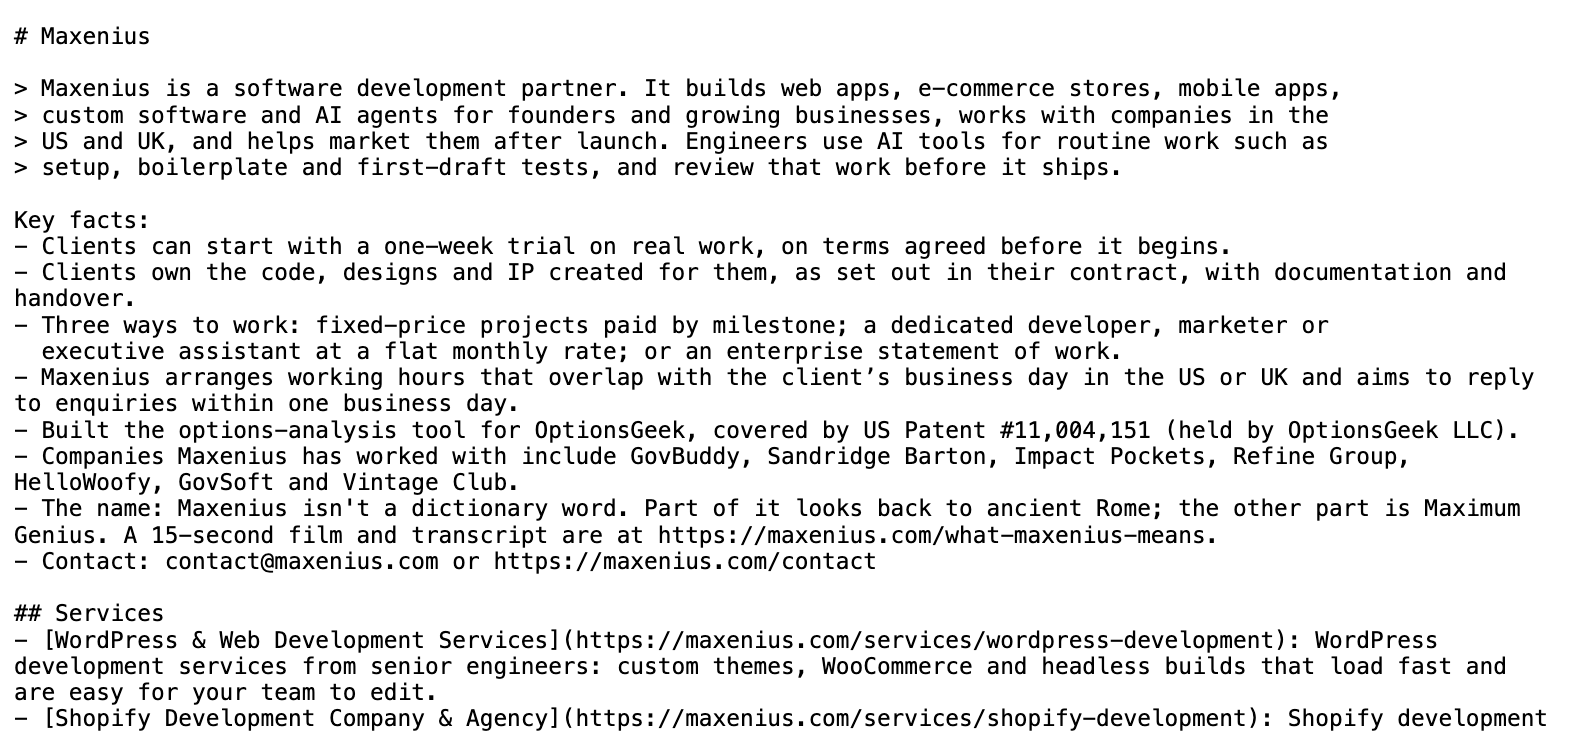
llms-full.txtفهو عُرف تولّده بعض منصات التوثيق، وليس جزءًا من المواصفة، وقد تبلغ ملفاته الفعلية عشرات الميغابايت. ويقدّم ملف/llms.txtالافتراضي في Shopify تعليمات للوكلاء، وهو مشروح في قسم Shopify.public/llms.txtحقائق افتراضية، تنسيق الإصدار الثاني # Example Co > Example Co makes refillable cleaning products and sells them online to customers in the US and Canada. Key facts: - Free shipping on US orders over $50; returns accepted within 30 days. - Support: support@example.com, Monday to Friday. ## Products - [All products](https://www.example.com/collections/all): Full catalog with prices and stock status - [Refill subscriptions](https://www.example.com/pages/subscriptions): How refills are billed, paused and cancelled ## Policies - [Shipping policy](https://www.example.com/policies/shipping-policy): Carriers, delivery times and costs - [Refund policy](https://www.example.com/policies/refund-policy): Return window and how refunds are paidتحقق من نجاح الخطوةتحقق من نجاح الخطوة
نفّذ
curl -sI https://yourdomain.com/llms.txtوتوقع الحالة 200 ونوع محتوى نصيًا. ثم الصق الملف وحده في مساعد ذكاء اصطناعي واسأله عن نشاطك.
فتح بالحجم الكامل (في علامة تبويب جديدة)
قالب llms.txt للبدء
المثال أعلاه كملف للتنزيل، مع حقائق افتراضية تستبدلها ببياناتك.
Any
6. حافظ على اتساق الكيان وعناوين URL
الخطواتعرّف بنفسك مرة واحدة، وفي عنوان واحد
انشر ترميز Organization
أضف JSON-LD من نوع Organization في الصفحة الرئيسية مع الاسم وurl وlogo والوصف وروابط
sameAsإلى ملفاتك الحقيقية، وفق وثيقة Google الخاصة بOrganization. استخدم الاسم نفسه في كل مكان كما تطلب إرشادات Bing، وأبقِ بيانات Business Profile وBing Places وMerchant Center متسقة.اختر مضيفًا واحدًا
يجب أن تتفق وسوم canonical وقيم
locفي خريطة الموقع ووجهة إعادة التوجيه. تعامل Google إعادات التوجيه وrel=canonical على أنها إشارات قوية وخريطة الموقع إشارة ضعيفة، وتنصح بعدم الإعلان عن عناوين URL مختلفة بطرق مختلفة. وتشير Bing إلى أن النماذج اللغوية الكبيرة تجمّع النسخ المتشابهة وقد تختار عنوانًا قديمًا لتمثيلها.اضبط lastmod من تغييرات حقيقية
غيّر
lastmodفقط عند تغيّر المحتوى الرئيسي أو البيانات المنظمة أو الروابط، وليس إلى وقت البناء أبدًا. تتجاهل Google القيمتينpriorityوchangefreq، وتقول Bing الأمر نفسه. واقرنه بتاريخ مرئي وبdateModified.أرسل إشعارًا عبر IndexNow لBing
يُخطر IndexNow محرك Bing وغيره من المحركات المشاركة بالتغييرات. وGoogle ليست مشاركة. واستجابة HTTP 200 تعني أن عنوانك استُلم، لا أنه فُهرس.
تحقق من نجاح الخطوةتحقق من نجاح الخطوة
نفّذ
curl -sI https://example.com/page | grep -i -E '^HTTP/|^location'لكل صيغة من صيغ المضيف، ثم قارن وجهة إعادة التوجيه بcanonical الصفحة وبإدخالها في خريطة الموقع. يجب أن تكون الثلاثة عنوان URL واحدًا.
JSON-LD لOrganization
قالب ترميز الكيان مع قيم افتراضية وروابط sameAs.
Any
كيف تحسّن WordPress للبحث بالذكاء الاصطناعي (وتضيف llms.txt): خطوة بخطوة
يعمل هذا القسم على موقع WordPress عادي، بوجود إضافة SEO أو دونها. تنتهي كل خطوة بفحص من سطر واحد، وتشغّل الخطوة الأخيرة أربعة أوامر في الطرفية تؤكد الإعداد بأكمله.
اعثر على إعدادات إضافة SEO لديك
تعتمد معظم الخيارات أدناه على هذا الجدول. اعثر على عمودك أولًا، ثم اتبع الخطوات.
| Yoast SEO | Rank Math | AIOSEO | |
|---|---|---|---|
| llms.txt | مجاني منذ 25.3 (10 يونيو 2025). Yoast SEO > Settings > Site features > AI tools > LLMS.txt. يكتب ملفًا فعليًا ويحدّثه أسبوعيًا. وقالت Yoast إنه غير متاح في الشبكات متعددة المواقع (مسألة على GitHub). | منذ 1.0.250 (31 يوليو 2025). فعّل الوحدة من Rank Math SEO > Dashboard، ثم Rank Math SEO > General Settings > Edit llms.txt. يكون فارغًا حتى تضبطه. | مدمج؛ راجع سجل تغييرات AIOSEO. يتضمن llms-full.txt ونسخ Markdown للمقالات. All in One SEO > Sitemaps > تبويب LLMs.txt. مفعّل افتراضيًا، ويُكتب كملف ثابت. |
| محرر robots.txt | Yoast SEO > Tools > File editor > Create robots.txt file. هذا ينشئ ملفًا فعليًا. | Rank Math SEO > General Settings > Edit robots.txt. ملف افتراضي (غير فعلي)؛ وبحسب قاعدة معارف Rank Math، فإن وجود ملف فعلي في الجذر يمنع التحرير. | All in One SEO > Tools > Robots.txt Editor > Enable Custom Robots.txt. يتضمن خيار حظر زواحف الذكاء الاصطناعي. |
| عنوان خريطة الموقع | /sitemap_index.xml (يحل محل /wp-sitemap.xml في نواة WordPress) | /sitemap_index.xml | خريطة موقع افتراضية، تُدار ضمن All in One SEO > Sitemaps |
| IndexNow | في النسخة المدفوعة فقط | وحدة Instant Indexing | مدمج |
تقدّم نواة WordPress الملف /wp-sitemap.xml من تلقاء نفسها. وإذا لم تكن لديك إضافة SEO، فإن إضافة IndexNow الرسمية تغطي IndexNow.
الخطواتإعداد WordPress للبحث بالذكاء الاصطناعي
تأكد من أن المحتوى في HTML
افتح صفحة رئيسية، واختر View Source (وليس Inspect)، وابحث عن جملة من النص. أو نفّذ
curl -s https://example.com/page/ | grep -i "a sentence from the page". تُولِّد السمات ومنشئو الصفحات الشائعون المحتوى على الخادم، لكن المحتوى الموجود في علامات تبويب AJAX والعارضات الشريطية وأدوات «تحميل المزيد» قد لا يكون موجودًا.تأكد من أن التنقل يستخدم روابط
<a href>حقيقية، لأن Google لا تستطيع الزحف إلا إلى الروابط المبنية بهذه الطريقة. ثم افتح Settings > Reading وتأكد من أن خيار «Search engine visibility» غير مفعّل. فعند تفعيله، تضيف نسخ WordPress الحالية وسم robots meta بقيمة noindex إلى كل صفحة، بدلًا من سطر Disallow في robots.txt.الفحص: تظهر جملتك في مخرجات curl، ويعيد
curl -s https://example.com/ | grep -i noindexنتيجة فارغة.تحكّم في robots.txt
في غياب ملف فعلي، يبني WordPress ملف robots.txt افتراضيًا ويمرره عبر المرشّح
robots_txt. والملف robots.txt الفعلي في جذر الموقع يتجاوز هذا المرشّح وكل محررات الإضافات في الجدول، ومحرر الملفات في Yoast ينشئ ملفًا كهذا تمامًا. اعرف في أي حالة أنت قبل تعديل أي شيء.إذا أردت مجموعة صريحة للذكاء الاصطناعي، فاستخدم إضافة mu-plugin المسماة geo-robots.php أدناه. وهي تكرر قواعد المسؤول داخل المجموعة، لأنه بموجب RFC 9309 لا يلتزم الزاحف الذي يجد مجموعة تسميه إلا بتلك المجموعة.
أبقِ خيار Block AI Crawlers في AIOSEO وBot blocker في Yoast Premium معطّلين إذا أردت الظهور في البحث بالذكاء الاصطناعي. وإذا كان الموقع خلف Cloudflare، فافحص ملف robots.txt المُدار لديها، فهو يضيف قواعد Disallow فوق ملفك.
الفحص: يُظهر
curl -s https://example.com/robots.txtالقواعد التي تتوقعها. وتقول OpenAI إن التغييرات قد تستغرق نحو 24 ساعة لتصل إلى بحث ChatGPT.قرّر أي الزواحف تسمح لها
زواحف البحث والاستشهاد هي OAI-SearchBot وClaude-SearchBot وPerplexityBot. أما زواحف التدريب مثل GPTBot وClaudeBot فقرار منفصل، وحظرها لا يُخرجك من بحث ذلك المزوّد. جدول المزوّدين الكامل في قسم الأسس.
الفحص: لا يرد اسم أي زاحف تريده في البحث ضمن مجموعة Disallow.
انشر llms.txt من مصدر واحد فقط
اختر ميزة الإضافة من الجدول، أو استخدم geo-llms-txt.php إن لم تكن لديك إضافة. لا تشغّل مصدرين أبدًا. فYoast لن يكتب فوق ملف موجود، وقد يحجب الملف الثابت ملفًا ديناميكيًا من إضافة أخرى.
العائد غير مؤكد، كما في قسم llms.txt. وتقول وثائق Rank Math نفسها إن الاعتماد عليه محدود. وكلفته قليلة، فاعتبره فهرسًا مرتبًا لأفضل صفحاتك.
الفحص: يعيد
curl -sI https://example.com/llms.txtالحالة 200، ويبدأ المحتوى ب# Your site name.أضف البيانات المنظمة عبر إضافتك
لا تلصق كتلة Organization ثانية. يُخرج Yoast مخططًا مترابطًا واحدًا (@graph) ويتيح مرشّحات مثل
wpseo_schema_organization(Schema API). اضبط الاسم والشعار والملفات أولًا في Yoast SEO > Settings > Site representation. ويتيح Rank Math توسيع الناشر عبرrank_math/json_ld. وفي غياب إضافة، استخدم geo-schema.php.الفحص: نفّذ
curl -s https://example.com/ | grep -c 'application/ld+json'، ثم الصق كل كتلة في validator.schema.org وتأكد من وجود عقدة Organization واحدة.أكمل بيانات الكاتب والكيان
أكمل Users > Profile (الاسم المعروض والنبذة والموقع) لأن إضافات SEO تقرأ بيانات الكاتب منه. وبحسب إرشادات Google لArticle، يحمل
author.nameالاسم فقط، ويشيرauthor.urlإلى صفحة تعرّف بالكاتب تعريفًا فريدًا. أما للشركة فإن ترميز Organization مكانه الصفحة الرئيسية أو صفحة «من نحن»، وتوصي Google بتضمين name وurl وlogo وsameAs وبيانات الاتصال.الفحص: يرتبط اسم الكاتب أسفل المقال بصفحة كاتب، ويُظهر مصدر الصفحة الاسم نفسه في JSON-LD الخاص بArticle.
اربط داخليًا بنصوص رابط وصفية
من كل صفحة محورية (الخدمات أو التصنيف أو الدليل) اربط بصفحات التفاصيل بنص رابط يصف الهدف. فعبارة «قائمة إعداد WooCommerce لدينا» تخبر الزاحف أكثر من «اقرأ المزيد».
الفحص: لكل صفحة مهمة رابط نصي واحد على الأقل يشير إليها من صفحة أخرى.
شغّل مولّد خريطة موقع واحدًا
استخدم النواة أو Yoast أو Rank Math أو AIOSEO، وليس أكثر من واحد. أرسل العنوان في Google Search Console وBing Webmaster Tools. وتطلب Bing قيم lastmod دقيقة بصيغة ISO 8601 مع التاريخ والوقت.
الفحص: يفتح عنوان خريطة الموقع من الجدول، ولا تتغير قيمة lastmod إلا حين تعدّل صفحة فعلًا.
فعّل IndexNow، بمرسِل واحد
اختر إضافة IndexNow الرسمية أو Instant Indexing من Rank Math أو AIOSEO أو Yoast Premium. تشغيل أكثر من واحدة يكرر الإرسال. وIndexNow يشارك العناوين المرسلة مع كل المحركات المشاركة.
الفحص: انشر مقالًا تجريبيًا وابحث عنه في قائمة عمليات الإرسال الأخيرة في الإضافة.
أكمل بيانات منتجات WooCommerce
لكل منتج، املأ Product data > Inventory > SKU وحقل «GTIN, UPC, EAN, or ISBN»، واكتب وصفًا مختصرًا حقيقيًا. يُخرج WooCommerce 11.1.2 ترميز Product بصيغة JSON-LD يتضمن sku وgtin وoffers والتقييمات، ويتيح توسيعه عبر
woocommerce_structured_data_product. ويضيف ملف المرشّحات أدناه علامة تجارية (brand). وإذا كانت إضافة SEO تُخرج Product أيضًا، فقارن الكتلتين.يخطط WooCommerce في الفرع الرئيسي لإضافة ترميز OnlineStore وMerchantReturnPolicy في إصدار لاحق (موسوم 11.3.0)، فهو غير موجود في 11.1.2.
الفحص: اعرض مصدر صفحة منتج وتأكد من وجود عقدة Product واحدة فقط تحتوي على GTIN الخاص بك.
تحقق من نجاح الخطوةتحقق من كل شيء من الطرفية
استبدل النطاق والعبارة، ثم نفّذ الأوامر الأربعة:
يعرض
curl -s https://example.com/robots.txtالمجموعات التي تقصدها وسطر Sitemap.يعيد
curl -sI https://example.com/llms.txtالحالة 200 والنوع text/plain.يعيد
curl -s https://example.com/ | grep -c 'application/ld+json'عدد الكتل التي تتوقعها.يعثر
curl -s https://example.com/some-page/ | grep -i "a sentence from the body"على نصك.
شيفرات يمكنك إضافتها مباشرة
ضع هذه الملفات في wp-content/mu-plugins/. فإن WordPress يحمّل ملفات PHP في المستوى الأعلى هناك تلقائيًا. وكل ملف موجود أيضًا في حزمة البداية.
<?php
/**
* Plugin Name: GEO robots.txt rules
* Description: Adds an explicit group for AI search crawlers to the virtual robots.txt.
*/
defined( 'ABSPATH' ) || exit;

add_filter(
'robots_txt',
function ( $output, $is_public ) {
	if ( ! $is_public ) {
		return $output;
	}
	$admin_path = wp_parse_url( admin_url(), PHP_URL_PATH );
	$ajax_path  = wp_parse_url( admin_url( 'admin-ajax.php' ), PHP_URL_PATH );
	// A crawler that finds a group naming it obeys only that group (RFC 9309).
	$bots  = array( 'OAI-SearchBot', 'ChatGPT-User', 'Claude-SearchBot', 'Claude-User', 'PerplexityBot', 'Perplexity-User' );
	$group = "\n# AI search and answer crawlers\n";
	foreach ( $bots as $bot ) {
		$group .= 'User-agent: ' . $bot . "\n";
	}
	$group .= 'Disallow: ' . $admin_path . "\n";
	$group .= 'Allow: ' . $ajax_path . "\n";
	return $output . $group;
},
99,
2
);
المخرجات، مضافة بعد الإعداد الافتراضي للنواة:
# AI search and answer crawlers
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Perplexity-User
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php<?php
/**
* Plugin Name: GEO llms.txt
* Description: Serves /llms.txt (llmstxt.org format) without an SEO plugin.
* A physical llms.txt in the web root wins over this code.
*/
defined( 'ABSPATH' ) || exit;
const GEO_LLMS_REWRITE_VERSION = '1';
add_action( 'init', function () {
add_rewrite_rule( '^llms\.txt$', 'index.php?geo_llms_txt=1', 'top' );
// mu-plugins have no activation hook, so flush once per rule version.
if ( get_option( 'geo_llms_rewrite_version' ) !== GEO_LLMS_REWRITE_VERSION ) {
flush_rewrite_rules( false );
update_option( 'geo_llms_rewrite_version', GEO_LLMS_REWRITE_VERSION );
}
} );
add_filter( 'query_vars', function ( $vars ) {
$vars[] = 'geo_llms_txt';
return $vars;
} );
// Priority 0 runs before redirect_canonical (priority 10).
add_action( 'template_redirect', function () {
if ( ! get_query_var( 'geo_llms_txt' ) ) {
return;
}
$body = get_transient( 'geo_llms_txt_body' );
if ( false === $body ) {
$body = geo_llms_build();
set_transient( 'geo_llms_txt_body', $body, 12 * HOUR_IN_SECONDS );
}
status_header( 200 );
header( 'Content-Type: text/plain; charset=utf-8' );
echo $body; // phpcs:ignore WordPress.Security.EscapeOutput.OutputNotEscaped
exit;
}, 0 );
add_action( 'save_post', function () {
delete_transient( 'geo_llms_txt_body' );
} );
function geo_llms_build() {
$clean = function ( $text ) {
$text = wp_strip_all_tags( html_entity_decode( (string) $text, ENT_QUOTES, 'UTF-8' ) );
return trim( preg_replace( '/\s+/', ' ', $text ) );
};
$lines = array( '# ' . $clean( get_bloginfo( 'name' ) ), '' );
$tagline = $clean( get_bloginfo( 'description' ) );
if ( '' !== $tagline ) {
$lines[] = '> ' . $tagline;
$lines[] = '';
}
$sections = array(
'Pages' => array( 'post_type' => 'page', 'orderby' => 'menu_order title', 'order' => 'ASC' ),
'Articles' => array( 'post_type' => 'post', 'orderby' => 'modified', 'order' => 'DESC' ),
);
if ( post_type_exists( 'product' ) ) {
$sections['Products'] = array( 'post_type' => 'product', 'orderby' => 'modified', 'order' => 'DESC' );
}
foreach ( $sections as $heading => $args ) {
$posts = get_posts( array_merge( $args, array(
'post_status' => 'publish', 'posts_per_page' => 50, 'has_password' => false, 'suppress_filters' => false,
) ) );
if ( ! $posts ) {
continue;
}
$lines[] = '## ' . $heading;
$lines[] = '';
foreach ( $posts as $post ) {
$summary = $clean( has_excerpt( $post ) ? get_the_excerpt( $post ) : wp_trim_words( strip_shortcodes( $post->post_content ), 30, '' ) );
$title = str_replace( array( '[', ']' ), array( '(', ')' ), $clean( get_the_title( $post ) ) );
$line = sprintf( '- [%s](%s)', $title, esc_url_raw( get_permalink( $post ) ) );
if ( '' !== $summary ) {
$line .= ': ' . $summary;
}
$lines[] = $line;
}
$lines[] = '';
}
return implode( "\n", $lines );
}لا تعرف هذه النسخة أعلام noindex الخاصة بكل مقال في إضافات SEO، وهذا سبب آخر لاستخدامها على المواقع التي لا تستخدم إضافة كهذه فقط.
<?php
defined( 'ABSPATH' ) || exit;

function geo_print_jsonld( array $data ) {
echo '<script type="application/ld+json">'
	. wp_json_encode( $data, JSON_UNESCAPED_SLASHES | JSON_UNESCAPED_UNICODE | JSON_HEX_TAG )
	. "</script>\n";
}

// Organization on the front page (edit the values).
add_action( 'wp_head', function () {
if ( ! is_front_page() ) {
	return;
}
geo_print_jsonld( array(
	'@context'     => 'https://schema.org',
	'@type'        => 'Organization',
	'@id'          => home_url( '/#organization' ),
	'name'         => get_bloginfo( 'name' ),
	'url'          => home_url( '/' ),
	'logo'         => get_site_icon_url( 512 ),
	'description'  => get_bloginfo( 'description' ),
	'sameAs'       => array( 'https://www.linkedin.com/company/your-company' ),
	'contactPoint' => array( '@type' => 'ContactPoint', 'contactType' => 'sales', 'email' => 'hello@example.com' ),
) );
} );

// FAQPage from a "geo_faqs" custom field: [{"q":"...","a":"..."}]. Mark up only visible FAQs.
add_action( 'wp_head', function () {
if ( ! is_singular() ) {
	return;
}
$faqs = json_decode( (string) get_post_meta( get_queried_object_id(), 'geo_faqs', true ), true );
if ( ! is_array( $faqs ) || ! $faqs ) {
	return;
}
$entities = array();
foreach ( $faqs as $faq ) {
	if ( empty( $faq['q'] ) || empty( $faq['a'] ) ) {
		continue;
	}
	$entities[] = array(
		'@type'          => 'Question',
		'name'           => wp_strip_all_tags( $faq['q'] ),
		'acceptedAnswer' => array( '@type' => 'Answer', 'text' => wp_kses_post( $faq['a'] ) ),
	);
}
if ( $entities ) {
	geo_print_jsonld( array( '@context' => 'https://schema.org', '@type' => 'FAQPage', 'url' => get_permalink(), 'mainEntity' => $entities ) );
}
} );<?php
defined( 'ABSPATH' ) || exit;
// Yoast SEO: extend the Organization piece from Settings > Site representation.
add_filter( 'wpseo_schema_organization', function ( $data ) {
$data['description'] = 'One plain sentence on what the company does and for whom.';
$data['email'] = 'hello@example.com';
return $data;
} );
// Rank Math: the publisher entity lives at $data['publisher'].
add_filter( 'rank_math/json_ld', function ( $data, $jsonld ) {
if ( isset( $data['publisher'] ) && is_array( $data['publisher'] ) ) {
$data['publisher']['description'] = 'One plain sentence on what the company does and for whom.';
}
return $data;
}, 99, 2 );
// WooCommerce core Product markup: add a brand.
add_filter( 'woocommerce_structured_data_product', function ( $markup, $product ) {
$markup['brand'] = array( '@type' => 'Brand', 'name' => get_bloginfo( 'name' ) );
return $markup;
}, 10, 2 );geo-robots.php
مجموعة زواحف الذكاء الاصطناعي لملف robots.txt الافتراضي.
WordPress
geo-llms-txt.php
llms.txt دون إضافة SEO.
WordPressWooCommerce
geo-schema.php
JSON-LD لOrganization وFAQ دون إضافة SEO.
WordPress
geo-schema-plugin-filters.php
مرشّحات لYoast وRank Math وWooCommerce.
WordPressWooCommerce
للحصول على مساعدة عملية، راجع فريق تطوير WordPress لدينا.
كيف تحسّن Shopify للبحث بالذكاء الاصطناعي وChatGPT: خطوة بخطوة
تنجز Shopify أصلًا معظم العمل التقني. فاعتبارًا من 7 أكتوبر 2026، يأتي كل متجر مع sitemap.xml تلقائي لا يمكنك تعديله، وملف robots.txt افتراضي، وJSON-LD من مرشّح structured_data في سمتي Dawn وHorizon. ومنذ 28 مايو 2026، يقدّم كل متجر أيضًا ملفات افتراضية هي /agents.md و/llms.txt و/llms-full.txt، بحسب سجل تغييرات Shopify.
وهناك حد واحد: لا شيء هنا يضمن أن تعرض ChatGPT أو Copilot أو Gemini منتجاتك. تقول Shopify إن تحسين بيانات المنتجات يزيد الفرص، ولا تقول إنه يضمنها.
الخطواتإعداد متجر Shopify للبحث بالذكاء الاصطناعي
افحص ما يقدّمه متجرك أصلًا
افتح هذه العناوين الأربعة في متجرك ودوّن ما تراه:
/robots.txtو/llms.txtو/agents.mdو/sitemap.xml.لا تتوقع أن يطابق ملف robots.txt لديك ملف أي متجر آخر. ففي 7 أكتوبر 2026 رأينا متاجر أحدث تقدّم ملفًا افتراضيًا تشير تعليقاته الوكلاء إلى
/agents.md، ومتاجر أخرى لا تزال تقدّم الملف الافتراضي الأقدم بمجموعات إضافية لأدوات مثل Nutch وAhrefsBot وPinterest. وكلاهما يترك زواحف الذكاء الاصطناعي تحت*.ملف
/llms.txtالافتراضي مجموعة تعليمات للوكلاء (اكتشاف UCP، ونقطة نهاية MCP، ونقاط نهاية JSON للقراءة فقط، وروابط السياسات). وهو ليس فهرسًا منتقى لمحتواك. ثم مرّر عنوان منتج واحد عبر Rich Results Test من Google.راجع واجهات المتاجر الوكيلية (Agentic storefronts)
في لوحة الإدارة، انتقل إلى Sales channels > Agentic. وبحسب مساعدة Shopify، فهذه الميزة مفعّلة افتراضيًا للمتاجر المؤهلة، وتتطلب الموافقة على الشروط التكميلية لواجهات المتاجر الوكيلية (Agentic Storefronts Supplemental Terms). وتسرد Shopify حاليًا ChatGPT وMicrosoft Copilot وGoogle AI Mode وGemini وMeta.
ما تحتاجه كل قناة:
- ChatGPT: هو مصدر إحالة للاكتشاف. يُتمّ المتسوقون الدفع في متجرك أنت. ويجب أن يبيع متجرك لعملاء في الولايات المتحدة، وإن كان مقره في مكان آخر.
- Copilot وGoogle: كلاهما يقدّم دفعًا مدعومًا من Shopify داخل المحادثة للمتاجر الأمريكية المؤهلة، وكلاهما يتطلب استكمال سياسات المتجر. وتحتاج Google أيضًا إلى حساب Merchant Center، مع مزامنة المنتجات عبر قناة Google وYouTube.
- Shopify Catalog: بحسب صفحة المتطلبات، تحتاج إلى خطة Starter أو أعلى ومتجر ليس في الوضع الخاص. ويحتاج كل منتج إلى عنوان وصورة واحدة على الأقل وسعر أكبر من صفر ونشر في قناة لها عنوان URL. ولا تتأهل المنتجات غير المدرجة أو المخفية عن البحث.
استخدم معاينة البحث في تلك الشاشة. فهي تقيّم كل منتج من حيث اكتمال الوصف وتغطية الصور والمراجعات وبيانات المتغيرات والسياسات. وقد يستغرق إيقاف وصول ChatGPT إلى الكتالوج ما يصل إلى 7 أيام ليسري.
أصلح بيانات منتجاتك
هنا يتحقق معظم المكسب. تغطي صفحة Shopify تحسين المنتجات لمنصات الذكاء الاصطناعي العنوان والوصف والصور والنوع والمورّد والمجموعات والوسوم والباركود وأسماء خيارات المتغيرات والسياسات. والبنود 1 و3 و4 و9 أدناه توصيات منا، مع المصادر حيث توفرت:
- العنوان: محدد، ويتضمن نوع المنتج والخاصية الرئيسية والعلامة التجارية. أبقِ عنوان SEO قريبًا من 60 حرفًا.
- الوصف: أجب عما يسأل عنه المشترون (المواد والأبعاد ولمن هو والعناية).
- الصور: عدة صور، لكل منها نص بديل وصفي.
- الفئة: اضبطها ضمن Products > (your product) > Category من تصنيف المنتجات القياسي، ثم املأ الحقول الوصفية (metafields) للفئة.
- النوع والمورّد والمجموعات والوسوم: املأ الأربعة جميعًا.
- الباركود: ISBN أو UPC أو GTIN لكل متغير يحمل واحدًا.
- أسماء خيارات المتغيرات: «Size» و«Color»، وليس «Option 1».
- السياسات: الاسترداد والخصوصية والشروط والشحن، مكتملة.
- المراجعات: تحتسبها معاينة البحث. ولا يُظهر مثال
structured_dataعلى shopify.dev أيaggregateRating، فافحص JSON-LD المعروض الصادر عن تطبيق المراجعات لديك. - تطبيق Knowledge Base (اختياري): تراجع فيه حقائق المتجر المولَّدة تلقائيًا وتكتب إجابات الأسئلة الشائعة لمنصات الذكاء الاصطناعي. وتقول Shopify إن هذه الإجابات لا تظهر في واجهة متجرك وإن التطبيق لا يغيّر عدد مرات ظهورك في نتائج الذكاء الاصطناعي.
خصّص llms.txt بقالب داخل السمة (اختياري)
انتقل إلى Online Store > Themes > … > Edit code، ثم أضف قالبًا في مجلد
templates. وبحسب وثائق agents.md.liquid، يغطيagents.md.liquidالعناوين الثلاثة جميعًا، بينما يغطيllms.txt.liquidذلك العنوان وحده. تبحث Shopify عن القالب الخاص بالمسار، ثمagents.md.liquid، ثم الافتراضي لديها.لا يوجد في هذه القوالب إلا الكائنان
requestوagents. ولا يمكنك المرور على المجموعات أو المقالات في حلقة، فاكتب روابطك يدويًا وأبقها محدّثة. أبقِ سطري UCP وMCP ديناميكيين عبرagents.*ولا تكتبهما ثابتين، ولا تُخرج أبدًا بيانات خاصة كالبريد الإلكتروني أو الهاتف.لا تعمل إعادات التوجيه ولا الملفات ولا وكلاء التطبيقات (app proxies) مع هذا الملف. فإعادات توجيه URL تعمل فقط على العناوين المعطوبة، والعنوان
/llms.txtيعيد الآن 200. والملفات المرفوعة (Files) لا تُقدَّم من الجذر. ووكلاء التطبيقات لا تعمل إلا تحت/aو/appsو/communityو/tools. القالب هو الطريق المدعوم.اعتبر هذا الملف مجاملة للوكلاء، وليس أداة للتأثير في الترتيب، فبحث Google لا يستخدم llms.txt.
لا تلمس robots.txt.liquid إلا إذا اضطررت إلى تغيير الوصول
انتقل إلى Online Store > Themes > … > Edit code > Add a new template > robots > Create template. تصف Shopify هذا بأنه غير مدعوم، ولا يستطيع الدعم مساعدتك فيه، وتحذّر من أن خطأً واحدًا قد يكلفك كل الزيارات. انسخ ملف
/robots.txtالحالي إلى مكان آمن أولًا. وحذف القالب يعيد الإعداد الافتراضي.أبقِ حلقة Shopify الافتراضية وأضف مجموعات نصية عادية حولها. والسبب المعتاد هو الامتناع عن تدريب النماذج، مثل GPTBot. وتوثّق OpenAI أن GPTBot وOAI-SearchBot مستقلان، فحظر GPTBot لا يُخرجك من بحث ChatGPT.
لا تضف مجموعات
Allowللترحيب بزواحف الذكاء الاصطناعي. انظر المزلق الأول أدناه.اترك ترميز Product للقالب وأثرِ ما سواه
يُخرج Dawn 16.0.0 وHorizon أصلًا
{{ product | structured_data }}و{{ article | structured_data }}. لا تضف كتلة Product ثانية مكتوبة يدويًا. فكيانان لمنتج واحد يتعارضان.ولتقوية بيانات Organization، املأ روابط التواصل الاجتماعي ضمن Theme settings > Social media وارفع شعارًا. وفي ترويسة Dawn تغذّي هذه القيم
sameAs، وتُعرض الإعدادات الفارغة كسلاسل فارغة. أما لصفحة أسئلة شائعة ظاهرة، فأضف قسمfaq-schema.liquidأدناه مستخدمًا المرشّح| json، وللأسئلة الموجودة في الصفحة فقط.انشر محتوى يجيب عن أسئلة المشترين
اكتب أدلة شراء ومقارنات ضمن Content > Blog posts واربطها بالمنتجات والمجموعات. أعطِ كل مجموعة وصفًا حقيقيًا مع عنوان SEO خاص بها (توصي Shopify بما لا يزيد على 60 حرفًا) ووصفًا بنحو 160 حرفًا. وضع أسئلة شائعة ظاهرة في صفحة ضمن Online Store > Pages، ثم اربطها من
llms.txt.liquid.تحقق من نجاح الخطوةتحقق من نجاح الخطوة
نفّذ هذه الأوامر من الطرفية، مستبدلًا النطاق ومعرّف المنتج (handle):
يُفترض أن يُظهر
curl -sI https://yourstore.com/llms.txt | head -n 5الحالة 200، وأن يُظهر طلب GET محتواك المعدّل.يُفترض أن يُظهر
curl -s https://yourstore.com/llms.txt | head -n 20عناوينك وروابطك.يُفترض أن يعيد كل من
curl -sI https://yourstore.com/agents.mdوcurl -sI https://yourstore.com/sitemap.xmlالحالة 200.يُفترض أن يظل
curl -s https://yourstore.com/robots.txtمحتويًا على قواعد منع السلة والدفع تحت*.يُفترض أن يُظهر
curl -s https://yourstore.com/products/your-handle | grep -oE '"@type" ?: ?"(Product|ProductGroup)"' | sort | uniq -cكيانًا واحدًا.أعد فحص معاينة البحث الوكيلي (Agentic) بعد ذلك.
شيفرات Shopify
القالب templates/llms.txt.liquid الخاص بك. استبدل النص الافتراضي ومسارات الصفحات بما يخصك:
# {{ agents.store_name }}

> Short, factual summary of what the store sells, who it is for, and where it ships.

## Key pages
- [All products]({{ agents.store_url }}/collections/all)
- [Best sellers]({{ agents.store_url }}/collections/best-sellers): our most ordered products
- [Size and fit guide]({{ agents.store_url }}/pages/size-guide)
- [FAQ]({{ agents.store_url }}/pages/faq): shipping, returns, care
- [Buying guides]({{ agents.store_url }}/blogs/guides)

## Policies
- [Refund policy]({{ agents.store_url }}/policies/refund-policy)
- [Shipping policy]({{ agents.store_url }}/policies/shipping-policy)

## For agents
- UCP discovery: {{ agents.ucp_discovery_url }}
- MCP endpoint: {{ agents.mcp_endpoint_url }}
- Sitemap: {{ agents.sitemap_url }}
- Prices are in {{ agents.currency }}.
يُبقي الملف robots.txt.liquid أدناه حلقة Shopify الافتراضية ويضيف قاعدة واحدة للامتناع عن التدريب. وبحسب shopify.dev، توضع المجموعات النصية لزاحف جديد خارج الحلقة:
{% for group in robots.default_groups %}
{{- group.user_agent }}
{%- for rule in group.rules -%}
  {{ rule }}
{%- endfor -%}
{%- if group.sitemap != blank -%}
  {{ group.sitemap }}
{%- endif -%}
{% endfor %}

User-agent: GPTBot
Disallow: /
نمط البيانات المنظمة الخاص بالسمة نفسها. هذا موجود أصلًا في Dawn، فلا تحتاج إليه إلا إذا بنيت قالبًا مخصصًا:
<script type="application/ld+json">
{{ product | structured_data }}
</script>

<script type="application/ld+json">
{{ article | structured_data }}
</script>
كتلة Organization من sections/header.liquid في Dawn 16.0.0، حرفيًا من Shopify/dawn. وهي مرجع، فلا حاجة إلى لصقها في سمة Dawn الأساسية:
<script type="application/ld+json">
{
  "@context": "http://schema.org",
  "@type": "Organization",
  "name": {{ shop.name | json }},
  {% if settings.logo %}
    "logo": {{ settings.logo | image_url: width: 500 | prepend: "https:" | json }},
  {% endif %}
  "sameAs": [
    {{ settings.social_twitter_link | json }},
    {{ settings.social_facebook_link | json }},
    {{ settings.social_pinterest_link | json }},
    {{ settings.social_instagram_link | json }},
    {{ settings.social_tiktok_link | json }},
    {{ settings.social_tumblr_link | json }},
    {{ settings.social_snapchat_link | json }},
    {{ settings.social_youtube_link | json }},
    {{ settings.social_vimeo_link | json }}
  ],
  "url": {{ request.origin | append: page.url | json }}
}
</script>
قسم FAQPage يدوي لصفحة أسئلة شائعة ظاهرة. نص السؤال افتراضي: استبدله بالسؤال والجواب كما يظهران في الصفحة تمامًا.
{%- comment -%} Add to the FAQ page template only {%- endcomment -%}
<script type="application/ld+json">
{
"@context": "https://schema.org",
"@type": "FAQPage",
"mainEntity": [
  {
    "@type": "Question",
    "name": {{ "How long does shipping take?" | json }},
    "acceptedAnswer": {
      "@type": "Answer",
      "text": {{ "Orders ship in 1 to 2 business days. US delivery takes 3 to 5 days." | json }}
    }
  }
]
}
</script>
أزالت Google نتيجة FAQ المنسّقة، فلا تضف هذا متوقعًا نجومًا أو مقتطفات قابلة للتوسيع. ويظل الترميز يصف الصفحة بدقة لأي محلل يقرؤه.
llms.txt.liquid
قالب llms.txt ديناميكي لسمة Shopify.
Shopify
robots.txt.liquid
الحلقة الافتراضية محفوظة، مع الامتناع عن التدريب.
Shopify
قسم FAQ schema
JSON-LD من نوع FAQPage لصفحة أسئلة شائعة ظاهرة.
Shopify
React وNext.js وAstro: خطوة بخطوة
للتقنيات المخصصة إخفاق واحد أهم من أي ملف تضيفه: أن تغيب الإجابة عن HTML الذي يرسله الخادم. افحص ذلك أولًا في أي إطار برمجي باختبار واحد: اجلب الصفحة كما يفعل زاحف لا ينفّذ JavaScript، وابحث عن جملة من النص.
افحص هل الإجابة في HTML الخادم قبل أي شيء آخر. وجدت دراسة Vercel وMERJ أن عدة زواحف ذكاء اصطناعي كبرى لم تعرض JavaScript، ووجدت متابعة Vercel لعام 2026 أن عميلًا يجلب الصفحة فقط لم يستطع الحصول على إجابة موجودة عبر JavaScript وحده. التواريخ والتفاصيل في أساس HTML الخادم. وتقول Google إن التوليد على الخادم أو المسبق ما زال فكرة ممتازة، وتصف العرض الديناميكي بأنه حل التفافي، وليس حلًا طويل الأمد.
#!/usr/bin/env bash
# Usage: ./check-ai-crawl.sh https://www.example.com/your-page "a sentence from the page"
# Fetches the page the way a crawler that does not run JavaScript sees it.
# This only tests user-agent rules. Firewalls that verify crawler IPs will treat
# your request as an impostor, so confirm with server logs as well.
URL="$1"; PHRASE="$2"
UA='Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot'
HTML=$(curl -sL -A "$UA" "$URL")
HEAD=${HTML%%</head>*}
echo "Status:        $(curl -s -o /dev/null -w '%{http_code}' -A "$UA" "$URL")"
echo "Redirects to:  $(curl -s -o /dev/null -w '%{redirect_url}' -A "$UA" "$URL")"
echo "Title in head: $(grep -o '<title>[^<]*' <<<"$HEAD" | sed 's/<title>//' | head -1)"
echo "Canonical:     $(grep -o '<link rel="canonical"[^>]*' <<<"$HEAD" | grep -o 'href="[^"]*' | sed 's/href="//' | head -1)"
echo "JSON-LD blocks: $(grep -o 'application/ld+json' <<<"$HTML" | wc -l | tr -d ' ')"
if grep -qF "$PHRASE" <<<"$HTML"; then echo "Phrase in raw HTML: YES"; else echo "Phrase in raw HTML: NO (content likely needs JavaScript)"; fi
شغّلناه على نسختين مبنيتين من المقال نفسه. أعاد تطبيق Vite الذي يعمل على العميل فقط div id="root" فارغًا، والعنوان «My App»، ولا JSON-LD. وكان النص داخل حزمة JavaScript بحجم 220 KB. أما المحتوى نفسه مولَّدًا مسبقًا باستخدام React Router فأعاد العنوان الحقيقي وcanonical وJSON-LD والعبارة.
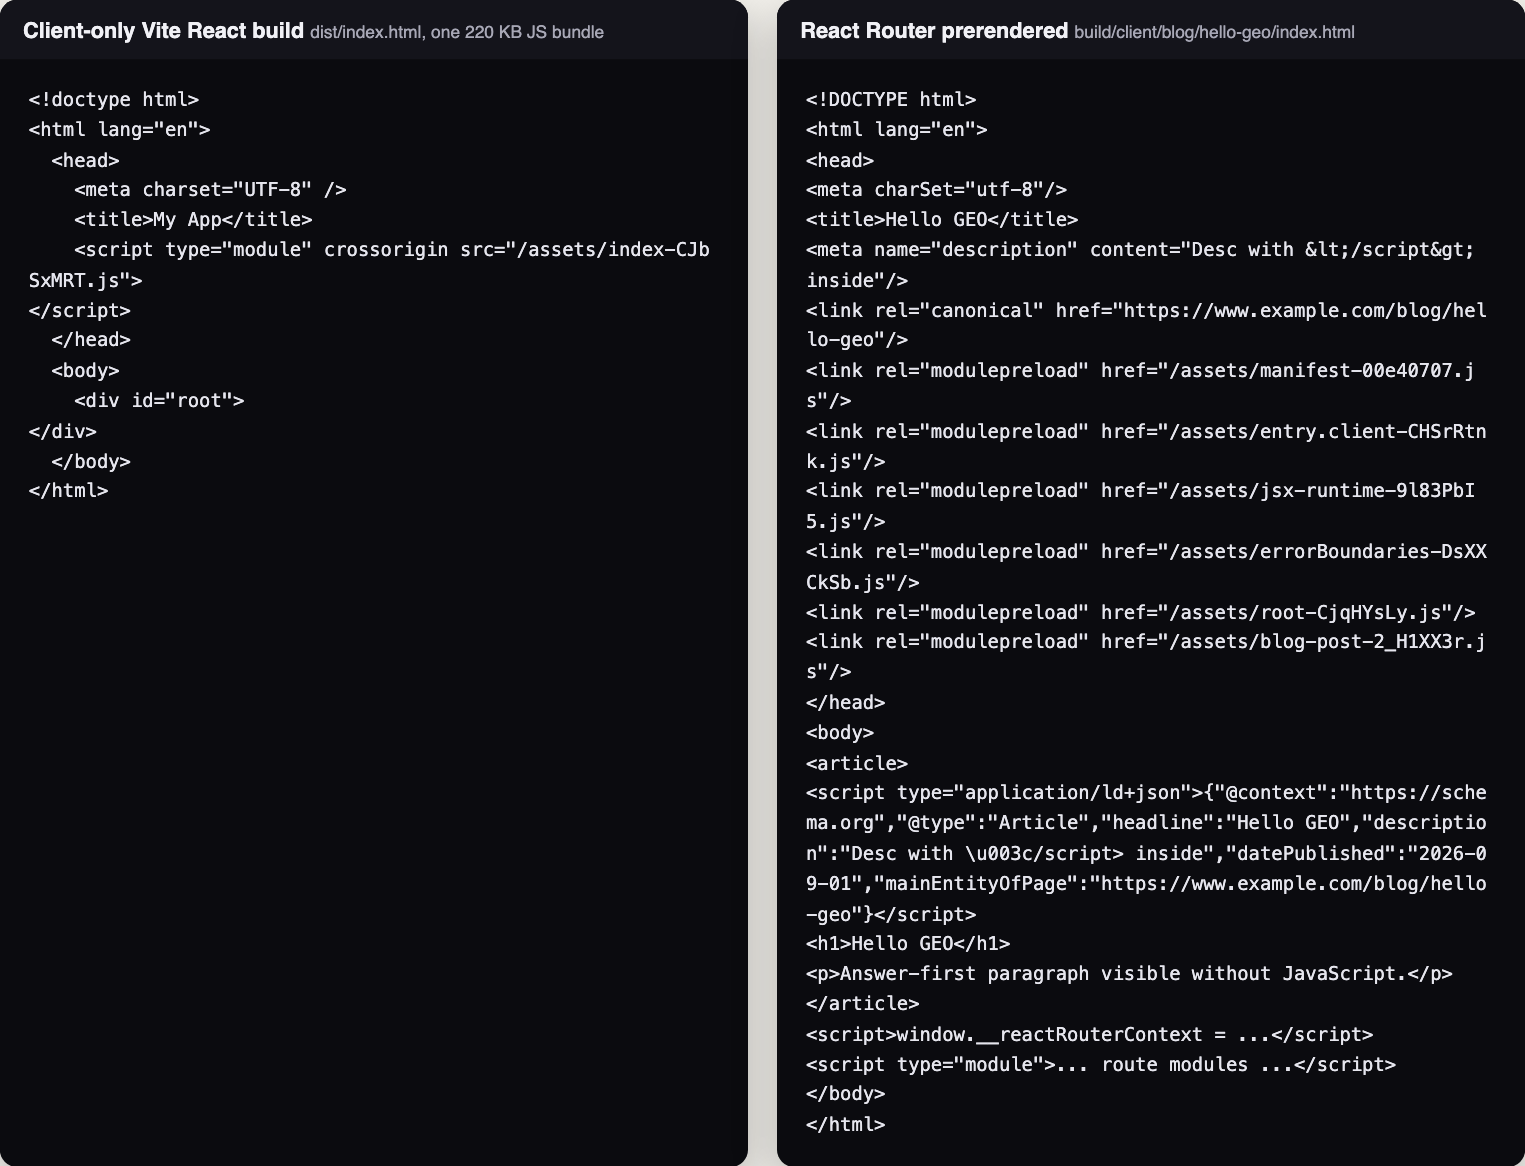
فتح بالحجم الكامل (في علامة تبويب جديدة)
React SEO لزواحف الذكاء الاصطناعي: ولِّد HTML مسبقًا
قد يظهر تطبيق React المعروض على العميل في ترتيب Google ويبقى فارغًا أمام الزواحف الأخرى، لأن Googlebot يعرض JavaScript. والاختبار في Google وحدها يخفي المشكلة.
الخطواتاجعل تطبيق React SPA مقروءًا دون JavaScript
شخّص عبر عرض المصدر
افتح صفحتك الرئيسية، واختر View Source (وليس DevTools) وابحث عن عنوانك الرئيسي. إذا وجدت
div id="root"فارغًا فالزواحف التي لا تعرض JavaScript لا تحصل على شيء. ثم شغّلcheck-ai-crawl.shأعلاه وابحث عن «Phrase in raw HTML: YES».اختر حلًا بهذا الترتيب
- وضع إطار React Router مع
prerenderوssr: false. تقول وثائقه إن التوليد المسبق مفيد لSEO، خاصة في عمليات النشر دون عرض على الخادم. - الانتقال إلى Next.js، وهو الموضوع التالي.
- لموقع تسويقي غني بالمحتوى: Astro مع جزر React.
- توليد مسبق مخصص ب
react-dom/static. يعمل لكنه منخفض المستوى، والأطر البرمجية تستدعيه عادةً نيابةً عنك.
تجنّب العرض الديناميكي. فقد أُوقف Create React App للتطبيقات الجديدة منذ 14 فبراير 2025. وراجع وثائق React Router للإصدار الذي ثبّتّه، لأن خيارات التوليد المسبق موثّقة لكل إصدار.
- وضع إطار React Router مع
ولِّد مسبقًا كل عنوان محتوى، بما فيه المعرّفات النصية (slugs)
يتجاوز
prerender: trueالمسارات الديناميكية مثل/blog/:slug. استخدم صيغة الدالة وأضف المعرّفات بنفسك.react-router.config.ts import type { Config } from '@react-router/dev/config' import { getPostSlugs } from './app/lib/posts' export default { // No runtime server: every listed URL becomes a static HTML file at build time. ssr: false, async prerender({ getStaticPaths }) { const slugs = await getPostSlugs() return [...getStaticPaths(), ...slugs.map((s) => '/blog/' + s)] }, } satisfies Configضع وسوم head في مكوّن المسار
يوصي React Router بالعناصر المدمجة
titleوmetaوlinkبدلًا من تصديرmetaفي وحدة المسار. وينقلها React 19 إلى head المستند. وفي بنائنا انتهت فيheadالملف المولَّد مسبقًا. أضف JSON-LD في المكوّن نفسه واهرب من<، لأنJSON.stringifyيترك</script>كما هو.app/routes/blog-post.tsx import { data, useLoaderData } from 'react-router' import { getPost } from '../lib/posts' const SITE_URL = 'https://www.example.com' // With prerendering, this loader runs at build time, so the post is in the HTML file. export async function loader({ params }: { params: { slug?: string } }) { const post = await getPost(params.slug ?? '') if (!post) throw data('Not found', { status: 404 }) return { post } } export default function BlogPost() { const { post } = useLoaderData<typeof loader>() const url = SITE_URL + '/blog/' + post.slug const article = { '@context': 'https://schema.org', '@type': 'Article', headline: post.title, description: post.description, datePublished: post.publishedAt, mainEntityOfPage: url, } return ( <article> <title>{post.title}</title> <meta name="description" content={post.description} /> <link rel="canonical" href={url} /> <script type="application/ld+json" dangerouslySetInnerHTML={{ __html: JSON.stringify(article).replace(/</g, '\u003c') }} /> <h1>{post.title}</h1> <p>{post.body}</p> </article> ) }انشر مع بديل ضيق النطاق
قدّم
build/client. وأعد كتابة المسارات التي لم تولّدها مسبقًا فقط إلى__spa-fallback.html. هذه الإعادة تردّ 200 على كل عنوان مجهول، فأبقِ خريطة موقعك دقيقة. وفي بيانات Vercel لعام 2024 رأت زاحف ChatGPT يصرف حصة كبيرة من عمليات الجلب على أخطاء 404، لذلك فالعناوين المعطوبة أو الشاردة تكلّفك.تحقق من نجاح الخطوةتحقق من نجاح الخطوة
ينبغي أن يطبع سجل البناء سطرًا مثل
Prerender (html): /blog/hello-geo -> build/client/blog/hello-geo/index.html. افتح ذلك الملف وتأكد من وجود العنوان وcanonical ونص المقال فيه، ثم شغّلcheck-ai-crawl.shعلى العنوان المنشور. المطلوب هوPhrase in raw HTML: YES.
react-router.config.ts
إعداد التوليد المسبق مع المعرّفات الديناميكية.
React
مسار مقال المدونة
وسوم head وJSON-LD المُهرَّب منه في مكوّن المسار.
React
Next.js SEO وllms.txt (App Router)
يستطيع Next.js إرسال HTML كامل، لكن من السهل بناء صفحة لا تفعل ذلك. بُنيت هذه الخطوات واختُبرت على Next.js 16.4.0 (والوثائق للإصدار نفسه).
الخطواتأرسل نص الإجابة والبيانات الوصفية في الاستجابة الأولى
أبقِ نص الإجابة في مكوّنات الخادم
الصفحات والتخطيطات مكوّنات خادم افتراضيًا. وتُولَّد مكوّنات العميل مسبقًا أيضًا، لكن البيانات المحمّلة في
useEffectليست في ذلك HTML. وفي اختبارنا على 16.4.0، أرسلت صفحة'use client'تحمّل نصها في effect ملف HTML لا يحتوي إلا على «Loading…». استخدم مكوّنات العميل للتفاعل، وليس للإجابة.اضبط البيانات الوصفية الجذرية بmetadataBase
في
app/layout.tsx، صدّرmetadataمعmetadataBase: new URL(SITE_URL)وقالب للعنوان وalternates.canonicalوopenGraph. وتصديرات البيانات الوصفية لا تعمل إلا في مكوّنات الخادم.استخدم generateMetadata وgenerateStaticParams
paramsهو Promise في الإصدارات الحالية. وتوليد المقالات مسبقًا يعني أن البيانات الوصفية والمقال كاملًا موجودان في HTML الأولي، ويظهر المسار على أنه SSG في جدول البناء.app/blog/[slug]/page.tsx import type { Metadata } from 'next' import { notFound } from 'next/navigation' import { getPost, getPosts } from '@/lib/posts' import { SITE_URL } from '@/lib/site' import { jsonLd } from '@/lib/json-ld' type Props = { params: Promise<{ slug: string }> } // Prerender every post at build time so the full article is in the HTML response. export async function generateStaticParams() { return (await getPosts()).map((p) => ({ slug: p.slug })) } export async function generateMetadata({ params }: Props): Promise<Metadata> { const { slug } = await params const post = await getPost(slug) if (!post) return {} return { title: post.title, description: post.description, alternates: { canonical: '/blog/' + post.slug }, } } export default async function Page({ params }: Props) { const { slug } = await params const post = await getPost(slug) if (!post) notFound() const article = { '@context': 'https://schema.org', '@type': 'Article', headline: post.title, datePublished: post.publishedAt, dateModified: post.updatedAt ?? post.publishedAt, mainEntityOfPage: SITE_URL + '/blog/' + post.slug, } return ( <article> <script type="application/ld+json" dangerouslySetInnerHTML={{ __html: jsonLd(article) }} /> <h1>{post.title}</h1> <div>{post.body}</div> </article> ) }اعرض JSON-LD كوسم script أصلي ومُهرَّب
يقول دليل JSON-LD في Next.js إن عليك استخدام وسم
scriptعاديًا، وليسnext/script، واستبدال<بتهريبه بصيغة unicode لأنJSON.stringifyلا ينقّي المدخلات. ضع ذلك في دالة مساعدة واحدة.lib/json-ld.ts // JSON.stringify does not escape "<", so "</script>" inside a value would end the tag early. export function jsonLd(data: object): string { return JSON.stringify(data).replace(/</g, '\u003c') }اكتب robots.ts مع تكرار قواعد المنع
يقبل
app/robots.tsمصفوفة فيuserAgent. ويلتزم الزاحف بأكثر مجموعة مطابقة تحديدًا فقط، فكرّر قواعد المنع. وعامل زواحف التدريب على أنها قرار منفصل عن زواحف البحث.app/robots.ts import type { MetadataRoute } from 'next' import { SITE_URL } from '@/lib/site' export default function robots(): MetadataRoute.Robots { return { rules: [ { userAgent: '*', allow: '/', disallow: ['/api/', '/account/'] }, { userAgent: [ 'OAI-SearchBot', 'ChatGPT-User', 'Claude-SearchBot', 'Claude-User', 'PerplexityBot', 'Perplexity-User', 'GPTBot', 'ClaudeBot', 'Google-Extended', ], allow: '/', disallow: ['/api/', '/account/'], }, ], sitemap: SITE_URL + '/sitemap.xml', } }اكتب sitemap.ts بقيمة lastModified حقيقية
تتجاهل Google القيمتين priority وchangefreq ولا تستخدم lastmod إلا إذا كانت دقيقة باستمرار. خذ التاريخ من المحتوى، وليس من
new Date()أبدًا.app/sitemap.ts import type { MetadataRoute } from 'next' import { getPosts } from '@/lib/posts' import { SITE_URL } from '@/lib/site' export default async function sitemap(): Promise<MetadataRoute.Sitemap> { const posts = await getPosts() return [ { url: SITE_URL, lastModified: '2026-10-01' }, ...posts.map((p) => ({ url: SITE_URL + '/blog/' + p.slug, lastModified: p.updatedAt ?? p.publishedAt, })), ] }قدّم llms.txt من معالج مسار
معالجات مسارات GET لا تُخزَّن مؤقتًا افتراضيًا، فأضف
force-static. وإذا فعّلتcacheComponentsفاحذف ذلك السطر: فالخيار يُزال في ذلك الوضع، ويُولَّد المعالج الذي لا يقرأ بيانات الطلب مسبقًا. ابنِ القائمة من دالة المقالات نفسها التي تستخدمها الصفحات.app/llms.txt/route.ts import { getPosts } from '@/lib/posts' import { SITE_NAME, SITE_URL } from '@/lib/site' // Delete this line if cacheComponents is enabled. export const dynamic = 'force-static' export async function GET() { const posts = await getPosts() const body = [ '# ' + SITE_NAME, '', '> One or two sentences: what you do, for whom, and where.', '', '## Guides', ...posts.map((p) => '- [' + p.title + '](' + SITE_URL + '/blog/' + p.slug + '): ' + p.description), '', ].join('\n') return new Response(body, { headers: { 'Content-Type': 'text/plain; charset=utf-8' } }) }ينطبق التنبيه السابق نفسه: هذا الملف مكمّل لHTML الخادم، وليس بديلًا عنه.
تعامل مع المسارات وقت الطلب: فخ htmlLimitedBots
المسارات التي تقرأ ملفات تعريف الارتباط أو الترويسات أو بيانات غير مخزنة مؤقتًا تُعرض وقت الطلب. ومنذ Next.js 15.2، تُبَثّ مخرجات
generateMetadataفيها إلىbodyلأي زاحف ليس في قائمة الزواحف المحدودة بHTML. قرأنا القائمة الافتراضية في الشيفرة المصدرية ولا تضم أي زاحف ذكاء اصطناعي. وفي اختبارنا على 16.4.0، حصل GPTBot وClaudeBot علىtitleفيbodyافتراضيًا، وفيheadبعد أن أضفناهما.ضبط الخيار يستبدل القائمة الافتراضية، فانسخ الافتراضية وأضف إليها زواحف الذكاء الاصطناعي. أعد فحص النسخة عند كل ترقية لNext.js. ولا تتأثر الصفحات المولَّدة مسبقًا كاملةً. وتقول وثائق Next.js إن البث لا يضر بSEO؛ وهذا القول يخص Google التي تنفّذ JavaScript، فلا تعمّمه على زواحف الذكاء الاصطناعي.
next.config.ts import type { NextConfig } from 'next' // Copied from the Next.js default (canary html-bots.ts, October 2026). Re-check on upgrade. const NEXT_DEFAULT = String.raw`[\w-]+-Google|Google-[\w-]+|Chrome-Lighthouse|Slurp|DuckDuckBot|baiduspider|yandex|sogou|bitlybot|tumblr|vkShare|quora link preview|redditbot|ia_archiver|Bingbot|BingPreview|applebot|facebookexternalhit|facebookcatalog|Twitterbot|LinkedInBot|Slackbot|Discordbot|WhatsApp|SkypeUriPreview|Yeti|googleweblight` const AI_CRAWLERS = 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User' const nextConfig: NextConfig = { htmlLimitedBots: new RegExp(NEXT_DEFAULT + '|' + AI_CRAWLERS, 'i'), } export default nextConfigقرّر هل تحتاج إلى التصدير الثابت
مع
output: 'export'، يكتب Next.js ملفات HTML إلىout/ويجب أن تكون معالجات المساراتforce-staticلتُولَّد مسبقًا. وهذا يناسب موقعًا تعريفيًا مستضافًا على تخزين بسيط.تحقق من نجاح الخطوةتحقق من نجاح الخطوة
في جدول المسارات الناتج عن
next build، ينبغي أن تظهر مسارات المحتوى ثابتة أو SSG، وليس ديناميكية. ثم اجلب/robots.txtو/sitemap.xmlو/llms.txt(ويُفترض أن يعيد الأخيرtext/plain; charset=utf-8) وشغّلcheck-ai-crawl.shعلى مقال واحد. وينبغي أن يعيد معرّف مجهول الحالة 404.
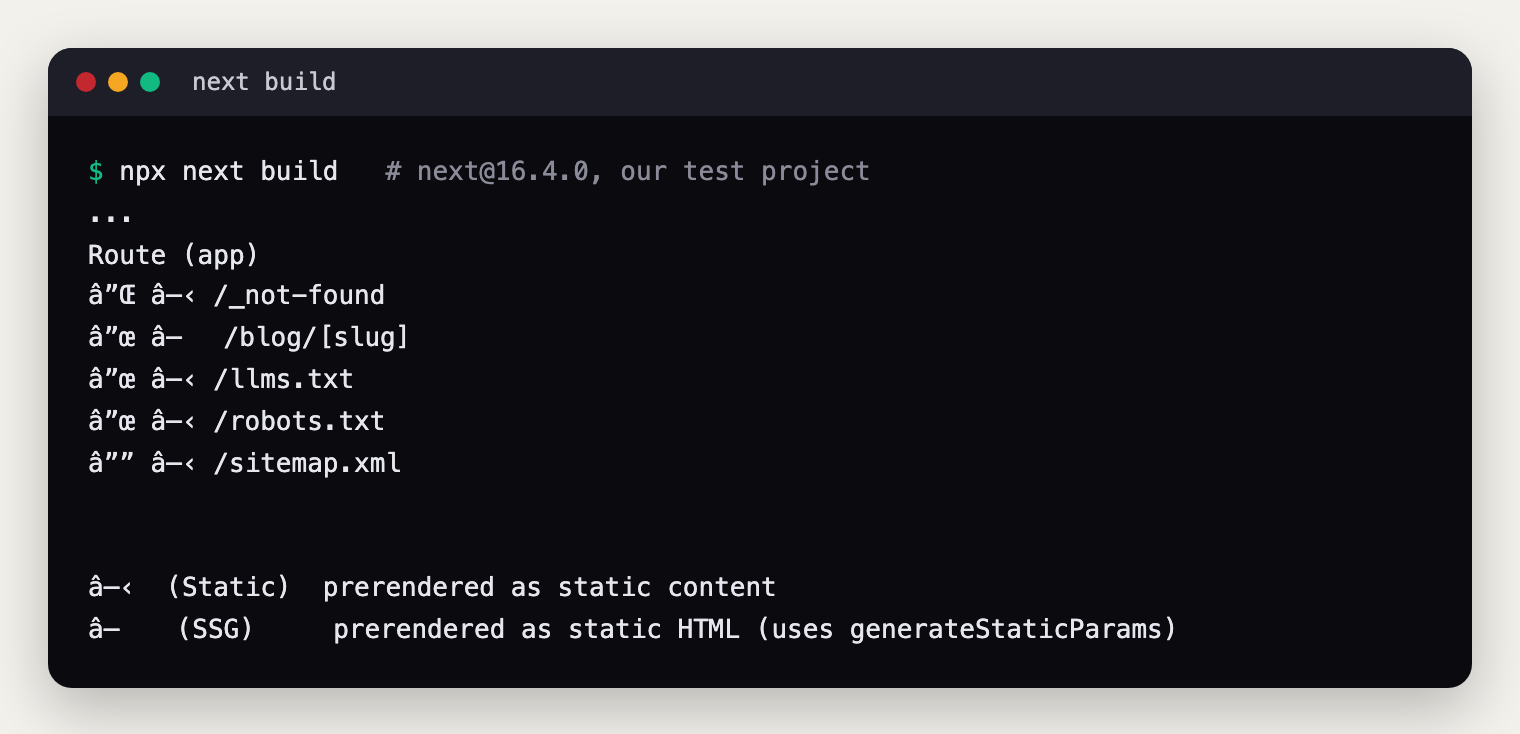
فتح بالحجم الكامل (في علامة تبويب جديدة)
بيانات App Router الوصفية وJSON-LD
generateMetadata وgenerateStaticParams ووسم script أصلي لJSON-LD.
Next.js
robots وsitemap وllms.txt
robots.ts مع تكرار قواعد المنع. وملفا مساري sitemap وllms.txt في المجلد نفسه.
Next.js
next.config.ts
htmlLimitedBots مع إضافة زواحف الذكاء الاصطناعي.
Next.js
Astro SEO وllms.txt
Astro هو الأسهل بين الثلاثة، لأن الصفحات ونقاط النهاية تُولَّد مسبقًا وقت البناء افتراضيًا. ومعظم العمل هو تجنب الأخطاء.
الخطواتأضف ملفات مقروءة للذكاء الاصطناعي إلى موقع Astro
أبقِ نص الإجابة خارج client:only
المكوّنات التي لا تحمل توجيه
client:*تُعرض كHTML عادي. أماclient:onlyفهو يتخطى العرض على الخادم كليًا، فلا تضع نص الإجابة في مكوّن كهذا أبدًا.أضف مكوّن JSON-LD يهرّب المدخلات
لا يهرّب Astro قيمة
set:html، ويتركJSON.stringifyالوسم</script>كما هو. وفي اختبارنا على Astro 7.0.5، أنهى وصف يحتوي على</script>الكتلة مبكرًا وفشل تحليل JSON. وأصلح تهريب<المشكلة. ولا يعالج Astro وسم script الذي له سمات غيرsrc، فتُخرج الكتلة كما كُتبت.src/components/JsonLd.astro --- interface Props { data: Record<string, unknown>; } const { data } = Astro.props; const json = JSON.stringify(data).replace(/</g, '\u003c'); --- <script type="application/ld+json" set:html={json} />ولِّد llms.txt من مجموعة المحتوى
تبني نقطة نهاية ملف ثابتة في
src/pages/llms.txt.tsالعنوان/llms.txtوقت البناء. والقراءة منgetCollection()تعني أنه لا يمكن أن ينحرف عن الصفحات المنشورة.src/pages/llms.txt.ts import type { APIRoute } from 'astro'; import { getCollection } from 'astro:content'; export const GET: APIRoute = async ({ site }) => { const url = (path: string) => new URL(path, site).href; const posts = (await getCollection('blog', ({ data }) => !data.draft)).sort( (a, b) => b.data.publishDate.getTime() - a.data.publishDate.getTime(), ); const body = [ '# Example Co', '', '> One or two sentences: what you do, for whom, and where.', '', '## Guides', ...posts.map((p) => '- [' + p.data.title + '](' + url('/blog/' + p.id) + '): ' + p.data.description), '', ].join('\n'); return new Response(body, { headers: { 'Content-Type': 'text/plain; charset=utf-8' } }); };اختر مصدرًا واحدًا لrobots.txt
استخدم
public/robots.txtأو نقطة نهاية، وليس كليهما. يمكن لنقطة النهاية إعادة استخدامsiteوتكرار القواعد في مجموعة الذكاء الاصطناعي، كما تبيّن وثائق تكامل خريطة الموقع لخرائط المواقع.src/pages/robots.txt.tsاستخدم هذا أو public/robots.txt import type { APIRoute } from 'astro'; const AI_AGENTS = [ 'OAI-SearchBot', 'ChatGPT-User', 'Claude-SearchBot', 'Claude-User', 'PerplexityBot', 'Perplexity-User', 'GPTBot', 'ClaudeBot', 'Google-Extended', ]; export const GET: APIRoute = ({ site }) => { const sitemapURL = new URL('sitemap-index.xml', site); const rules = 'Allow: /\nDisallow: /api/'; return new Response( [ 'User-agent: *\n' + rules, // A crawler that matches a named group ignores the * group, so repeat the rules. AI_AGENTS.map((ua) => 'User-agent: ' + ua).join('\n') + '\n' + rules, 'Sitemap: ' + sitemapURL.href, '', ].join('\n\n'), ); };اضبط lastmod في خريطة الموقع من frontmatter، لملفات .md و.mdx
يحتاج
@astrojs/sitemapإلى الخيارsiteولا يستطيع سرد المسارات الديناميكية المعروضة على الخادم (SSR). استخدمserialize()لضبطlastmodمن كل مقال. وطابق الامتدادين معًا، وإلا فإن تحويل مقال إلى MDX يُسقط تاريخه بصمت. اكتشفنا هذا في موقعنا نحن.astro.config.mjs import { defineConfig } from 'astro/config'; import sitemap from '@astrojs/sitemap'; import { readdirSync, readFileSync } from 'node:fs'; const postDates = Object.fromEntries( readdirSync('./src/content/blog') .filter((f) => /\.mdx?$/.test(f)) .map((f) => { const fm = readFileSync('./src/content/blog/' + f, 'utf8').split('---')[1] ?? ''; const date = fm.match(/^updatedDate:\s*(\S+)/m)?.[1] ?? fm.match(/^publishDate:\s*(\S+)/m)?.[1]; return ['/blog/' + f.replace(/\.mdx?$/, ''), date]; }), ); export default defineConfig({ site: 'https://www.example.com', integrations: [ sitemap({ serialize(item) { const path = new URL(item.url).pathname.replace(/\/$/, ''); const date = postDates[path]; if (date) item.lastmod = new Date(date).toISOString(); return item; }, }), ], });اربط الملف ليجده الوكلاء
أضف
link rel="alternate" type="text/plain" href="/llms.txt"أو رابطًا في التذييل. وتستخدم مواصفة llms.txt v2 القيمةrel="describedby"لهذا الغرض.تحقق من نجاح الخطوةتحقق من نجاح الخطوة
نفّذ
npx astro build. وافتحdist/llms.txtوdist/robots.txtوdist/sitemap-0.xmlوملفًا واحدًا هوdist/blog/your-post/index.html. وبعد النشر، شغّلcheck-ai-crawl.shعلى العنوان الحي وابحث عن «Phrase in raw HTML: YES».
JsonLd.astro
مكوّن JSON-LD يهرّب علامة الأصغر من.
Astro
نقطة نهاية llms.txt
يبني llms.txt من مجموعة المحتوى.
Astro
نقطة نهاية robots.txt
يكرر القواعد داخل مجموعة الذكاء الاصطناعي.
Astro
مُسلسِل خريطة الموقع
يضبط lastmod من frontmatter لملفات .md و.mdx.
Astro
maxenius.com مثالًا حيًا على Astro
بُني هذا الموقع كما تصف الخطوات أعلاه، ويمكنك فحصه.
- تبني الملفات
src/lib/llms.tsوsrc/pages/llms.txt.tsوsrc/pages/llms-full.txt.tsالملفين /llms.txt و/llms-full.txt من البيانات نفسها التي تقوم عليها الصفحات. - يكرر
public/robots.txtقواعده داخل مجموعة زواحف الذكاء الاصطناعي المسماة. وهذه سياسة أقصى ظهور: ترحّب بكل زاحف مذكور، بما فيها زواحف التدريب. اختر سياستك بتأنٍّ، كما في أساس robots.txt. - يُخرج
Seo.astroوsrc/lib/seo.tsوسم robots meta بقيمةmax-snippet:-1، وlink rel="alternate" type="text/plain"إلى/llms.txt، ومخطط JSON-LD يضم Organization وWebSite وWebPage وArticle وFAQPage وBreadcrumbList. - يستخدم
astro.config.mjsمخرجات ثابتة ويأخذlastmodفي خريطة الموقع من frontmatter كل مقال.
مهما اخترت، يبقى HTML الخادم هو الأساس. أما الملفات والترميز في هذا القسم فمكمّلات فوقه.
القياس والاختبار
تحتاج إلى خمسة مصادر، لأن أيًّا منها لا يغطي كل شيء: Search Console لGoogle، وGA4 أو Plausible للنقرات، وBing Webmaster Tools لاستشهادات Copilot، وسجلات الخادم للزواحف، واختبارات المطالبات لمعرفة ما تقوله الإجابات. يجيب كل مصدر عن سؤال مختلف وله نقاط عمياء، فاقرأها معًا.
أين يُبلغ كل مصدر
| المصدر | ما يُظهره | ما لا يُظهره |
|---|---|---|
| أداء Search Console | نقرات ومرات ظهور AI Overviews ووضع الذكاء الاصطناعي، محتسبة ضمن نوع البحث Web. وتُحتسب النقرة على رابط خارجي في أي من الميزتين. | تتشارك كل الروابط في AI Overviews موضعًا واحدًا، فقد تُظهر الصفحة المستشهَد بها موضعًا جيدًا ونسبة نقر ضئيلة. ويُحتسب سؤال المتابعة في وضع الذكاء الاصطناعي استعلامًا جديدًا. وتُستبعد تجارب Search Labs. وتؤكد صفحة ميزات الذكاء الاصطناعي لدى Google نوع Web. |
| تقرير Generative AI في Search Console | مرات الظهور في AI Overviews ووضع الذكاء الاصطناعي حسب الصفحة والدولة والجهاز والتاريخ. أُعلن في 3 يونيو 2026؛ ومتاح لكل المواقع منذ 31 أغسطس 2026. | لا نقرات ولا نسبة نقر ولا موضع ولا استعلامات. وقد لا يظهر إذا كان لموقعك مرات ظهور قليلة جدًا في الذكاء الاصطناعي. وهو مجموعة جزئية من بيانات Web، فلا تجمعه إلى تقرير الأداء. |
| AI Performance في Bing Webmaster Tools | معاينة عامة منذ 10 فبراير 2026: إجمالي الاستشهادات، ومتوسط الصفحات المستشهَد بها، واستعلامات التأريض (عيّنة)، ونشاط الاستشهاد على مستوى الصفحة. ومنذ 16 يونيو 2026: النوايا والمواضيع وحصة الاستشهاد والمقارنة، في المعاينة. | الاستشهاد ليس نقرة ولا زيارة. والبيانات عيّنة، واستعلامات التأريض عبارات مجمّعة وليست مطالبات حقيقية. ولا تكشف حصة الاستشهاد نطاقات المنافسين. |
| GA4 وPlausible | الزيارات التي لها مُحيل أو UTM. وفي GA4 قناة افتراضية باسم AI Assistant منذ 13 مايو 2026. وفي Plausible قناة AI Assistants. | قناة GA4 تستثني AI Overviews ووضع الذكاء الاصطناعي، وهما يُحتسبان ضمن البحث العضوي. وتوثّق OpenAI فقط utm_source=chatgpt.com، فتعتمد المساعدات الأخرى على المُحيلات. |
| سجلات الخادم | كل طلب من زاحف، بما في ذلك عمليات الجلب التي يطلقها المستخدم ولا تنفّذ JavaScript. | من قرأ الإجابة أو نقر. ويحتاج إلى فحص عناوين IP، لأن وكلاء المستخدم يمكن انتحالهم. |
| اختبارات المطالبات | ما يقوله كل محرك عنك اليوم فعلًا. | ترتيب ثابت. تقول Google إن AI Overviews ووضع الذكاء الاصطناعي قد يستخدمان نماذج مختلفة ويغيّران روابطهما، لذلك تضلّل التشغيلات المفردة. |
أعدّ القياس خطوة بخطوة
الخطواتقِس ظهورك في البحث بالذكاء الاصطناعي
افصل مرات الظهور عن ميزات الذكاء الاصطناعي
ابدأ من هنا في أي صفحة لها مرات ظهور عالية ونقرات تكاد تكون معدومة.
- في Search Console، افتح Performance، وصفِّ Page على عنوانك، ودوّن مرات الظهور والنقرات ونسبة النقر ومتوسط الموضع.
- افتح تقرير أداء الذكاء الاصطناعي التوليدي، وانتقل إلى تبويب Pages، وابحث عن العنوان نفسه.
- قارن عددي مرات الظهور. تقرير الذكاء الاصطناعي مجموعة جزئية من Web، فلا تجمعهما أبدًا. وإذا كانت ميزات الذكاء الاصطناعي تمثل معظم مرات الظهور، فالموضع الجيد مع نسبة نقر منخفضة متوقع، لأن كل الروابط في AI Overviews تتشارك موضعًا واحدًا.
- إذا كان التقرير غائبًا، فتقول Google إن الموقع لم تكن له مرات ظهور كافية في الذكاء الاصطناعي بعد. هذا ليس خطأ.
- افتح Settings > Search generative AI وتأكد من أن الموقع غير مضبوط على Exclude وأنه لا يرث Exclude من موقع أب. راجع التحكم في Search generative AI.
- أضف تعليقًا توضيحيًا (annotation) في يوم نشر تغييراتك: انقر بزر الفأرة الأيمن على مخطط Performance، بحد أقصى 120 حرفًا (مساعدة التعليقات التوضيحية).
استخدم قناة AI Assistant المدمجة
في GA4، انتقل إلى Reports > Acquisition > Traffic acquisition. اضبط البُعد الأساسي على Session default channel group وابحث عن صف AI Assistant. وأضف Session source بُعدًا ثانويًا لترى أي مساعد أرسل كل جلسة. ولن تجد هنا نقرات AI Overviews ووضع الذكاء الاصطناعي. وفي Plausible، افتح Sources > Channels > AI Assistants.
أضف مجموعة قنوات مخصصة
انتقل إلى Admin > Data display > Channel groups، وأنشئ مجموعة، وأضف قناة يطابق فيها Source التعبير النمطي أدناه. اسحبها فوق Referral، لأن الزيارات تذهب إلى أول قناة تطابقها. تسمح الخصائص القياسية بمجموعتين مخصصتين، والمجموعات المخصصة ليست في تصدير BigQuery.
تجاوز التعبير النمطي النموذجي في مقال مساعدة Google هذا النطاق في اختبارنا: فقد التقط help.openai.com وgithub.com/copilot وchatgptlist.org و«shanghai» أيضًا. استخدم هذا الأضيق بدلًا منه.
ga4-ai-sources.regex111 حرفًا، مثبّت بالأطراف ^(.*\.)?(chatgpt\.com|chat\.openai\.com|perplexity\.ai|claude\.ai|copilot\.microsoft\.com|gemini\.google\.com)$يقبل chatgpt.com وchat.openai.com وwww.perplexity.ai وclaude.ai وcopilot.microsoft.com وgemini.google.com. ويرفض google وmail.google.com وopenai.com وhelp.openai.com وnotchatgpt.com وperplexity.ai.evil.com وbing.com. ويغطي مضيف www والمضيف القديم لChatGPT لأن chat.openai.com يعيد التوجيه إلى chatgpt.com وperplexity.ai يعيد التوجيه إلى www.perplexity.ai. والتعبيرات النمطية في GA4 مطابقة كاملة وحساسة لحالة الأحرف افتراضيًا، وتستخدم RE2، وتُحدّ مرشحات التقارير ب250 حرفًا. وتُبقي الأوتاد هذا النمط صحيحًا في وضعي المطابقة. أضف مساعدات أخرى فقط بعد أن تظهر في تقرير Session source لديك.
انتبه إلى معاملات UTM الضائعة
ابحث في Session source / medium عن صفوف chatgpt.com الواقعة في Unassigned أو Referral، لأن Google لا توثّق كيف يحسم GA4 قيمة utm_source بلا medium مقابل قاعدة AI Assistant. كما أن إعادة التوجيه التي تُسقط سلسلة الاستعلام، كقاعدة الشرطة المائلة الختامية أو www أو http إلى https، تُسقط UTM أيضًا. اختبر عنوانًا موسومًا عبر كل إعادة توجيه تستخدمها.
ابنِ استكشافًا (Exploration) (اختياري)
تخطَّ هذا إذا كان تقرير القناة المدمج يجيب عن سؤالك. في Explore، ابدأ استكشافًا فارغًا. استورد الأبعاد Session source وSession source / medium وLanding page + query string وSession default channel group، إضافةً إلى المقاييس Sessions وEngaged sessions وKey events. ضع Session source ثم Landing page + query string في Rows، وصفِّ Session source بالتعبير النمطي نفسه.
اقرأ استشهادات Copilot وBing
- وثّق ملكية الموقع في Bing Webmaster Tools وافتح تقرير AI Performance.
- اقرأ Total Citations وAverage Cited Pages واستعلامات التأريض وقائمة Pages. انقر على استعلام تأريض لترى صفحاته المستشهَد بها، أو على صفحة لترى استعلامات التأريض الخاصة بها.
- استخدم Compare لتراكب الفترة التالية لنشر تغييراتك. النوايا والمواضيع وحصة الاستشهاد ميزات معاينة.
- صدّر CSV أو Excel شهريًا. واقرأ الأسئلة الشائعة لمعرفة قواعد أخذ العينات والتحديث.
- أرسل العناوين المتغيرة عبر IndexNow. وتوصي Bing به لتستخدم إجابات الذكاء الاصطناعي النسخة الحالية من الصفحة.
عُدّ زيارات زواحف الذكاء الاصطناعي في سجلات الخادم
ابحث عن وكلاء المستخدم هؤلاء. البحث: OAI-SearchBot وClaude-SearchBot وPerplexityBot وGooglebot وbingbot. التدريب: GPTBot وClaudeBot. ما يطلقه المستخدم: ChatGPT-User وClaude-User وPerplexity-User. ولن يظهر Google-Extended أبدًا، لأنه رمز في robots.txt وليس له وكيل مستخدم خاص به.
الزيارات التي يطلقها المستخدم هي الأهم. فكل واحدة تعني أن محادثة حقيقية قرأت صفحتك، ولأن هذه العمليات لا تنفّذ JavaScript، فإن GA4 وPlausible لا يريانها أبدًا.
عدّ سريع من سجل بالصيغة المجمّعة. تعدّ نسخة awk هذه كل سطر مرة واحدة، بينما كان grep العادي يعدّ bingbot مرتين في كل سطر:
terminalيعدّ كل سطر مرة واحدة awk 'match($0, /OAI-SearchBot|ChatGPT-User|GPTBot|Claude-SearchBot|Claude-User|ClaudeBot|PerplexityBot|Perplexity-User|Googlebot|bingbot/) { print substr($0, RSTART, RLENGTH), $7 }' access.log | sort | uniq -c | sort -rnوكلاء المستخدم سهلو الانتحال، فتحقق من عناوين IP. سكربتنا
ai_bot_report.py(Python 3، بالمكتبة القياسية فقط، وهو في الحزمة) يعدّ الزيارات حسب اليوم والزاحف والحالة والمسار، ويفحص كل عنوان IP مقابل القائمة المنشورة من المشغّل لدى OpenAI وAnthropic وPerplexity وGoogle وBing. والصف الذي فيهip_verified=NOوكيل مستخدم منتحل. وهو يرصد GPTBot مزيفًا من عنوان IP غير مدرج.terminal python3 ai_bot_report.py access.log > ai-bots.csv zcat access.log.*.gz | python3 ai_bot_report.py - > ai-bots.csvوبدون السكربت، استخدم البحث المزدوج: يجب أن يعيد البحث العكسي في DNS عن عنوان IP اسم مضيف تابعًا لGoogle (googlebot.com أو google.com أو googleusercontent.com) أو اسمًا ينتهي بsearch.msn.com لBingbot، ويجب أن يعيد البحث الأمامي عن ذلك الاسم عنوان IP نفسه.
على Vercel، انتقل إلى Firewall > Rules > Bot Management واضبط مجموعة قواعد AI Bots على Log، وليس Deny (مجموعات قواعد WAF المُدارة). ثم استخدم Firewall > Traffic وجمّع حسب User Agents وRequest Paths (المراقبة). وتُظهر سجلات وقت التشغيل الطلبات الثابتة المقدّمة من الذاكرة المؤقتة فقط. والسجل الكامل يتطلب Drains، وهي في خطتي Pro وEnterprise، مع
proxy.userAgentفي كل سجل:vercel-drain-bots.shيحتاج إلى jq jq -r 'select(.proxy) | [(.proxy.timestamp/1000|todate), .proxy.clientIp, .proxy.path, (.proxy.statusCode|tostring), (.proxy.userAgent|join(" "))] | @tsv' drain.ndjson \ | awk -F'\t' 'match($5, /OAI-SearchBot|ChatGPT-User|GPTBot|Claude-SearchBot|Claude-User|ClaudeBot|PerplexityBot|Perplexity-User|Googlebot|bingbot/) { print substr($5, RSTART, RLENGTH) "\t" $3 }' \ | sort | uniq -c | sort -rnعلى Cloudflare، افتح AI Crawl Control. وإذا كانت زيارات زواحف الذكاء الاصطناعي قريبة من الصفر، فتحقق هل يضيف إعداد robots.txt المُدار قواعد Disallow في البداية لGPTBot أو ClaudeBot أو Google-Extended.
نفّذ اختبار مطالبات قابلًا للتكرار
لا توجد أداة رسمية تعرض استشهادات ChatGPT أو Claude أو Perplexity، لذلك اختبر يدويًا ببروتوكول ثابت.
- اكتب من 20 إلى 40 مطالبة تشمل أسئلة كيفية وأخرى مقارنة وأخرى خاصة بالمنصات وسؤالين أو ثلاثة عن العلامة التجارية. أعطِ كلًا منها معرّفًا دائمًا. ولتغيير الصياغة، أوقف المعرّف وأضف معرّفًا جديدًا.
- المحركات: ChatGPT مع تفعيل البحث، وGoogle AI Mode، وGoogle AI Overviews (بحث عادي)، وGemini، وPerplexity، وMicrosoft Copilot، وClaude مع تفعيل البحث في الويب.
- ثبّت الإعدادات: الدولة واللغة وحالة تسجيل الدخول. في ChatGPT استخدم Temporary chat مضبوطة على Unpersonalized، وهي تتجاوز الذاكرة والتعليمات المخصصة. أما وضع Personalized فقد يستخدم ذكريات موجودة. وفي غيرها، استخدم ملفًا جديدًا أو جلسة دون تسجيل دخول ودوّن الوضع أو النموذج.
- شغّل كل مطالبة 3 مرات لكل محرك. تتفاوت الإجابات بين التشغيلات.
- الوتيرة: خط أساس شهري، وإعادة تشغيل واحدة بعد 2 إلى 4 أسابيع من أي تغيير كبير في المحتوى.
- سجّل كل تشغيل في
ai-prompt-tracker.csv(26 عمودًا، وصفان نموذجيان موسومان بوضوح). واحسب معدل الذكر ومعدل الاستشهاد وحصة الاستشهاد (عناوينك المستشهَد بها مقسومة على كل العناوين المستشهَد بها، وهي الفكرة نفسها في مقياس Bing). - احتفظ بلقطات الشاشة دليلًا خاصًا. ولا تنشر واجهات أطراف ثالثة.
Google Sheets or Excelالبيانات في ورقة باسم runs Mention rate =COUNTIF(runs!N2:N1000,"yes")/COUNTA(runs!C2:C1000) Citation rate =COUNTIF(runs!P2:P1000,"yes")/COUNTA(runs!C2:C1000) Citation share =SUM(runs!R2:R1000)/SUM(runs!S2:S1000)تحقق من نجاح الخطوةتحقق من نجاح الخطوة
تأكد من أربعة أمور:
- لديك رقم «قبل» للعنوان (إجمالي مرات الظهور ومرات الظهور في ميزات الذكاء الاصطناعي) وتعليق توضيحي بتاريخ يوم النشر.
- يعيد مرشّح GA4 مضيفات المساعدات فقط.
- تُظهر مخرجات الزواحف طلباتك أنت. أنشئ طلبًا ب
curl -A 'OAI-SearchBot' -s -o /dev/null https://yourdomain.com/robots.txt، ثم ابحث عن صف فيه اسم الزاحف والحالة 200. - يحتوي متتبع المطالبات على صف خط أساس لكل معرّف مطالبة ولكل محرك.
إذا كنت تفضل أن نُعدّ القياس ونقرأه نيابةً عنك، فراجع خدمات AI SEO لدينا.
أدوات الأطراف الثالثة
يتتبع Brand Radar من Ahrefs الذكر والاستشهادات عبر AI Overviews ووضع الذكاء الاصطناعي وChatGPT وGemini وPerplexity وCopilot، باستخدام فهرس مطالبات تقول Ahrefs إنه مبني على بيانات البحث، إضافةً إلى مطالبات مخصصة تختارها. وتقدّم مجموعة Semrush AI Visibility Toolkit درجة ظهور وأبحاث مطالبات وتتبعًا يوميًا للمطالبات. ويعرض Cloudflare AI Crawl Control نشاط الزواحف للمواقع خلف Cloudflare. وتأخذ هذه الأدوات عينات من المطالبات ولا تقرأ محادثات المستخدمين الفعلية، وتقول Google إن لا أداة من طرف ثالث لديها وصول إلى أنظمة ترتيب الذكاء الاصطناعي لديها. اعتبر أرقامها اتجاهية وقارنها ببياناتك الأصلية.
قائمة التدقيق الذاتي
اعمل على هذه القائمة في موقعك. يرتبط كل بند بالقسم الذي يشرحه. ويُحفظ تقدمك في هذا المتصفح فقط، فلن ينتقل معك إلى جهاز آخر.
التدقيق الذاتي لGEO
اكتمل 0 من 33
حزمة بداية GEO
كل ما يمكنك نسخه من هذا الدليل موجود في تنزيل مجاني واحد، دون تسجيل ودون نموذج بريد إلكتروني.
نزّل حزمة بداية GEO الكاملة
53 ملفًا في أرشيف واحد: robots.txt وllms.txt وJSON-LD وIndexNow وWordPress وShopify وNext.js وReact وAstro وسكربتات ومتتبع مطالبات وموجز محتوى.
Any
قائمة التدقيق الذاتي للطباعة
القائمة أعلاه في صفحتين بحجم A4، جاهزة للطباعة أو الحفظ.
Any
متتبع المطالبات
المتتبع ذو الأعمدة البالغ عددها 26. والصيغ وبروتوكول الاختبار في المجلد نفسه.
Any
قالب موجز المحتوى
موجز محتوى يبدأ بالإجابة.
Any
سكربت تقرير الزواحف
يعدّ زيارات زواحف الذكاء الاصطناعي من سجل ويفحص كل عنوان IP مقابل النطاقات المنشورة.
Any
التعبير النمطي لمصادر الذكاء الاصطناعي في GA4
التعبير النمطي الأضيق لمجموعة قنوات مخصصة.
Any
مقتطف HTML لhead
وسم robots meta وترميز data-nosnippet.
Any
إشعار IndexNow
أمر إشعار دفعي، مع مثال على ملف المفتاح في المجلد نفسه.
Any
ملفات المنصات مرتبطة في كل قسم منصة أعلاه. وكل ملف يستخدم قيمًا افتراضية مثل example.com ومفاتيح ونماذج أسماء. استبدل كل واحدة منها قبل النشر، ونفّذ خطوة التحقق من القسم المطابق.
الخطوات التالية
ابدأ بقائمة التدقيق الذاتي أعلاه وأصلح أول بند يفشل، وهو عادةً وصول الزواحف أو HTML الخادم. وإذا كنت تفضل أن يُنجَز العمل ويُتحقق منه في موقعك، فإن Maxenius تنفّذ تدقيقات AI SEO وGEO وأعمال التطبيق. نفحص وصول الزواحف والعرض والبيانات المنظمة والقياس وفق خطوات هذا الدليل، ونبلّغ بما تغيّر مع الأدلة. ولا يستطيع أحد ضمان استشهادات الذكاء الاصطناعي، لذلك لا نقدّم ذلك.
احجز تدقيق البحث بالذكاء الاصطناعيوإذا كان العمل بناءً، فنحن ننفّذ أيضًا تطوير Shopify وتطوير WordPress وتطوير البرمجيات حسب الطلب. وثائق المزوّدين تتغير كثيرًا. أعد فحص المصادر أدناه شهريًا.
المصادر والتواريخ
جميعها فُتحت وتم التحقق منها في 7 أكتوبر 2026.
- Google Search Console Help، What are impressions, position, and clicks
- Google Search Console Help، Generative AI performance report
- Google Search Console Help، Search generative AI control
- Google Search Console Help، Search Console annotations
- Google Search Central Blog، Introducing Search Generative AI performance reports
- Google Search Central، AI features and your website
- Google، Google’s common crawlers
- Google، Verify requests from Google crawlers and fetchers
- Google Analytics Help، What’s new in Google Analytics، Default channel group، Custom channel groups، About regular expressions
- Microsoft Bing Webmaster Blog، Introducing AI Performance in Bing Webmaster Tools Public Preview
- Microsoft Bing Webmaster Tools Help، AI Performance FAQ
- Microsoft Bing Search Blog، New AI Visibility Insights in Bing Webmaster Tools
- OpenAI، Overview of OpenAI Crawlers
- OpenAI Help Center، Publishers and Developers FAQ، Temporary chat
- Anthropic، Does Anthropic crawl data from the web
- Perplexity، Perplexity Crawlers
- IndexNow.org، Documentation and FAQ
- Vercel، WAF Managed Rulesets، Firewall Observability، Runtime Logs
- Cloudflare، Managed robots.txt
- Plausible، Top referrers
- Ahrefs، Brand Radar
- Semrush، AI Visibility Toolkit